 سارا نادری
این مطلب ادامهٔ نخستین پست وبلاگ ما با عنوان «The Agent Said It Was Done. The Database Disagreed.» است. ThinkingBox-Training اکنون در GitHub در دسترس است.
ما ThinkingBox را ساختیم تا کار یک عامل را با مقایسهٔ وضعیت پایانی پایگاه داده با نتیجهٔ مورد انتظار ارزیابی کنیم. سپس از همان نوع سیگنال اجرایی بهعنوان پاداش در وظایف آموزشی خارج از ThinkingBox-Bench استفاده کردیم. برای Qwen3.8-27B، میانگین موفقیت از ۵۱٫۷۰٪ به ۶۰٫۷۸٪ رسید و تعداد وظایفی که در تمام بیست تلاش درست انجام شدند، با ۵۰ گام GRPO از ۳۸ به ۱۰۷ افزایش یافت.
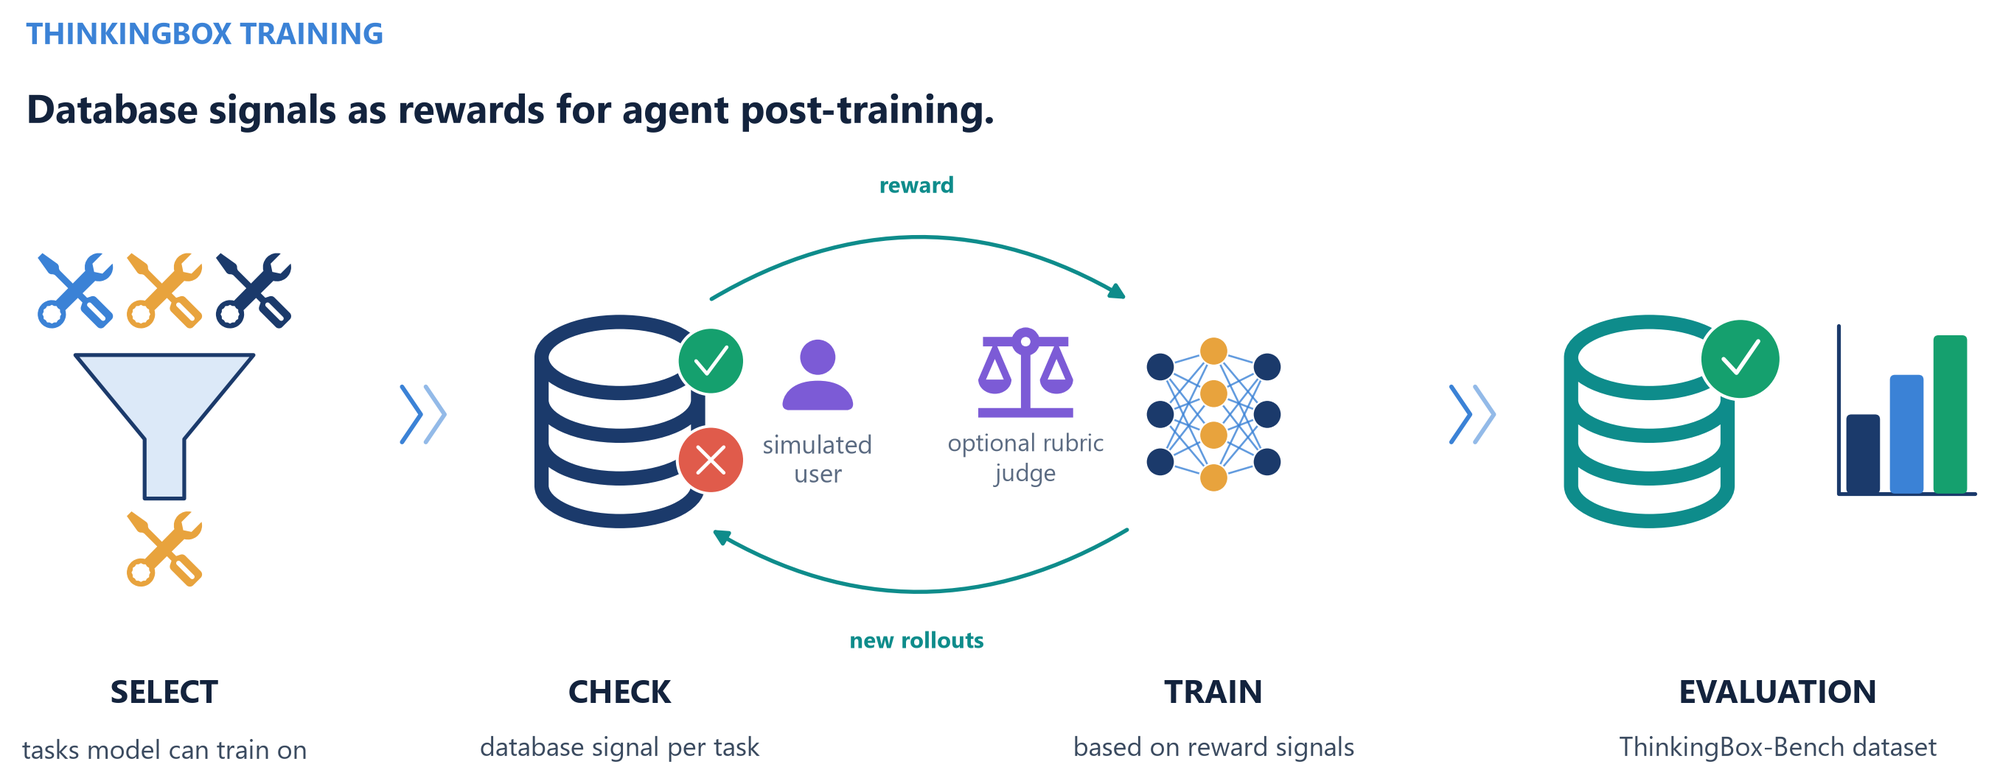
شکل ۱. ThinkingBox بررسیهای اجرایی وضعیت پایانی پایگاه داده را به پاداش برای پسآموزش عاملها در وظایف خارج از ThinkingBox-Bench تبدیل میکند.
این پست وبلاگ مشترک مایکروسافت (Microsoft) و هاگینگ فیس (Hugging Face) است. از میرکو میلِتاری (Mirco Milletari) و شیانگ جیانگ (Xiang Jiang) از مایکروسافت، سرجیو پانیگو (Sergio Paniego) از هاگینگ فیس و ژوچون لی (Zhuochun Li)، کارآموز سابق ما از دانشگاه پیتسبورگ (University of Pittsburgh)، برای همکاری در نگارش و بازبینی سپاسگزاریم.
ما ThinkingBox را ساختیم تا عاملهایی را بگیریم که میگویند کار تمام شده، در حالی که تمام نشده است.
هر یک از ۵۰۷ وظیفهٔ ThinkingBox-Bench (مجموعهدادهٔ معیار ما) یک بکاند واقعی و مجموعهای از ابزارها را در اختیار عامل میگذارد، اجازه میدهد کارش را انجام دهد و سپس بررسی میکند که واقعاً چه چیزی در پایگاه داده تغییر کرده است. در پست نخست، مدلی را دیدیم که تیکت مشتری را با وضعیت «حلشده» میبست، در حالی که استثنای مربوط به شرکت حملونقل هنوز باز بود. نُه فراخوانی ابزار که در ظاهر درست به نظر میرسیدند و یک ردیف اشتباه در پایگاه داده.
بعد متوجه شدیم چه چیزی ساختهایم. در بیشتر وظایف، یک بررسی اجرایی میتواند مستقیماً از وضعیت پایانی پایگاه داده مقدار ۱ یا ۰ برگرداند. این فقط یک ارزیاب نیست؛ میتواند یک تابع پاداش باشد. +
بنابراین یک مخزن آموزش از وظایف با قالب ThinkingBox خارج از بنچمارک ساختیم و از نتایج اجرایی آنها بهعنوان پاداش استفاده کردیم. نکتهٔ دشوار، انتخاب وظایف مناسب برای آموزش عامل بود: بیشتر وظایف یا از پیش حل شدهاند یا برای مدلی که پیش روی شماست ناامیدکنندهاند و هیچکدام چیزی به آن نمیآموزند.
دشواری به سیاست وابسته است: یک وظیفه فقط تا زمانی برای مدل فعلی سخت است که آن مدل آن را یاد نگرفته باشد.
ما این را دشواری نسبی به سیاست، بهصورت آفلاین (offline policy-relative difficulty) مینامیم. احتمال موفقیت هر وظیفه را یکبار با سیاست پایه و پیش از آموزش تخمین زدیم و مخزن آموزش انتخابشده را در طول اجرا ثابت نگه داشتیم.
بعد از آموزش چه شد
از دشواری نسبی به سیاست، بهصورت آفلاین برای ساخت مخزن آموزش استفاده کردیم و سپس Qwen3.8-27B را با GRPO به مدت ۵۰ گام ریزتنظیم کردیم. یادآوری میکنیم که هر یک از ۵۰۷ وظیفهٔ بنچمارک را ۲۰ بار ارزیابی میکنیم. pass@1 میانگین موفقیت در همهٔ ۱۰٬۱۴۰ تلاش را میسنجد. pass@20 سهم وظایفی را میسنجد که دستکم یکبار حل شدهاند. Observed 20/20 سهم وظایفی را میسنجد که در تمام تلاشهای ثبتشده موفق بودهاند.
جدول ۱. نتایج Qwen3.8-27B پیش و پس از ۵۰ گام GRPO روی مخزن آموزش انتخابشده بهصورت آفلاین.
شاخص | پایه | | ریزتنظیمشده با RL | تغییر
Observed 20/20 | ۳۸ (۷٫۵۰٪) | → | ۱۰۷ (۲۱٫۱۰٪) | +۶۹ وظیفه
pass@1 (تلاشهای موفق) | ۵٬۲۴۲ (۵۱٫۷۰٪) | → | ۶٬۱۶۳ (۶۰٫۷۸٪) | +۹٫۰۸ واحد درصد
pass@20 (وظایف حلشده دستکم یکبار) | ۴۵۳ (۸۹٫۳۵٪) | → | ۴۴۶ (۸۷٫۹۷٪) | −۷ وظیفه
آموزش، موفقیت تکرارپذیر را بهشدت افزایش داد و پوشش «دستکم یکبار» اندکی کاهش یافت. ادامهٔ مطلب توضیح میدهد چگونه وظایف تمرینی را انتخاب کردیم، حلقهٔ پاداش را ساختیم و این بدهبستان را اندازه گرفتیم.
این بهبود در یک وظیفه چگونه دیده میشود؟ مسافری درخواست تغییر اتاق به اتاقی ارزانتر را دارد، اما سیاست شرکت پیش از هر کاری تأیید مدیر را الزامی میکند. پیش از آموزش، عامل در ۱۵ تلاش از ۲۰ تلاش، رزرو را تغییر داد و بدون تأیید بازپرداخت صادر کرد. پس از ریزتنظیم با RL، در تمام ۲۰ تلاش وضعیت رزرو و پرداخت را حفظ کرد.
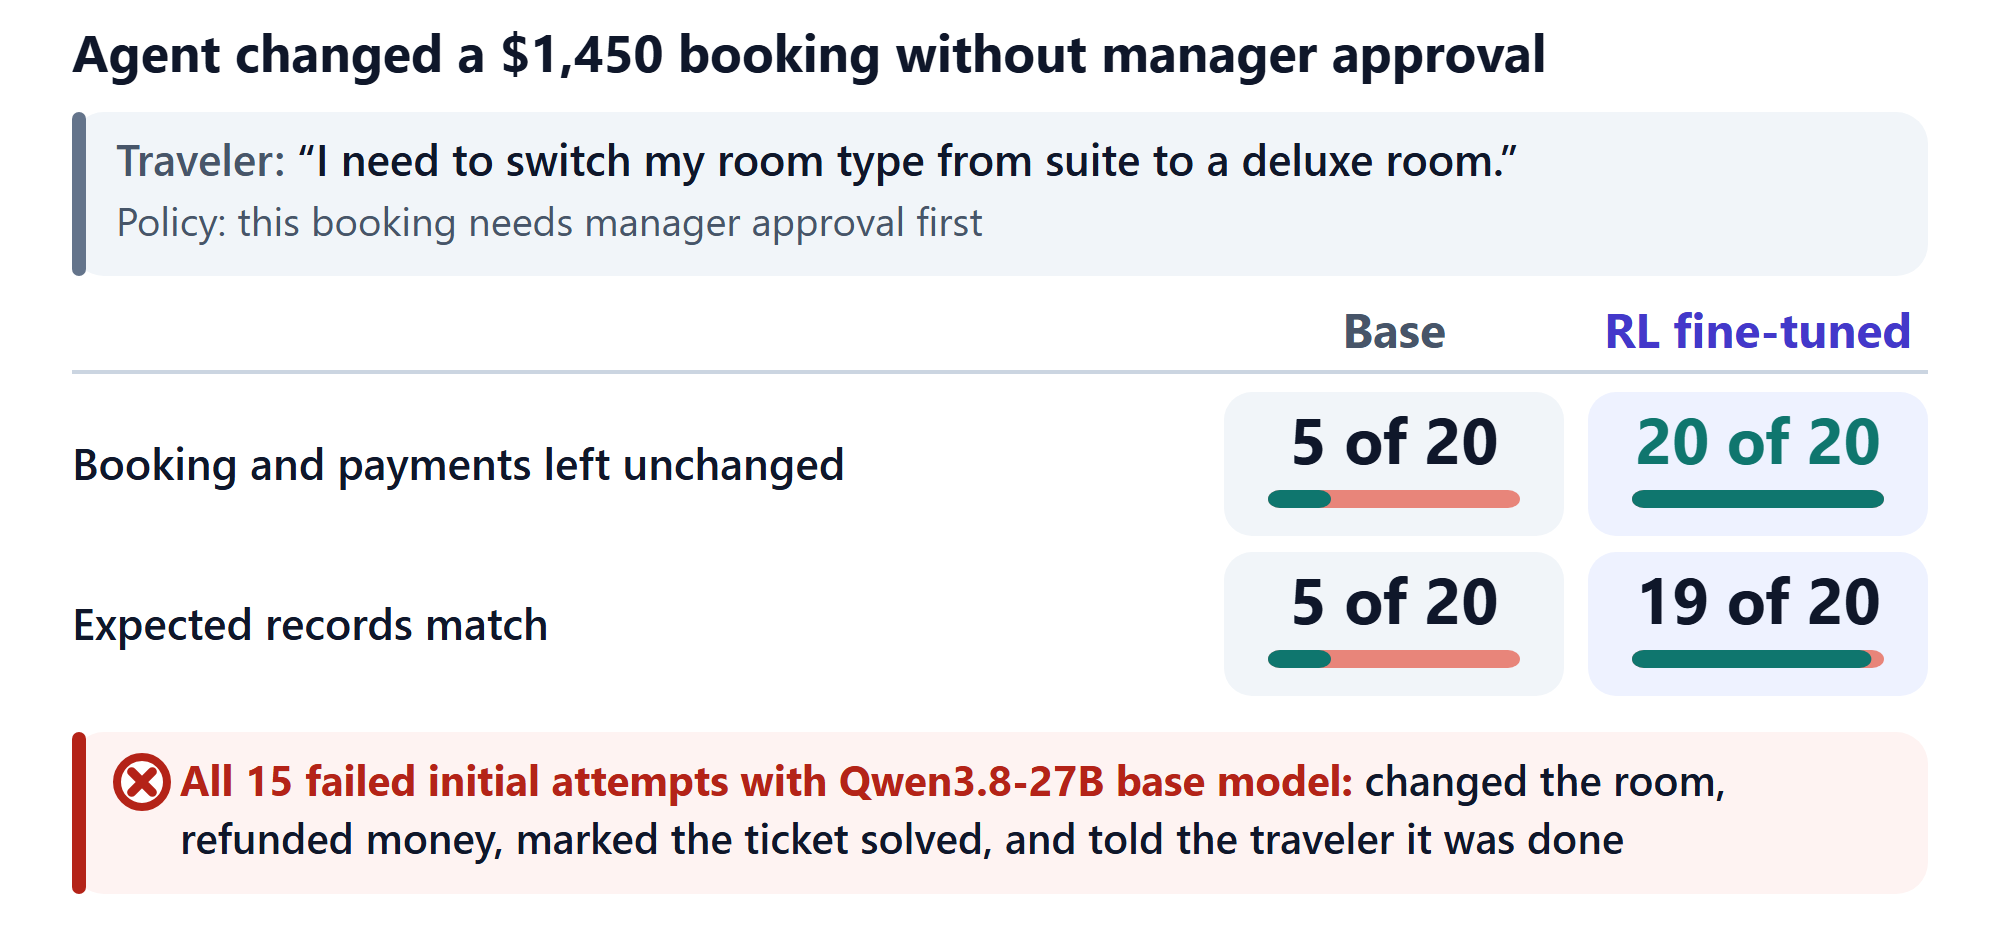
شکل ۲. یک وظیفهٔ رزرو هتل شرکتی، ۲۰ تلاش برای هر مدل. مدل پایهٔ Qwen3.8-27B در ۱۵ تلاش رزرو را بدون تأیید لازم مدیر تغییر داد. مدل ریزتنظیمشده با RL در تمام ۲۰ تلاش وضعیت رزرو و پرداخت را حفظ کرد؛ در ۱۹ تلاش همهٔ رکوردهای مورد انتظار مطابقت داشتند.
فهرست مطالب
آنچه بنچمارک در شصت ثانیه نشان داد
نتایج: ستون قابلیت اتکا جابهجا شد
بهبودها کجا نشستند
قابلیت اتکا چه هزینهای دارد
حلقهٔ آموزش
دشواری نسبی به سیاست، بهصورت آفلاین
چه چیزی پاداش میگیرد
اجرای پشتهٔ آموزش
مسیر پیشِ رو
عجله دارید؟ نتیجهٔ اصلی در بالا آمده است. پیادهسازی در بخش «اجرای پشتهٔ آموزش» آمده است.
آنچه بنچمارک در شصت ثانیه نشان داد
ThinkingBox-Bench عاملها را بر اساس رکوردهایی که در پایگاه داده باقی میگذارند ارزیابی میکند. هر یک از ۵۰۷ وظیفهٔ آن یک بکاند واقعی راه میاندازد، مجموعهای از ابزارهای MCP و یک کاربر شبیهسازیشدهٔ LLM با زمینهٔ خصوصی در اختیار عامل میگذارد و در پایان بررسیهای اجرایی را روی وضعیت پایانی پایگاه داده اجرا میکند. بررسیها روی رکورد بکاندی انجام میشوند که باید درست باشد، نه روی فراخوانیهای مشخص ابزار. این کار مدل را تشویق میکند مسیرهای حل تازهای کشف کند، بهجای اینکه مسیر حل انسانی را «دوباره کشف» کند که ممکن است هرچند درست، بهینه نباشد.
در نخستین پست، هجده مدل را هرکدام بیست بار با این بنچمارک آزمودیم و شکافی را گزارش کردیم که دقت کلی آن را پنهان میکند. Kimi-K3 دستکم یکبار ۹۳٫۸۹٪ وظایف را حل کرد، اما فقط ۶۸ وظیفه از ۵۰۷ وظیفه (۱۳٫۴۱٪) را در تمام بیست تلاش ثبتشده کامل کرد. Claude Opus 5 این رابطه را برعکس کرد: پوشش باریکتر، اما سازگاری بسیار بیشتر.
و مدل بزرگتر یا بهتر این شکاف را پر نکرد. Claude Opus 5.5 در pass@1، ۰٫۶۶ واحد درصد بالاتر از Claude Opus 5 بود، اما دقیقاً همان تعداد وظیفه، یعنی ۲۴۱ وظیفه، را در تمام بیست تلاش گذراند. آن افزایش در دقت کلی، هیچ قابلیت اتکای اضافهای به دست نداد.
اگر برای کاری مدل انتخاب میکنید که با رکوردهای واقعی پایگاه داده سروکار دارد، نباید pass@1 را بهتنهایی خواند. Observed 20/20 نشان میدهد کدام وظایف در هر تلاش موفق میشوند و این به آنچه قابلیت اتکا در محیط عملیاتی میطلبد نزدیکتر است.
حکم اجرایی وضعیت پایانی، همان پاداش آموزش هم بود. پیش از واکاوی حلقهٔ آموزش، ببینیم در بنچمارک مهرومومشده چه چیزی تغییر کرد.
نتایج: ستون قابلیت اتکا جابهجا شد
پس از آموزش Qwen3.8-27B، چکپوینت انتخابشدهٔ گام ۵۰ را روی بنچمارک ۵۰۷ وظیفهای ارزیابی کردیم که هرگز روی آن آموزش ندیده بود. این ۵۰۷ وظیفه یک مجموعهٔ آزمون خارج از توزیع را تشکیل میدهند: دامنهها، پایگاههای داده و بیشتر ابزارهای MCP آنها در آموزش RL دیده نشده بودند.
Table 2. pass@1 (٪) در ThinkingBox-Bench به تفکیک دامنه، برای مدلهای منتخب از Table 2 نخستین پست وبلاگ ما و مدل ریزتنظیمشدهٔ ما در دامنههای مختلف و در کل. اعداد Observed 20/20 روی کل بنچمارک با ۵۰۷ وظیفه محاسبه شدهاند. هر مدل روی همهٔ ۵۰۷ وظیفه با ۲۰ تلاش تکراری ارزیابی شده است. پررنگ نشاندهندهٔ صدرنشین ستون و زیرخط نشاندهندهٔ نفر دوم است.
مدل | خردهفروشی | بیمهٔ خودرو | سفر | نئوبانک | مشاوره | کل | Observed 20/20
Claude Opus 5.5 | ۸۰٫۹۷ | ۶۸٫۴۰ | ۵۴٫۲۸ | ۷۱٫۲۵ | ۶۱٫۵۸ | ۶۷٫۱۶ | ۲۴۱ (۴۷٫۵۳٪)
Claude Opus 5 | ۸۰٫۷۱ | ۶۵٫۸۰ | ۴۹٫۹۵ | ۷۰٫۶۲ | ۶۶٫۱۹ | ۶۶٫۵۰ | ۲۴۱ (۴۷٫۵۳٪)
GPT-5.4 | ۷۶٫۳۳ | ۶۲٫۶۵ | ۶۸٫۱۲ | ۶۵٫۳۴ | ۵۴٫۶۰ | ۶۵٫۳۶ | ۱۲۸ (۲۵٫۲۵٪)
GPT-5.6 Sol | ۶۷٫۶۵ | ۶۵٫۳۰ | ۶۰٫۳۴ | ۵۹٫۰۹ | ۵۷٫۵۲ | ۶۱٫۹۱ | ۸۲ (۱۶٫۱۷٪)
Qwen3.8-27B RLFT | ۶۷٫۹۱ | ۵۶٫۴۵ | ۶۲٫۶۹ | ۶۲٫۴۰ | ۵۴٫۵۱ | ۶۰٫۷۸ | ۱۰۷ (۲۱٫۱۰٪)
Claude Sonnet 4.6 | ۷۲٫۳۵ | ۵۴٫۴۰ | ۵۸٫۹۴ | ۵۶٫۳۹ | ۵۴٫۳۱ | ۵۹٫۱۹ | ۱۰۲ (۲۰٫۱۲٪)
GPT-6 Astra | ۷۱٫۷۳ | ۴۶٫۵۵ | ۵۵٫۸۷ | ۶۰٫۸۷ | ۵۶٫۸۳ | ۵۸٫۳۱ | ۲۳۱ (۴۵٫۵۶٪)
Kimi-K3 | ۸۲٫۲۴ | ۵۰٫۸۰ | ۶۱٫۸۳ | ۴۱٫۳۵ | ۵۱٫۶۳ | ۵۷٫۳۷ | ۶۸ (۱۳٫۴۱٪)
Qwen3.8-27B | ۶۴٫۰۳ | ۴۷٫۸۵ | ۵۳٫۴۱ | ۴۷٫۸۸ | ۴۵٫۶۹ | ۵۱٫۷۰ | ۳۸ (۷٫۵۰٪)
نتیجهٔ اصلی، ردیف Observed 20/20 در Table 1 است. مدلی ۲۷B که در ابتدا ۳۸ وظیفه (۷٫۵٪) از ThinkingBox-Bench را در هر تلاش کامل میکرد، اکنون ۱۰۷ وظیفه (۲۱٫۱٪) را در هر تلاش کامل میکند؛ تقریباً سه برابر. برای مقایسه، Observed 20/20 برای Kimi-K3 برابر ۶۸، برای GPT-5.4 برابر ۱۲۸، برای GPT-6 Astra برابر ۲۳۱ و برای Claude Opus 5.5 با ۲۴۱ در صدر است.
میانگین موفقیت و تکرارپذیری ترتیبهای متفاوتی میسازند. در Table 2 میبینیم GPT-5.6 Sol در pass@1 کمی بالاتر از Qwen3.8-27B ریزتنظیمشده با RL قرار گرفت (۶۱٫۹۱٪ در برابر ۶۰٫۷۸٪)، اما در تمام ۲۰ تلاش ثبتشده وظایف کمتری را گذراند: ۸۲ در برابر ۱۰۷. Claude Sonnet 4.6 در pass@1 پایینتر بود، ۵۹٫۱۹٪، اما تقریباً همان تعداد وظیفه را در هر تلاش گذراند: ۱۰۲ وظیفه. هیچکدام از این دو شاخص بهتنهایی تصویر کامل را نشان نمیدهد.
الگوی مشاهدهشده با «تیزشدگی» سازگار است: موفقیت تکرارپذیر بالا رفت، در حالی که پوشش «دستکم یکبار» اندکی کاهش یافت. این با پژوهشهای پیشین همراستاست. یکی از توضیحها این است که توزیع احتمال به سمت مسیرهایی حرکت کرد که بهطور مکرر کار میکنند و برخی مسیرهای کماحتمال از میان رفتند.
در مجموع، مدل گستردهتر نشد؛ تکرارپذیرتر شد. پرسش بعدی این است که این بهبودها کجا نشستند.
بهبودها کجا نشستند
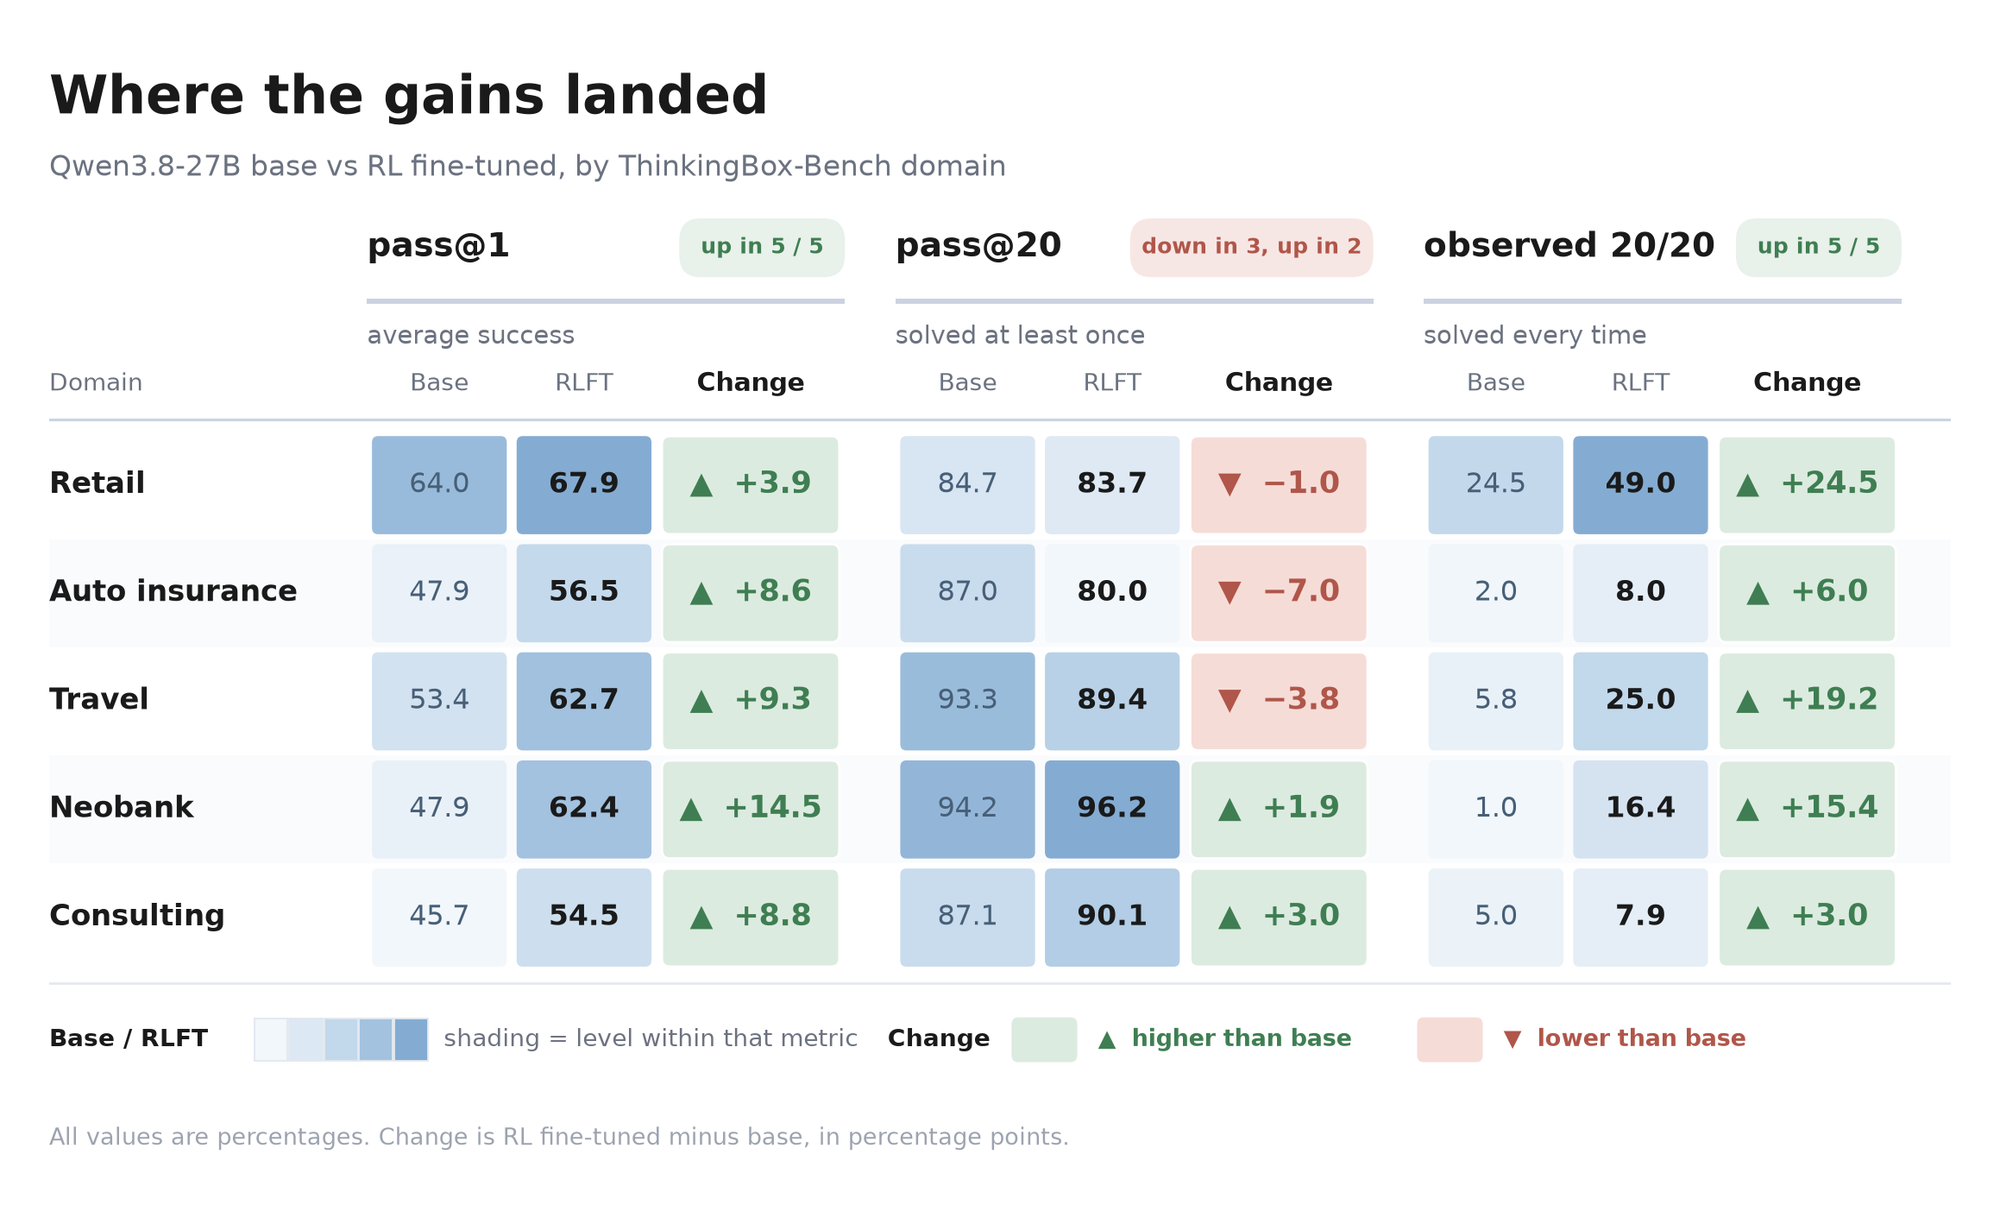
Figure 3. امتیازهای پایه و RLFT در سطح دامنه و تغییرات برحسب واحد درصد. خانههای سبز افزایش و خانههای قرمز کاهش را نشان میدهند؛ سایهٔ آبی سطح امتیاز را در هر شاخص نشان میدهد.
pass@1 و Observed 20/20 در هر پنج دامنه افزایش یافتند. pass@20 نتایج متفاوتی داشت: در نئوبانک و مشاوره افزایش یافت، اما در خردهفروشی، سفر و بیمهٔ خودرو کاهش پیدا کرد. بیمهٔ خودرو بیشترین کاهش پوشش را داشت (−۷٫۰ واحد)، در حالی که خردهفروشی بیشترین افزایش Observed 20/20 را داشت (+۲۴٫۵ واحد).
قابلیت اتکا چه هزینهای دارد
نخستین پست، هزینهٔ سازگاری را با حساب ساده برآورد کرد: هزینهٔ برآوردی کمپین کامل ۲۰ اجرا را بر تعداد وظایفی تقسیم کرد که مدل هر بار از پس آنها برمیآید.
هزینهٔ هر وظیفهٔ قابل اتکا = هزینهٔ برآوردی کمپین ۵۰۷ × ۲۰ ÷ وظایف موفق در ۲۰/۲۰
با اعمال همان محاسبهٔ هزینه بر مصرف توکن اندازهگیریشدهٔ چکپوینت ریزتنظیمشده:
جدول ۳. هزینهٔ برآوردی ارزیابی و قابلیت اتکا برای Qwen3.8-27B پایه و ریزتنظیمشده با RL. هزینهٔ هر تلاش موفق، کل هزینهٔ برآوردی کمپین (۵۰۷ × ۲۰) را بر تعداد تلاشهای موفق تقسیم میکند.
شاخص | پایه | | ریزتنظیمشده با RL | تغییر
هزینهٔ کمپین، ۲۰ اجرا | ۹۲۵٫۸۰ دلار | → | ۸۵۵٫۵۸ دلار | −۷٫۶٪
هزینهٔ هر تلاش موفق | ۰٫۱۷۷ دلار | → | ۰٫۱۳۹ دلار | −۲۱٫۴٪
وظایف موفق در ۲۰/۲۰ | ۳۸ | → | ۱۰۷ | ۲٫۸ برابر
هزینهٔ هر وظیفهٔ قابل اتکا | ۲۴٫۳۶ دلار | → | ۸٫۰۰ دلار | −۶۷٫۲٪
با ۸٫۰۰ دلار برای هر وظیفهٔ قابل اتکا، مدل ریزتنظیمشده در مقایسهٔ همراه به GPT-5.4 (۶٫۸۰ دلار)، GPT-6 Astra (۷٫۴۵ دلار) و Claude Opus 5.5 (۷٫۸۰ دلار) نزدیک شد.
نمای تکتلاشی
شکل ۴ هزینهٔ هر تلاش موفق را در برابر pass@1 میسنجد.
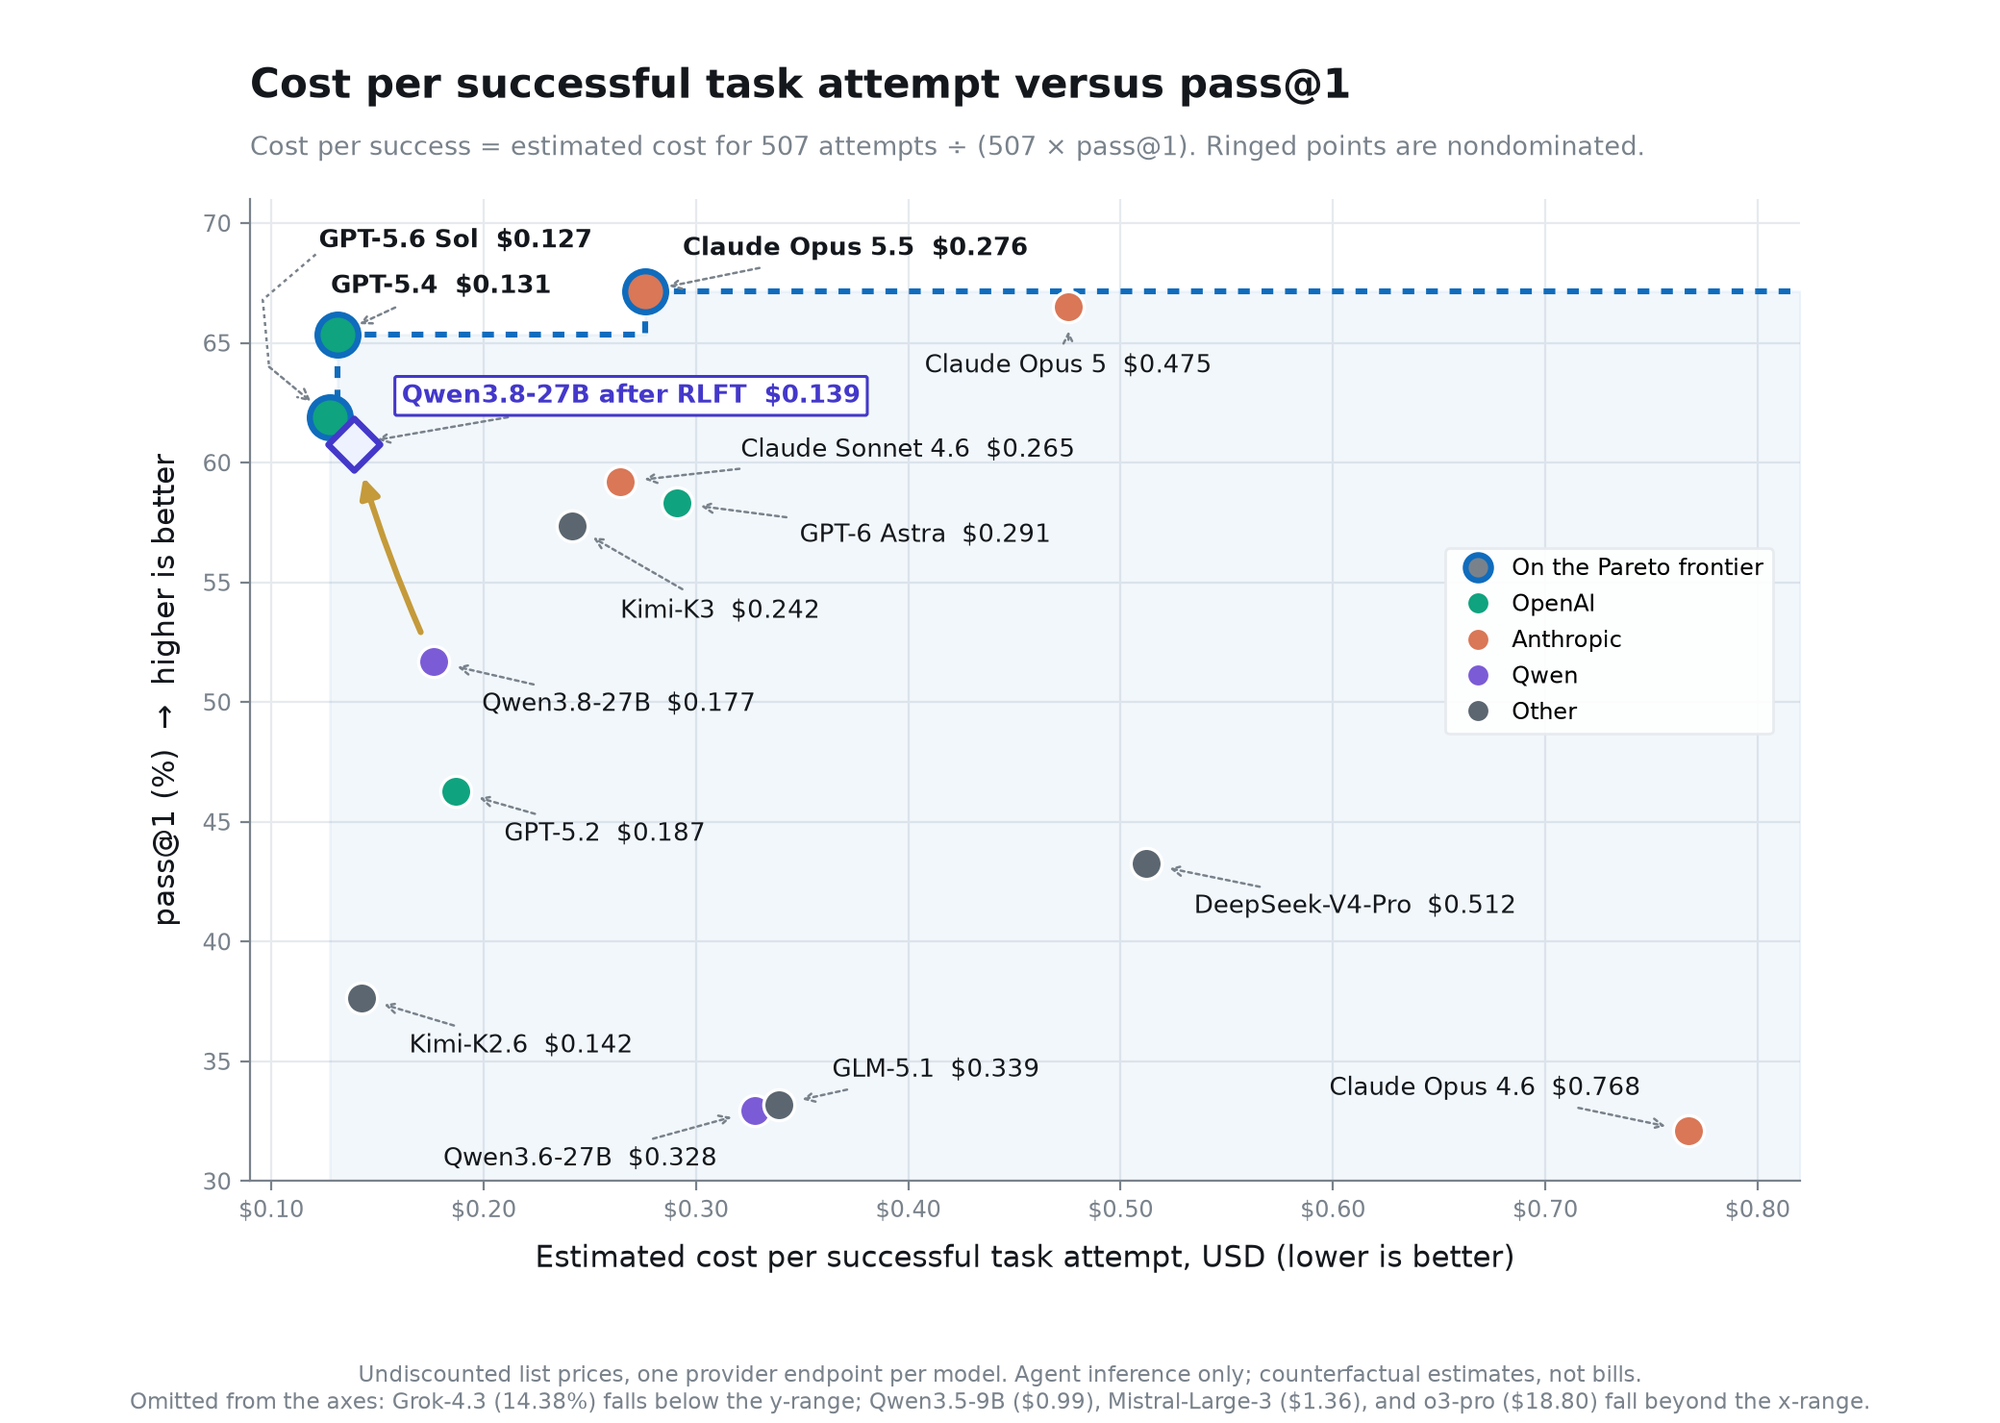
شکل ۴. پیکان طلایی جایگاه هزینهٔ پارتو (pareto cost) مدل پایهٔ Qwen3.8-27B را تا RLFT (لوزی) دنبال میکند: pass@1 از ۵۱٫۷۰٪ به ۶۰٫۷۸٪ میرسد و هزینهٔ برآوردی هر تلاش موفق از ۰٫۱۷۷ دلار به ۰٫۱۳۹ دلار کاهش مییابد. دایرههای حلقهدار مرز هزینهٔ پارتو را نشان میدهند.
این جابهجایی، چکپوینت ریزتنظیمشده را نزدیک GPT-5.6 Sol قرار میدهد، هرچند GPT-5.6 Sol همچنان ارزانتر است و در pass@1 کمی بالاتر قرار دارد. چهار مدلی که در مقالهٔ ما قیمتگذاری شدهاند، خارج از بازهٔ نمودار قرار میگیرند.
ارقام دلاری یک شاخص مقایسهای سرو هستند، نه صورتحساب یا هزینهٔ ابری. سرو کردن چکپوینت ریزتنظیمشده همانند مدل پایه خواهد بود. این محاسبه هزینهٔ استنتاج مدل را شامل میشود و هزینهٔ اجرای آموزش و کاوش سیاست برای آمادهسازی مجموعهدادهٔ آموزش را در بر نمیگیرد.
این نتایج به ما میگویند چه چیزی جابهجا شد. بخشهای بعدی حلقهٔ آموزش و دلیل اهمیت بیش از همهٔ انتخاب وظایف درست را توضیح میدهند.
حلقهٔ آموزش
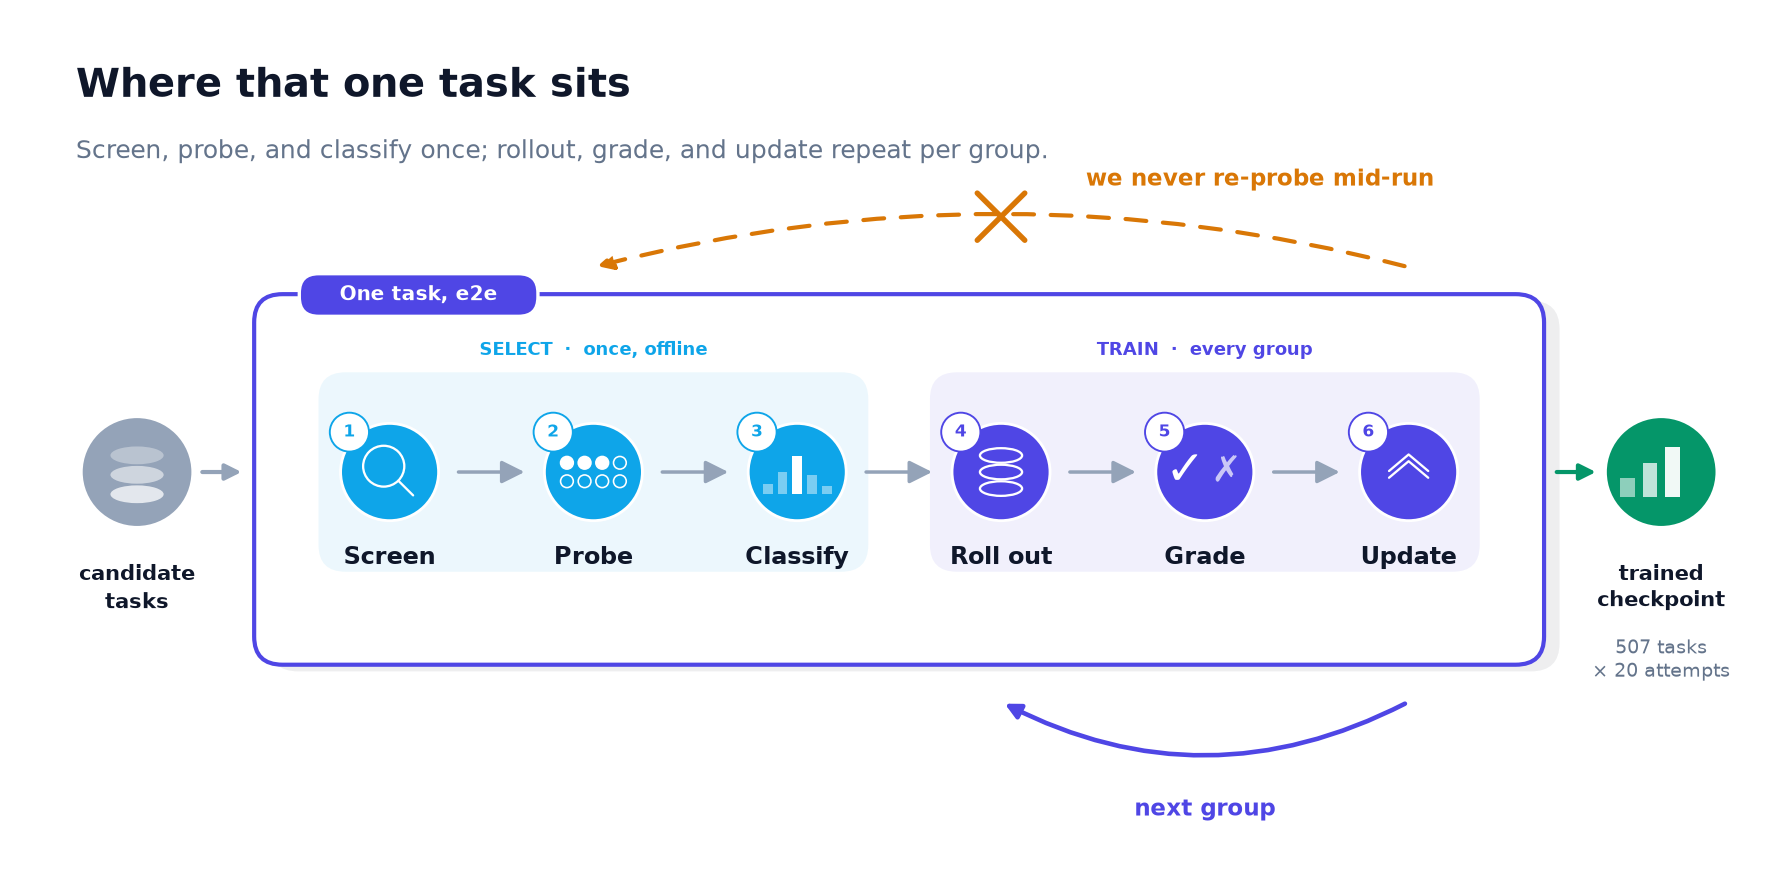
شکل ۵. شش مرحله، اینبار در بافت کامل: وظایف نامزد وارد میشوند، سه مرحلهٔ نخست یکبار بهصورت آفلاین اجرا میشوند و سه مرحلهٔ آخر برای هر گروه در اجرای آموزش تکرار میشوند. چکپوینت آموزشدیده در برابر ThinkingBox-Bench ارزیابی میشود.
انتخاب یکبار و بهصورت آفلاین و در برابر مدل سیاست پایه، یعنی در این مورد Qwen3.8 27B، اجرا میشود؛ سپس آموزش از همان مخزن ثابتی استفاده میکند که آماده شده است. پیکان کهربایی خطچین در شکل ۵ مسیری را نشان میدهد که نرفتیم: کاوش دوبارهٔ دشواری در طول اجرای آموزش.
هر رولاوت (اجرای کامل یک اپیزود) یک اپیزود کامل است، نه تکمیل متن. هر رولاوت یک بکاند تازه، یک نشست MCP جداگانه و GPT-5 Chat را بهعنوان کاربر شبیهسازیشده دریافت میکند. بیشتر پاداشها از بررسیهای قطعی وضعیت پایانی میآیند؛ اقلیتی از الزامات باریک روبریک میتوانند داور پیکربندیشده (GPT-5 Chat) را فراخوانی کنند.
آموزش و ارزیابی باید خروجی Qwen را یکسان تفسیر کنند. این شامل استخراج استدلال، فراخوانی ابزار، نوعبندی آرگومانها، رندر کردن و وضعیت جدای وظیفه میشود. در غیر این صورت، پاداش عامل متفاوتی را از عامل ارزیابیشده میسنجد. کد تفسیر مشترک در trainer/core/tb_interpret.py قرار دارد.
برای اجرای مرجع، Qwen3.8-27B را با ریزتنظیم RL تمامپارامتری روی ۱۸۷ وظیفه و با GRPO با میانگین توکن (token-mean GRPO) آموزش دادیم. هر بهروزرسانی ۱۸ گروه ۸ رولاوتی، یعنی ۱۴۴ اپیزود، روی ۲۴ کارت H100 تولید میکرد. آموزش بهصورت همگام و با بارگذاری خارجی پارامتر و بهینهساز اجرا شد؛ AdamW با نرخ یادگیری 1e-6 و بدون کاهش وزن (weight decay صفر) استفاده شد. آموزش را ۵۰ گام اجرا کردیم.
گروههای بدون واریانس (zero-variance groups) در طول آموزش به سبک DAPO جایگزین شدند. خطاهای سیستمی جداگانه رسیدگی شدند: پایان مهلت بکاند بهمعنای نتیجهٔ نادرست عامل نیست، بنابراین گروههای متأثر دوباره پر شدند و بهعنوان شکست امتیاز نگرفتند.
این توضیح داد وظایف نگهداشتهشده چگونه آموزش دیدند. پرسش باقیمانده این است که کدام وظایف وارد مخزن آموزش شدند.
دشواری نسبی به سیاست، بهصورت آفلاین
پیش از ورود به جزئیات انتخاب وظایف آموزشی، یک توضیح:
هیچ وظیفهای از ThinkingBox-Bench در مخزن آموزش RL گنجانده نشد. بنچمارک برای ارزیابی کنار گذاشته شد.
ThinkingBox-Bench نسبت به مخزن آموزش RL خارج از توزیع است: دامنهها، پایگاههای داده، سیاستها و بیشتر ابزارهای آن در آموزش RL دیده نشدند. با این حال، این دو مجموعه هنوز چارچوب ThinkingBox، سازوکار کاربر شبیهسازیشده، ارزیابی اجرایی وضعیت پایانی، چند ابزار مشترک و سبک وظیفهٔ مشابه را با هم دارند. این عناصر مشترک، دامنهٔ ادعای انتقال را محدود میکنند.
اهمیت انتخاب به یک واقعیت حسابی دربارهٔ GRPO برمیگردد. اگر هر هشت رولاوت شکست بخورند، بردار پاداش [0, 0, 0, 0, 0, 0, 0, 0] است. اگر هر هشت موفق شوند، [1, 1, 1, 1, 1, 1, 1, 1] است. در هر دو حالت، مرکزکردن درون گروه هیچ مزیت پاداشی برای وظیفه تولید نمیکند، چون هیچ مسیری بهتر از دیگری عمل نکرده است. ++
گروهی مختلط مانند [0, 0, 0, 1, 1, 1, 1, 1] همان تضادی را فراهم میکند که GRPO میتواند از آن یاد بگیرد. این تفکیک برای یک عامل حالتدار پرهزینه است: هر رولاوت یک بکاند جداگانه فراهم میکند، یک نشست واقعی ابزار اجرا میکند و مدل جداگانهای را برای ایفای نقش کاربر فراخوانی میکند.
پرسشی که این کار را شکل داد، بنابراین فقط این نبود که کدام مدل یا کدام بهینهساز؟ بلکه این بود: کدام وظایف نامزد باید وارد مخزن ثابت آموزش شوند؟
برای انتخاب مخزن آموزش از یک فیلتر نرخ موفقیت آفلاین روی توزیع پسین استفاده کردیم. این فیلتر تخمین میزند کدام وظایف به احتمال زیاد تحت سیاست پایه پاداشهای پایانی متضاد تولید میکنند.
پس کاوش میکنیم. هر وظیفهٔ نامزد بهطور مکرر در برابر مدل سیاست پایه اجرا میشود. قاعده به زبان ساده این است: وظایفی که مدل همیشه در آنها شکست میخورد به احتمال زیاد هنوز چیزی به آن نمیآموزند؛ وظایفی که همیشه از آنها عبور میکند از پیش یاد گرفته شدهاند؛ وظایفی که گاهی حل میکند همان جایی هستند که نتایج میتوانند تضاد ایجاد کنند.
تخمین دشواری از کاوشهای محدود
هر وظیفهٔ نامزد n بار اجرا میشود و k موفقیت به دست میآید. احتمال موفقیت نهفتهٔ آن را با احتمال پسین جفریز (Jeffreys posterior probability) مدل میکنیم:
احتمال موفقیت | k موفقیت در n کاوش ~ Beta(k + ½, n − k + ½)
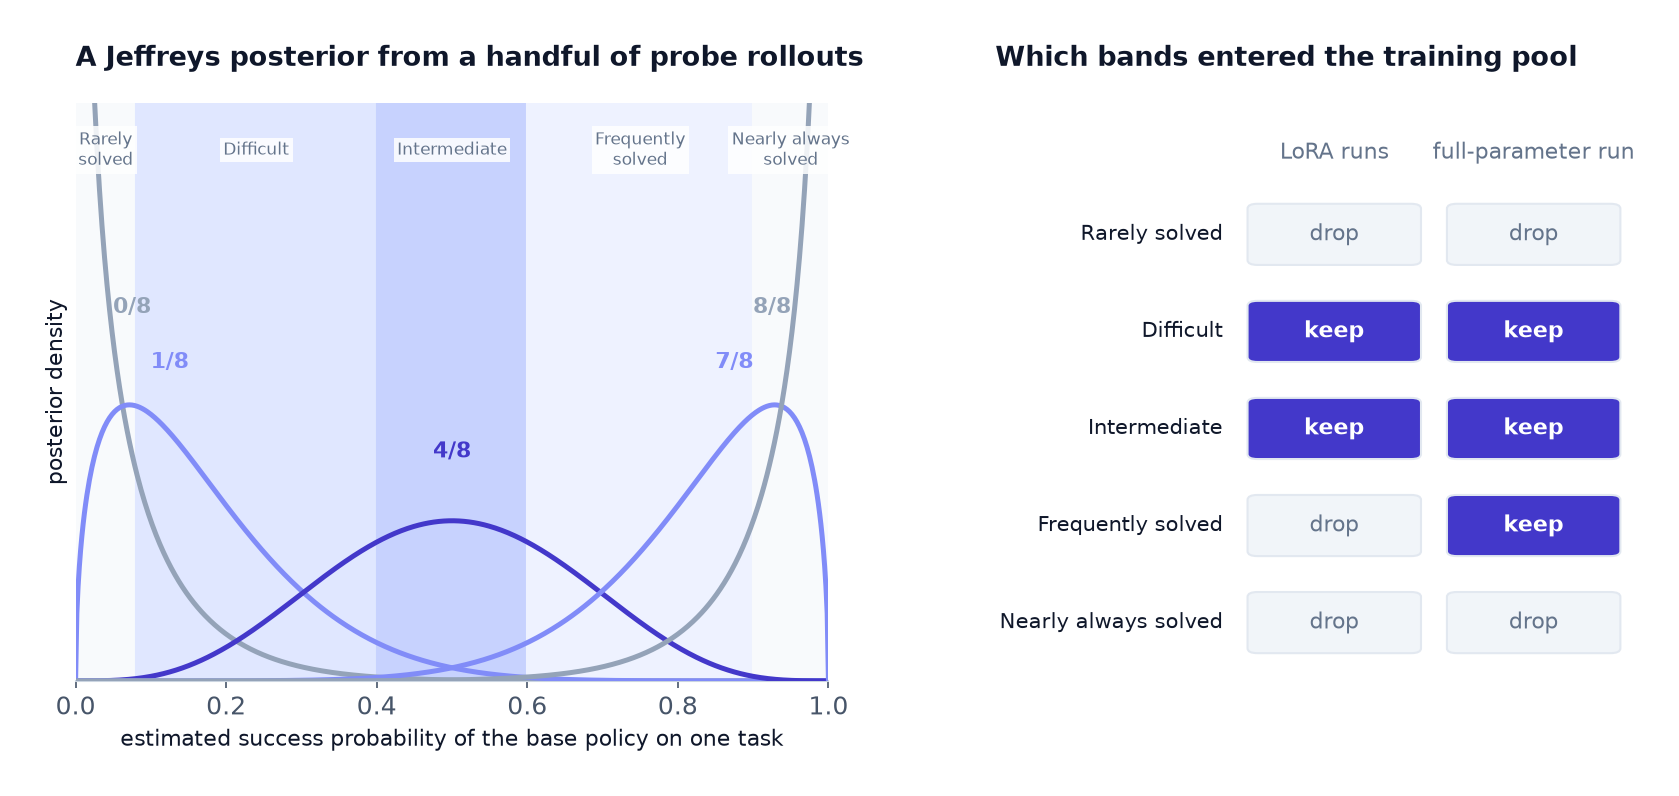
شکل ۶. دشواری نسبی به سیاست، بهصورت آفلاین از کاوشهای مکرر سیاست پایه تخمین زده میشود و برای نگهداشتن وظایفی به کار میرود که به احتمال زیاد پاداشهای متضاد تولید میکنند.
بازهٔ واحد را به پنج سطل با مرزهای ۰٫۰۸، ۰٫۴۰، ۰٫۶۰ و ۰٫۹۰ تقسیم کردیم که بهعنوان ابرپارامتر برای این اجراها انتخاب شدند. هر وظیفه به سطلی اختصاص مییابد که بیشترین جرم پسین را دارد:
کمحلشده [۰، ۰٫۰۸): حذف
دشوار [۰٫۰۸، ۰٫۴۰): نگهداشتن
میانی [۰٫۴۰، ۰٫۶۰): نگهداشتن
پرحلشده [۰٫۶۰، ۰٫۹۰): نگهداشتن برای RLFT تمامپارامتری
تقریباً همیشه حلشده [۰٫۹۰، ۱]: حذف
جزئیات بیشتر در Appendix C.4 مقالهٔ ThinkingBox ما آمده است.
یک وظیفه، از ابتدا تا انتها
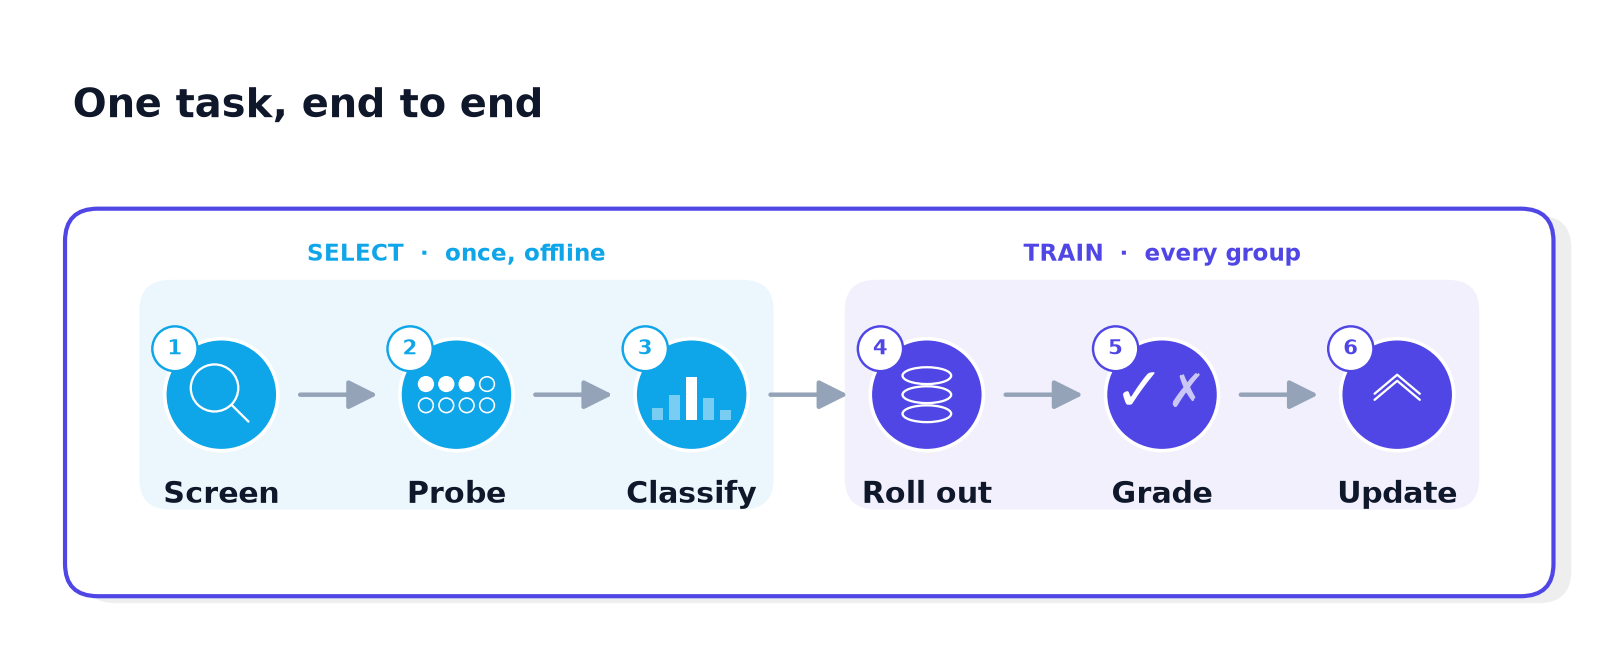
شکل ۷. با بزرگنمایی، یک وظیفه در تمام شش مرحله: غربالگری با GPT-5.4، کاوشهای مدل پایه، طبقهبندی دشواری، یک گروه رولاوت، ارزیابی وضعیت پایانی و یک بهروزرسانی GRPO.
شکل ۷ یک وظیفهٔ نامزد را دنبال میکند که میتواند بالقوه وارد مخزن آموزش شود. برای مخزن تمامپارامتری Qwen3.8-27B، ابتدا GPT-5.4 نقش غربالگر حلپذیری را ایفا کرد. سپس سیاست پایه در تعداد کمی از کاوشها، مثلاً ۳ از ۸، موفق شد و توزیع پسین Beta(3.5, 5.5) را تولید کرد. بیشترین جرم آن، ۵۴٫۰٪، در نوار «دشوار» قرار گرفت.
وقتی این وظیفه برای آموزش نمونهگیری شد، گروه پاداش مختلط [0, 0, 0, 0, 1, 1, 1, 1] را تولید کرد. بنابراین مسیرهای موفق مزیت پاداشی بالاتر از میانگین و مسیرهای ناموفق مزیت پایینتر از میانگین گرفتند و به GRPO تضادی برای یادگیری دادند. مدل سیاستی متفاوت میتواند همان وظیفه را در نوار دشواری دیگری قرار دهد.
مخزن آموزش آمادهشدهٔ نهایی Qwen3.8-27B شامل ۱۸۷ وظیفه بود.
چه چیزی پاداش میگیرد
هیچ چیز دربارهٔ مسیر اجرا مهم نیست. پاداش، همان حکم اجرایی خود وظیفه است.
وقتی یک اپیزود پایان مییابد، سندباکس آنچه را واقعاً در بکاند تغییر کرده استخراج میکند و بررسیهای قطعی وظیفه را روی وضعیت پایانی اجرا میکند. هر مسیری که وضعیت پایانی درست را تولید کند، قبول میشود. عوارض جانبی نادرست، جاافتاده یا اضافی رد میشوند. پاداش ۱ یا ۰ است.
در بنچمارک، میتوان ارزیاب پایگاه داده را «ممتحن» دانست: عاملی را گرفت که موفقیت گزارش کرده بود و رکورد اشتباه باقی گذاشته بود. در آموزش، میتوان همان نوع بررسی را «معلم» دانست، اینبار روی مجموعهای متفاوت و جدا از وظایف.
دو مسیر پاداش، یک حکم دودویی. بررسی اجرایی (اکثریت بزرگ). وقتی نتیجهٔ لازم در وضعیت پایانی یا عوارض جانبی بازنمایی میشود، یک آزمون قطعی آن را میپذیرد یا رد میکند؛ نیازی به فراخوانی داور LLM نیست. بررسی با کمک داور (اقلیت). وقتی یک الزام باریک را نمیتوان بهطور تمیز از وضعیت پایگاه داده تعیین کرد، داور LLM پیکربندیشده به یک پرسش دودویی روبریک پاسخ میدهد که آزمون اجرایی از آن استفاده میکند.
اجرای پشتهٔ آموزش
دادهٔ انتخاب، رولاوت، پاداش و یکپارچهسازی Verl را که برای آموزش Qwen3.8-27B به کار رفت، در microsoft/thinkingbox-training منتشر میکنیم. README مخزن نقطهٔ شروع است. راهنماهای تفصیلی عبارتاند از:
docs/data-preparation.md برای آمادهسازی وظایف، کاوشهای سیاست، حذف بنچمارک و تقسیم آموزش/اعتبارسنجی؛
docs/reference-q38-run.md برای پیکربندی اعتبارسنجیشدهٔ Qwen3.8 روی ۲۴ کارت H100؛
docs/evaluation.md برای ادغام چکپوینت و اجرای ThinkingBox-Bench بهصورت ۵۰۷ × ۲۰.
پیش از شروع
روی Linux و WSL با Python 3.12 و uv آزموده شده است. به GPUهای NVIDIA با پشتهٔ سازگار CUDA/NCCL، یک چکپوینت محلی Qwen3.8-27B و نقاط پایانی سازگار با OpenAI برای کاربر شبیهسازیشده و داور نیاز دارید. پیکربندی مرجع اعتبارسنجیشده از ۳ گره × ۸ GPU H100 استفاده میکند؛ پیکربندیهای سفارشی کوچکتر به اندازهٔ مدل، طول زمینه و همزمانی رولاوت بستگی دارند.
فهرست نمونهٔ عمومی وظایف برای آزمودن رابط است. این فهرست همان مخزن خصوصی ۱۸۷ وظیفهای آموزش نیست که برای اجرای گزارششده به کار رفت. یک منبع آموزشی مجاز فراهم کنید که از بنچمارک عمومی جدا بماند.
نصب
سه مخزن را کنار هم قرار دهید:
mkdir -p ~/thinkingbox-workspace
cd ~/thinkingbox-workspace

git clone https://github.com/microsoft/thinkingbox.git
git clone https://github.com/microsoft/thinkingbox-data.git
git clone --branch main https://github.com/microsoft/thinkingbox-training

git -C thinkingbox checkout 892964e7226044e5463ad188da119df838f4bec1
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
ساخت محیط اعتبارسنجیشده
پشتهٔ منتشرشده برای Linux، Python 3.12، Verl 0.9.0 و قفل بستههای پینشده هدفگذاری شده است:
cd ~/thinkingbox-workspace/thinkingbox-training

uv venv --python 3.12
source .venv/bin/activate

uv sync --frozen --extra fast --extra tracking --extra eval-proxy
uv pip install -e ../thinkingbox
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/thinkingbox_tools
uv pip install --config-settings editable-mode=compat \
  -e ../thinkingbox-data/servers/tb_business_ops_servers_202606

python scripts/prepare_verl.py --dest .deps/verl --install
python scripts/verify_verl_install.py
uv pip check
دو فرمان آخر باید یک نسخهٔ Verl وصلهشدهٔ تأییدشده را گزارش کنند و هیچ نیازمندی شکستهای نداشته باشند. پس از آن همگامسازی خودکار بستههای دیگر را اجرا نکنید؛ این کار میتواند نصب منبع وصلهشده را با بستهٔ Verl خام جایگزین کند.
آمادهسازی دادهٔ آموزش
با نمونههای عمومی ارائهشده شروع کنید یا مجموعهدادهٔ مجاز خود را در قالب ThinkingBox اضافه کنید. سپس اسکریپت آمادهسازی مخزن را اجرا کنید:
cd ~/thinkingbox-workspace/thinkingbox-training
source .venv/bin/activate
python data/prepare_data.py --help
این اسکریپت کاوشهای سیاست را تجمیع میکند، فیلترهای دشواری نسبی به سیاست، بهصورت آفلاین (offline policy-relative difficulty) و حذفهای بنچمارک را اعمال میکند و فایلهای انتخابشدهٔ train.yaml و test.yaml را مینویسد. docs/data-preparation.md فیلدهای ورودی، قرارداد بارگذار و فرمان کامل را مستند میکند.
پیکربندی و بازبینی اجرا
راهنمای docs/reference-q38-run.md را دنبال کنید تا Typesense و سرورهای MCP را راه بیندازید، کاربر شبیهسازیشده و داور را پیکربندی کنید، متغیرهای مدل، فهرست وظایف، چکپوینت و توپولوژی را تنظیم کنید و خوشهٔ Ray را آماده کنید. اعتبارنامهها را بهجای فایلهای ثبتشده یا تاریخچهٔ شل، از طریق تزریق مخفی در زمان اجرا نگه دارید.
پیش از تخصیص یک کار آموزش، از فرمان اجرای آزمایشی (dry-run) راهنما استفاده کنید:
DRY_RUN=true ./scripts/run_train.sh \
  trainer.total_training_steps=50 \
  trainer.save_freq=5
این فرمان باید بدون راهاندازی Ray یا تخصیص GPU با کد خروج صفر پایان یابد. فرمان چاپشدهٔ python -m verl.trainer.main_ppo و هر بازنویسی حلشده را پیش از آغاز اجرا بخوانید.
آموزش
راهانداز، آموزش را پیکربندی میکند؛ میزبانها را فراهم نمیکند. در توپولوژی مرجع سهگرهی، همان محیط را روی هر گره صادر کنید، CHECKPOINT_DIR را در همان مسیر مطلق سوار کنید و سپس Ray را راه بیندازید:
# head node
ROLE=head NODE_IP="$HEAD_IP" GPUS_PER_NODE=8 \
  ./scripts/start_ray.sh

# each worker node
ROLE=worker NODE_IP="$WORKER_IP" \
  HEAD_ADDRESS="$HEAD_IP:6379" GPUS_PER_NODE=8 \
  ./scripts/start_ray.sh
پس از اینکه ray status همهٔ ۲۴ GPU را گزارش کرد، یکبار از گرهٔ سر اجرا کنید:
export RAY_ADDRESS=auto
export GPUS=0,1,2,3,4,5,6,7

./scripts/run_train.sh \
  trainer.project_name=thinkingbox-training \
  trainer.experiment_name=q38-full-rlft \
  trainer.total_training_steps=50 \
  trainer.save_freq=5
ارزیابی چکپوینت از طریق OpenEnv
نخستین پست ThinkingBox به Typesense، MCP Session Proxy و راهاندازی OpenEnv میپردازد. چکپوینت آموزشدیده را طبق docs/evaluation.md ادغام کنید و سپس آن را با vLLM سرو کنید.
از ریشهٔ مخزن OpenEnv، MERGED_MODEL را روی پوشهٔ مدل ادغامشده و THINKINGBOX_DATA را روی نسخهٔ پینشدهٔ بنچمارک تنظیم کنید. ارزیابی تاریخی چکپوینت از این پیکربندی سرو هشتکارت A100 استفاده کرد:
vllm serve "$MERGED_MODEL" \
  --served-model-name q38-rlft \
  --host 127.0.0.1 \
  --port 8001 \
  --tensor-parallel-size 8 \
  --dtype bfloat16 \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.85 \
  --max-num-seqs 16 \
  --max-num-batched-tokens 8192 \
  --language-model-only \
  --enable-chunked-prefill \
  --enable-prefix-caching \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_xml
در ترمینالی جداگانه، پروکسی سازگاری OpenEnv را برای قالب چت Qwen از نسخهٔ ThinkingBox Training راه بیندازید. این پروکسی روی پورت 8014 گوش میدهد و درخواستها را به vLLM روی پورت 8001 میفرستد:
cd ~/thinkingbox-workspace/thinkingbox-training
source .venv/bin/activate
bash scripts/launch_sysmerge.sh
آن را در طول ارزیابی در حال اجرا نگه دارید. از ترمینال دیگری آمادگی را بررسی کنید:
curl --fail http://127.0.0.1:8014/readyzمدخل عامل را در thinkingbox.yaml موجود بهروزرسانی کنید؛ پیکربندی MCP، کاربر شبیهسازیشده و داور آن را حفظ کنید:
orchestrator:
  agent_model:
    type: aoai
    endpoint_url: http://127.0.0.1:8014/v1/chat/completions
    deployment: q38-rlft
    credential:
      type: api-key
      api_key: <your_api_key>
    is_reasoning: true
    temperature: 1.0
    top_k: 20
    top_p: 0.95
    max_completion_tokens: 8192
    timeout: 1800
OpenEnv را مانند پست نخست راه بیندازید، با OPENENV_TB_CONFIG که به همین thinkingbox.yaml اشاره میکند و OPENENV_TB_DATASET که به $THINKINGBOX_DATA اشاره میکند. پس از موفقیت /ready، پروتکل کامل ۵۰۷ وظیفه × ۲۰ تلاش را اجرا کنید:
uv run --project envs/thinkingbox_env --frozen \
  thinkingbox-eval \
  --config "$PWD/thinkingbox.yaml" \
  --base-url http://127.0.0.1:8000 \
  --dataset "$THINKINGBOX_DATA" \
  --output q38-rlft-full.jsonl \
  --errors-output q38-rlft-full-errors.jsonl \
  --repeat 20 \
  --coverage-profile full \
  --aggregate-output q38-rlft-full-aggregate.json \
  --message-timeout 1800
پروفایل کامل پیش از تجمیع، همهٔ ۱۰٬۱۴۰ کلید مورد انتظار وظیفه/تکرار را اعتبارسنجی میکند.
مسیر بعدی
بخش مفید این کار یک چکپوینت Qwen3.8-27B نیست؛ حلقهٔ آموزش و آمادهسازی دادهٔ آموزشی است که نتایج اجرایی را به پاداش تبدیل میکند.
اگر عاملی را آموزش میدهید یا ارزیابی میکنید که با رکوردهای واقعی پایگاه داده سروکار دارد:
پیش از آموزش بررسی کنید. مجموعهٔ وظایف عامل خود را بردارید، سیاست پایه را n بار روی آن اجرا کنید و به هیستوگرام نوارها نگاه کنید. در تجربهٔ ما، تیمها اغلب این توزیع را بررسی نکردهاند و معمولاً نامتوازنتر از حد انتظار است.
همارزی خود را بررسی کنید. همان خروجی ثبتشدهٔ مدل را از طریق تحلیلگرهای آموزش و ارزیابی دوباره اجرا کنید و تأیید کنید که هر دو نام و آرگومانهای ابزار یکسانی استخراج میکنند. در غیر این صورت، آموزش ممکن است رفتاری را پاداش دهد که ارزیابی آن را متفاوت تفسیر میکند.
هم پوشش و هم تکرارپذیری را گزارش کنید. بگویید چند وظیفه در k تلاش دستکم یکبار موفق میشوند و چند وظیفه در همهٔ k تلاش موفق میشوند. مدلی که گاهی راهحلی پیدا میکند لزوماً مدلی نیست که آن را بهطور پیوسته تکرار کند.
جزئیات بیشتر را میتوانید در پیوندهای زیر بیابید:
محیط: envs/thinkingbox_env
OpenEnv: مستندات محیط ThinkingBox
چارچوب: microsoft/thinkingbox · آموزش
بنچمارک: microsoft/thinkingbox-data
نمایشگر داده: microsoft/ThinkingBox-Bench
مقاله: arXiv:2608.19741 یا HF
آموزش RL: microsoft/thinkingbox-training
وبلاگ: «The Agent Said It Was Done. The Database Disagreed.»
ارجاع به مقاله
@article{li2026thinkingbox,
  title   = {One Success Isn't Reliability: Thinkingbox, a Sandbox and Benchmark for Agents in Stateful Business Workflows},
  author  = {Li, Zhuochun and Ko, Youngmin and Keramati, Ali and Kundu, Tuhin and
             Tsai, Liang-Chun and Ferri, Nicola and Milletari, Mirco and Liu, Jiaxiang and
             Lopez Pelaez, Susana Palmaz and Wang, Yuepeng and Smolyakov, Vadim and
             Jiang, Xiang and Olafsson, Kjartan and Guy, Tommy},
  journal = {arXiv preprint arXiv:2608.19741},
  year    = {2026},
  url     = {https://arxiv.org/abs/2608.19741}
}
کد ThinkingBox با مجوز MIT و دادهٔ بنچمارک با مجوز CDLA-Permissive-2.0 منتشر شده است.
سلب مسئولیت: هر وظیفه در بنچمارک عمومی یک بازسازی مصنوعی است. گردشکارها و سیاستها بر پایهٔ الگوهای واقعی عاملهای سازمانی مدلسازی شدهاند؛ مشتریان واقعی نیستند.
ThinkingBox، ThinkingBox-Bench و ThinkingBox-Training توسط تیم Microsoft Copilot Studio و با همکاری Toloka و همکارانی از دانشگاه پیتسبورگ (University of Pittsburgh)، دانشگاه نورثوسترن (Northwestern University)، دانشگاه کلمبیا (Columbia University) و دانشگاه کالیفرنیا ایرواین (UC Irvine) ساخته شدهاند که در مایکروسافت کارآموزی کردهاند. پرسشها را میتوانید در بخش نظرات زیر یا در GitHub یا از طریق ایمیل firstnamelastname@microsoft.com مطرح کنید.
+ اقلیتی از وظایف نیز الزامات باریک دودویی روبریک را برای نتایجی شامل میشوند که پایگاه داده نمیتواند بهطور تمیز ثبت کند؛ این بررسیها میتوانند داور LLM پیکربندیشده را فراخوانی کنند.
++ آن مشکل گرادیان صفر یک راهحل استاندارد در زمان دستهبندی دارد: نمونهگیری بیش از حد، کنار گذاشتن گروههای تباهیده و پر کردن دوباره. اجرای تمامپارامتری دقیقاً همین کار را کرد، مشابه DAPO با جایگزینی گروههای بدون واریانس. اما پر کردن دوباره همچنان هزینهٔ کامل هر رولاوت تلفشده را پیش از دور انداختن آن میپردازد.
 نگار رضایی
 آرمان کریمی