آرمان کریمی
خلاصه: Inkling 2 Mini یک مدل ترانسفورمر حلقهای تازه است. این مدل یک ترکیب خبرگان (Mixture-of-Experts) چندوجهی با حدود ۲۶ میلیارد پارامتر کل و ۳ میلیارد پارامتر فعال به ازای هر توکن است. برای افزایش ظرفیت، از ترفند جالبی استفاده میکند: برخی لایهها در حلقهای سه بار تکرار میشوند و همین باعث میشود مدل طوری کار کند که گویی پارامترهای بیشتری دارد. اندازه زمینه آن ۱ میلیون توکن است و ورودی تصویر و متن را میپذیرد. Thinking Machines Lab این مدل را در قالبی با دقت مختلط عرضه میکند که وزنهای خبرگان در آن با NVFP4 و MXFP8 ذخیره شدهاند. یک پیشنویسکننده DSpark هم برای سرعت بیشتر، با هزینه حافظه اندک، در بسته گنجانده شده است.
Inkling 2 Mini بسیار بسیار کوچکتر از Inkling 2 Small است و برای محیطهای هوش مصنوعی محلی طراحی شده است. به نظر ما این یک مدل محلی تازه و بسیار خوب است. در آزمونهای ذهنی ما، عملکردش دستکم با Qwen 3.8 27B قابل مقایسه است. اعتبارسنجی بیشتری لازم است، اما از این عرضه بسیار هیجانزدهایم!
پشتیبانی از transformers، Llama App (llama.cpp) و MLX را عرضه کردهایم. SGLang هم پشتیبانی استنتاج از روز اول را برای استقرارهای تولیدی روی سختافزار دیتاسنتر فراهم میکند.
این مطلب به این میپردازد که چه چیزی Inkling Mini را متفاوت میکند، چند آزمون ذهنی ما را مرور میکند و نشان میدهد چطور میتوانید آن را در محیط خودتان به کار ببرید.
چه چیزی در Inkling 2 Mini تازه است؟
Inkling 2 Mini یک مدل ترکیب خبرگان با ۲۴ لایه رمزگشا است، اما ۱۲ لایه میانی سه بار در یک حلقه اجرا میشوند. در نتیجه، مدل با تنها ۲۴ لایه فیزیکی طوری عمل میکند که گویی ۴۸ لایه منطقی دارد (۶ + ۳×۱۲ + ۶).
Inkling 2 Mini هم مانند Inkling 2 Small در هر توکن ۴۸ بازدید لایهای انجام میدهد. اندازه پنهان آن ۲٬۳۰۴ است، نه ۴٬۶۰۸. در هر بازدید لایه، هر دو نسخه توکن را به ۸ خبره مسیریابی میکنند، اما Mini آنها را از میان ۱۲۸ خبره در هر لایه انتخاب میکند و Small از میان ۳۸۴ خبره. رمزگشا لایههای ۰ تا ۵ را یک بار، لایههای ۶ تا ۱۷ را سه بار و لایههای ۱۸ تا ۲۳ را یک بار اجرا میکند. هر سه گذر از لایههای ۶ تا ۱۷ از همان وزنهای مشترک استفاده میکنند.
معماریهایی مانند Nanbeige پیشتر حلقهزنی را بررسی کردهاند، اما Inkling 2 Mini رویکرد جالبی را دنبال میکند. هر گذر از هسته حلقهای (لایههای ۶ تا ۱۷) از همان ورودیها شروع میشود؛ یعنی خروجی شش لایه اول. اطلاعات میان گذرها از طریق پیامهای بینگذر جابهجا میشود. هر لایه حلقهای با پرسوجوی یادگرفتهشده خودش (یک پیام برای ورودیهای پرسوجو، کلید، مقدار و MLP آن) پیامی را از خروجیهای گذر قبلی میخواند. سپس یک کنترلکننده دریچهای کوچک هم به ورودی فعلی لایه نگاه میکند و هم به پیام، و تصمیم میگیرد چه مقدار از ورودی فعلی را فراموش کند و چه مقدار از پیام را بیفزاید. بنابراین هر گذر آنچه را گذر قبلی محاسبه کرده، پالایش میکند.
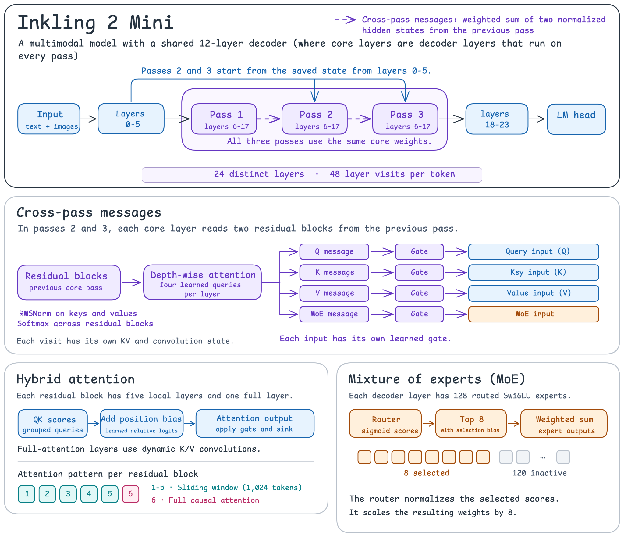
هر بلوک ششلایهای پنج لایه پنجره لغزان و یک لایه توجه کامل دارد. پنجره محلی تا ۱٬۰۲۴ توکن را در خود جای میدهد. توجه از ۲۴ سر پرسوجو و هشت سر KV استفاده میکند و لجیتهای موقعیت نسبی یادگرفتهشده، یک سینک یادگرفتهشده و یک دریچه خروجی دارد. لایههای توجه کامل از کانولوشنهای پویای کلید و مقدار استفاده میکنند. مسیریاب برای هر توکن هشت خبره از ۱۲۸ خبره SwiGLU را انتخاب میکند، امتیازهای انتخابشده را نرمال میکند و وزنها را در ۸ ضرب میکند. در گذرهای دوم و سوم، هر لایه هسته روی دو بلوک باقیمانده از گذر قبلی توجه میکند. چهار دریچه رتبه ۶۴، پیامهای جداگانه را در ورودیهای پرسوجو، کلید، مقدار و MoE ترکیب میکنند.
عرض رمزگشای متنی ۲٬۳۰۴ است و عرض میانی هر خبره ۱٬۱۵۲. استفاده دوباره از وزنهای هسته، تعداد لایههای متمایزی را که چکپوینت ذخیره میکند کاهش میدهد. مدل همچنان هر ۴۸ بازدید را اجرا میکند و هر بازدید وضعیت KV و وضعیت کانولوشن کوتاه خودش را نگه میدارد.
در کنار مدل پرچمدار Inkling 2 Mini، یک محصول تحقیقاتی هم عرضه شده است. این نسخه همان معماری را دارد، اما طوری آموزش دیده که تعداد متغیری گذر از حلقه را بپذیرد 🤯. تنظیم آن روی ۱ یا ۲ گذر بهجای ۳، استنتاج را بسیار سریعتر میکند، اما ممکن است کیفیت خروجیها کمی پایینتر باشد. این نسخه را آزمایش کردهایم و کار میکند، اما ارزیابی عمیقی از آن انجام ندادهایم.
نتایج بنچمارک
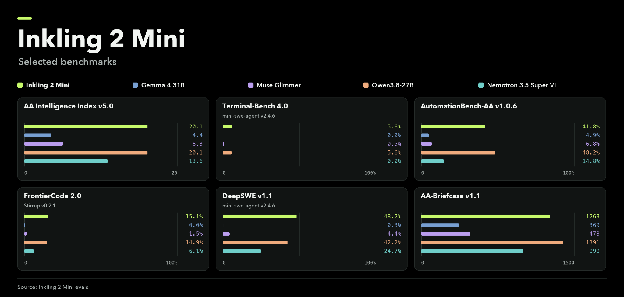
Inkling 2 Mini در کلاس خودش در شاخص هوش Artificial Analysis Intelligence Index v5 (AAv5) و همچنین در بسیاری از بنچمارکها در دستههای مختلف، بهترین عملکرد را دارد. در مقایسه با Gemma 4 31B، Muse Glimmer، Qwen3.8-27B و Nemotron 3.5 Super VL، Inkling 2 Mini در ۳۲ بنچمارک از ۴۸ بنچمارک جلوتر است. این بنچمارکها کدنویسی و پژوهش خودکار، جستوجوی عاملی و استفاده از ابزار برای کارهای دانشی، تفسیر و تولید تصویر، استدلال و دانش، و ایمنی و همراستایی را پوشش میدهند. فهرست کامل بنچمارکها و امتیازها را در کارت مدل Inkling 2 Mini ببینید.
Inkling 2 Mini یک همراه کدنویسی محلی عالی است. در FrontierCode v2.0 جلوتر است، در Terminal-Bench 4.0 با Qwen3.8-27B برابر است و در AutomationBench-AA v1.0.6 از Qwen عقبتر است. در ادامه چند نمونه از نتایج برجسته ما در کدنویسی و کارهای دانشی را ببینید. توجه کنید که AA Briefcase با امتیاز ELO سنجیده میشود و امتیاز بالاتر بهتر است.
پشتیبانی از استنتاج
در این بخش میبینید که چطور از Inkling 2 Mini در transformers، llama.cpp، MLX و SGLang استفاده کنید.
transformers
از هر دو نسخه پشتیبانی میکنیم: Inkling 2 Mini (حلقه ثابت) و نسخه تحقیقاتی TML-d24-varloop-research (حلقه متغیر).
حلقه ثابت با Inkling 2 Mini
میتوانید از کلاس AutoModelForMultimodalLM استفاده کنید.
import torch
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/Inkling-2-Mini"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
    model_id,
)

messages = [{"role": "user", "content": [{"type": "text", "text": "Why is the sky blue?"}]}]

inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))
حلقه متغیر
برای تعیین تعداد حلقهها در چکپوینت تحقیقاتی، میتوانید loop_num_passes را در text_config بهصورت زیر تغییر دهید. مثال زیر از دو حلقه استفاده میکند.
import torch
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/TML-d24-varloop-research"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
    model_id,
    text_config={"loop_num_passes": 2},
)

messages = [{"role": "user", "content": [{"type": "text", "text": "Why is the sky blue?"}]}]

inputs = processor.apply_chat_template(
    messages, reasoning_effort="medium", tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))
تصویر و متن
برای یک درخواست تصویری، messages را در هر یک از مثالها با فهرست زیر جایگزین کنید و مثل همیشه استنتاج را اجرا کنید.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "/path/to/image.jpg"},
            {"type": "text", "text": "What is in this image?"},
        ],
    }
]
میزان تلاش استدلال
برای تعیین میزان تلاش یک درخواست، reasoning_effort="medium" را به processor.apply_chat_template(...) بدهید. قالب چت مقدار عددی را بهصورت یک پیام سیستمی به درخواست اضافه میکند. مقدار پیشفرض high (0.9) است.
inputs = processor.apply_chat_template(
    messages, reasoning_effort="medium", tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt",
).to(model.device)
سطوح موجود عبارتاند از none (0.0)، minimal (0.1)، low (0.2)، medium (0.7)، high (0.9؛ پیشفرض)، xhigh (0.99) و max (0.99). میتوانید عددی از 0.0 تا 0.99 هم بدهید، مثلاً reasoning_effort=0.35.
فراخوانی ابزار
بیایید مدل را وادار کنیم چند ابزار را فراخوانی کند.
در این مثال از مدل میپرسیم دمای فعلی یک مکان مشخص چقدر است. همراه با درخواست، ابزار (get_current_temperature) را هم در اختیارش میگذاریم تا این کار را انجام دهد. مدل درخواست فراخوانی ابزار میدهد، ما بهجای آن ابزار را صدا میزنیم و سپس خروجی را به مجموعه دستور بعدی اضافه میکنیم. مدل از خروجی ابزار استفاده میکند و نتیجه نهایی را به ما میدهد.
اگر میخواهید درباره فراخوانی ابزار بیشتر بدانید، پیشنهاد میکنیم به مستندات رسمی ما سر بزنید.
import torch
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "thinkingmachines/Inkling-2-Mini"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, dtype=torch.bfloat16, device_map="auto")


def get_current_temperature(location: str, unit: str):
    """
    Get the current temperature at a location.

    Args:
        location: The location to get the temperature for, in the format "City, Country"
        unit: The unit to return the temperature in. (choices: ["celsius", "fahrenheit"])
    """
    return 22.0  # A real function would call a weather API here


def ask(messages):
    inputs = processor.apply_chat_template(
        messages, tools=[get_current_temperature], reasoning_effort="low", tokenize=True, return_dict=True, return_tensors="pt"
    ).to(model.device)
    output = model.generate(**inputs, max_new_tokens=1024)[0][inputs["input_ids"].shape[-1] :]
    parsed = processor.parse_response(output, prefix=inputs["input_ids"][0])
    return parsed


messages = [{"role": "user", "content": "Hey, what's the temperature in Paris right now?"}]

reply = ask(messages)
call = reply["tool_calls"][0]["function"]
print("Model calls:", call["name"], call["arguments"])  # the model fills in the arguments itself

temperature = get_current_temperature(**call["arguments"])
messages += [reply, {"role": "tool", "name": call["name"], "content": str(temperature)}]
print(ask(messages)["content"])

# Model calls: get_current_temperature {'location': 'Paris, France', 'unit': 'celsius'}
# Right now in Paris it’s about **22°C** (roughly **71.6°F**).
Llama App و llama.cpp
Llama App به شما امکان میدهد مدلهای زبانی محلی را بهراحتی روی macOS (از نوار منو) یا Windows (سینی سیستم) اجرا و مدیریت کنید. این برنامه بر پایه llama.cpp ساخته شده و همان تیم آن را توسعه داده است. برنامه همچنین یک API محلی سازگار با OpenAI ارائه میکند تا اتصال به عاملهای کدنویسی، ویرایشگرها و اسکریپتها آسان شود.
برای عرضه Inkling 2 Mini، کوانتیزههای ۴ بیتی (IQ4_NL) و ۸ بیتی (Q8_0) در قالب GGUF برای هر دو مدل ارائه میکنیم.
اگر روی Linux هستید یا میخواهید مدل را از خط فرمان سرو کنید، میتوانید برای مدل حلقه ثابت دستور زیر را اجرا کنید:
llama serve -hf ggml-org/Inkling-2-Mini-GGUF:IQ4_NLبرای اجرای مدل حلقه متغیر میتوانید این را اجرا کنید
llama serve -hf ggml-org/TML-d24-varloop-research-GGUF:IQ4_NLبرای بارگذاری وزنهای ۸ بیتی، پسوند را به :Q8_0 تغییر دهید.
در اینجا از مدل ۴ بیتی میخواهیم برای یک سرویس SaaS به نام plant therapy وبسایتی بسازد که در آن گیاهان آپارتمانی به درمانگرهای دارای مجوز وصل میشوند. مدل کاملاً خودمختار عمل میکند؛ SVGهای تصاویر وبسایت را خودش ساخته و حتی منطق تطبیق را هم پیاده کرده است.
SGLang
Inkling 2 Mini از روز اول در SGLang پشتیبانی میشود. میتوانید آخرین نسخه SGLang را نصب کنید و برای بالا آوردن سرور دستور زیر را اجرا کنید. یک پیشنیاز که باید رعایت شود، اجرای آن روی SM103 است.
export MODEL="thinkingmachines/Inkling-2-Mini"

python -m sglang.launch_server \
  --model-path $MODEL \
  --served-model-name inkling \
  --attention-backend fa4 --bf16-gemm-backend torch --dtype bfloat16 \
  --tp 1 --page-size 128 --grammar-backend xgrammar \
  --host 0.0.0.0 --port 30000
پس از بالا آمدن سرور باید بتوانید APIها را اینطور فراخوانی کنید
curl -s localhost:30000/health_generate && echo OK
curl -s localhost:30000/v1/models | python -m json.tool

curl -s localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
        "model": "inkling",
        "messages": [{"role": "user", "content": "What is 17 times 24?"}],
        "max_tokens": 512,
        "reasoning_effort": "low"
      }' | python -m json.tool
همچنین میتوانید با تنظیم --enable-multimodal چندوجهی بودن را فعال کنید.
رمزگشایی حدسی
SGLang میتواند از یک پیشنویس سهلایه DSpark استفاده کند تا توکنهایی را برای تأیید مدل هدف پیشنهاد دهد. این پیشنویس ورودیهای بازدیدهای ۵، ۲۳ و ۴۱ رمزگشا و همچنین وضعیت نرمالشده نهایی در اندیس ۴۸ را میخواند. وقتی وزنهای پیشنویس موجود باشند، --speculative-algorithm DSPARK --context-length 131072 را به دستور سرور اضافه کنید.
مدلها را با و بدون رمزگشایی حدسی بنچمارک کردیم و سرعت تولید را روی یک GPU NVIDIA B300 اندازه گرفتیم؛ در این آزمون هر درخواست یک درخواست ۱٬۰۲۴ توکنی دارد، دقیقاً ۱٬۰۲۴ توکن تولید میکند و همروندی ۱، ۴، ۱۶ و ۶۴ است.
MODEL=thinkingmachines/Inkling-2-Mini

for TAG in base mtp; do
  EXTRA=""; [ $TAG = mtp ] && EXTRA="--speculative-algorithm DSPARK"

  # Start the server (with or without MTP)
  python -m sglang.launch_server --model-path $MODEL \
    --attention-backend fa4 --bf16-gemm-backend torch --dtype bfloat16 \
    --tp 1 --page-size 128 --context-length 131072 --max-running-requests 64 \
    --port 30000 $EXTRA > $TAG.log 2>&1 &
  until curl -sf localhost:30000/health_generate > /dev/null; do sleep 10; done

  # Benchmark at increasing concurrency
  for C in 1 4 16 64; do
    python -m sglang.bench_serving --backend sglang --port 30000 --model $MODEL \
      --dataset-name random --apply-chat-template \
      --random-input-len 1024 --random-output-len 1024 --random-range-ratio 1.0 \
      --num-prompts $(( C*4 < 32 ? 32 : C*4 )) --max-concurrency $C \
      --output-file results_$TAG.jsonl
  done

  kill %1; wait
done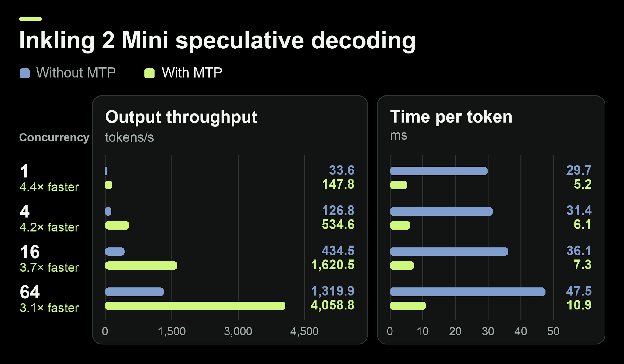
MLX
پشتیبانی از MLX را به پروژه mlx-lm فرستادیم؛ از جمله ورودیهای چندوجهی تصویر و متن و کوانتیزههای مشترک از طریق سازمان mlx-community.
استنتاج با MLX با چکپوینت اصلی هم کار میکند. در این حالت، طرح کوانتیزه بومی nvfp4 + mxfp8 بدون تبدیل دوباره به کار میرود و همان کیفیتی را میگیرید که نویسندگان مدل در نظر داشتهاند.
نمونهای از فراخوانی از خط فرمان:
mlx_lm generate --model thinkingmachines/Inkling-2-Mini --image image.jpg --prompt "Describe this image.<|end_message|><|message_user|><|content_image|><|unused_200054|>" -m 1000دموها و آزمونهای ذهنی
Inkling 2 Mini را در بسیاری از کارهای سرگرمکننده امتحان کردهایم؛ در این بخش آنها را ببینید.
پروازهای سهبعدی با شیدر
یک درخواست یکسان دو پرواز غروب را روی کوههای رویهای و آب بازتابنده تولید کرد که هر کدام با یک شیدر قطعه WebGL رندر شدهاند.
Sunset Ridge (Inkling 2 Mini)
Over the Still Sea (Qwen 3.8 27B)
چشمگیرترین صحنه بلادرنگ و اصیلی را که میتوانی بساز بساز: یک پرواز دوربین آرام و سینمایی روی کوههای رویهای، از میان ابرهای حجمی و پایین روی آب با بازتابها، همه در نور غروب. آن را بهصورت یک فایل index.html مستقل و خودکفا در پوشه فعلی تحویل بده که همهچیز را در یک شیدر قطعه WebGL تمامصفحه و صرفاً از روی کد رندر کند (بدون بافت، تصویر، فونت، کتابخانه، فایل خارجی یا درخواست شبکه از هیچ نوعی). باید در Chrome دسکتاپ با رزولوشن 1920x1080 روان اجرا شود، با هدف ۶۰ فریم بر ثانیه روی GPU دسکتاپ، و یک افت خودکار مقیاس رزولوشن داشته باشد که وقتی نرخ فریم پایین میآید رزولوشن رندر داخلی را کم کند؛ پرواز هم باید بیپایان و بدون نقص ادامه یابد. برای بررسی کارت، دستور node shot.cjs index.html shot.png 6 را اجرا کن (آرگومان سوم تعداد ثانیههای انتظار است؛ فهرستی جداشده با کاما مثل 3,12,25 در هر زمان یک اسکرینشات ذخیره میکند و آرگومان چهارم اختیاری اندازه را تعیین میکند که پیشفرضش 1280x720 است): این دستور صفحه را در Chrome بیسر رندر میکند، اسکرینشاتها را ذخیره میکند و رندرر WebGL، نرخ فریم تقریبی و هر خطای کنسول را چاپ میکند؛ بعد تصاویر را نگاه کن. رندرر بیسر روی این ماشین ممکن است فقط نرمافزاری باشد، بنابراین نرخ فریمش میتواند بسیار پایینتر از GPU دسکتاپ واقعی باشد و هدف محسوب نمیشود. خودت تصمیم بگیر چه وقت نتیجه تمام است، سپس با توضیح کوتاهی از آنچه ساختهای پاسخ بده.
شب پرستاره، زنده
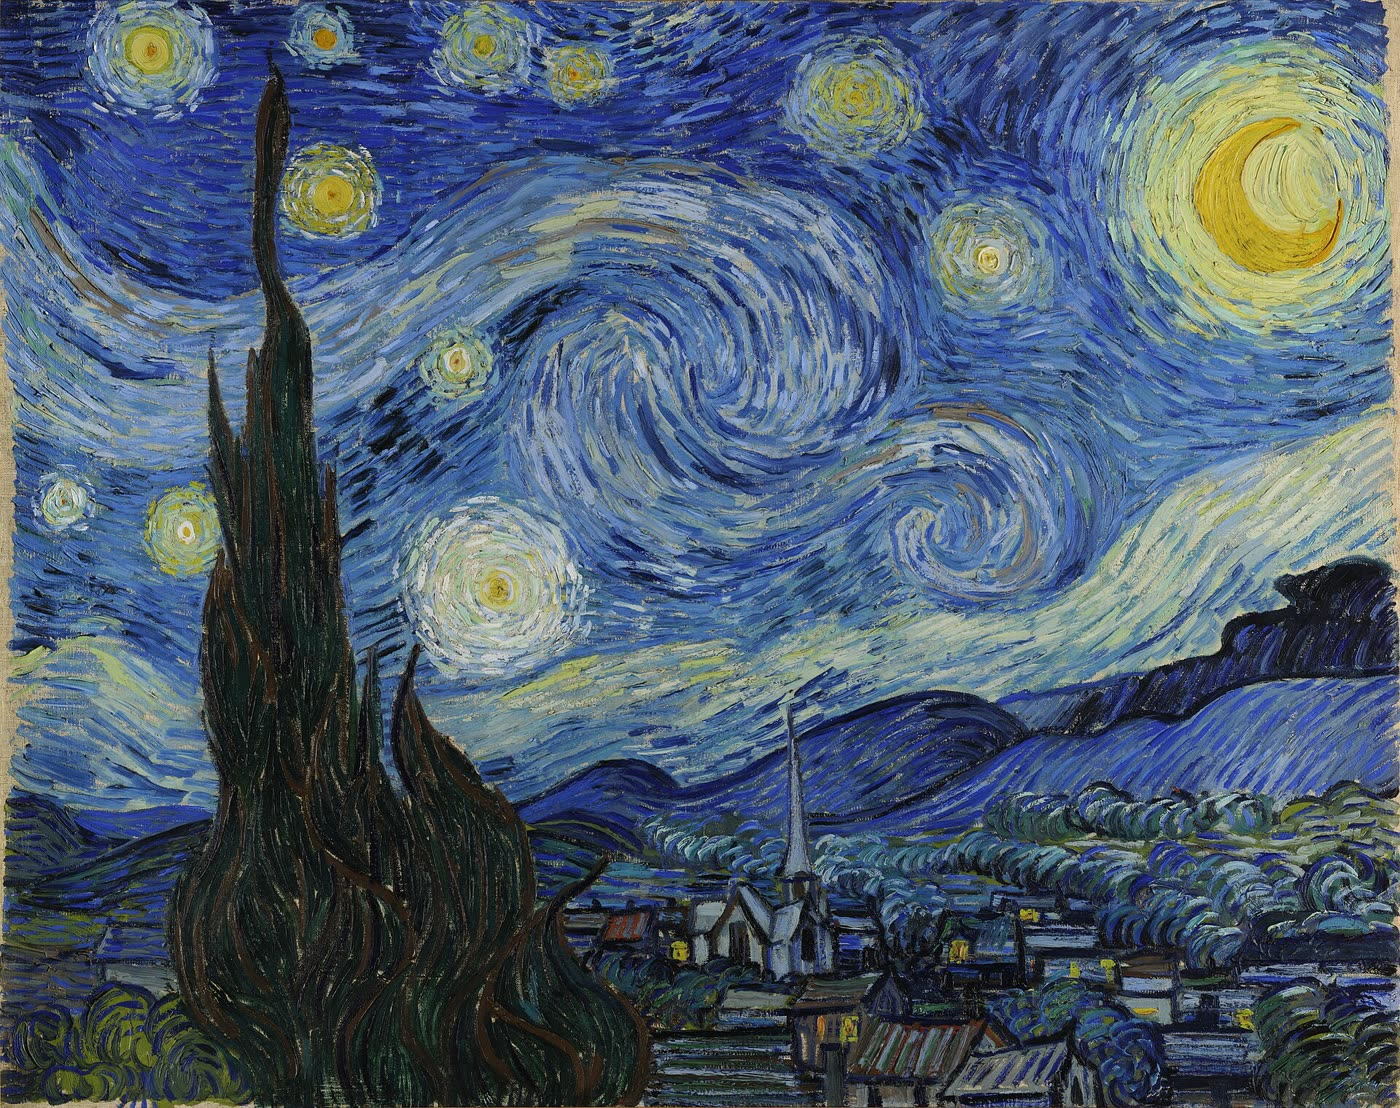
Vincent van Gogh, The Starry Night (1889)
بازسازی Inkling 2 Mini
در محیط کدنویسی Pi، یک تصویر مرجع از نقاشی ون گوگ و یک ابزار کمکی اسکرینشات به Inkling 2 Mini دادیم. Inkling یک صفحه HTML خودکفا با یک شیدر قطعه WebGL2 نوشت. این شیدر صحنه را از روی کد رسم میکند، بدون بارگذاری تصویر مرجع یا هیچ دارایی دیگری. از زمان برای جانبخشی به آسمان چرخان، درخشش ستارهها، تاب خوردن سرو و سوسوی پنجرههای روستا استفاده میکند.
Inkling کارش را در ۲۴ دور بررسی اسکرینشات رندر و بازبینی کرد. انیمیشن نهایی را فریمبهفریم با کیفیت 1080p و ۶۰ فریم بر ثانیه روی Apple M4 Max ضبط کردیم.
در این پوشه، starry-night.jpg نقاشی شب پرستاره ون گوگ (۱۸۸۹، مالکیت عمومی) است. آن را بهصورت یک نقاشی زنده بازسازی کن: یک فایل index.html مستقل و خودکفا (همه کد درونخطی، بدون فایل خارجی، کتابخانه یا درخواست شبکه) که پنجره مرورگر را پر کند و در Chrome دسکتاپ با رزولوشن 1920x1080 روان اجرا شود. همهچیز باید بهصورت رویهای در کد تولید شود، مثلاً با شیدرهای WebGL؛ صفحه نباید starry-night.jpg یا هیچ تصویر دیگری را بارگذاری، جاسازی یا نمونهبرداری کند. به ترکیببندی و پالت نقاشی وفادار بمان (مارپیچ بزرگ و جریانهای چرخان آسمان، ستارههای هالهدار، ماه هلالی درخشان، سرو تیره و شعلهمانند در سمت چپ، تپههای مواج و روستا با مناره کلیسا)، آن را با ضربهقلمهای ضخیم و جهتدار ون گوگ رندر کن و به آن جان بده: چرخشهای آسمان جریان یابند، ستارهها و ماه با نور بتپند، سرو تاب بخورد و پنجرههای روستا بدرخشند و سوسو بزنند. هدف، چشمگیرترین نتیجهای باشد که میتوانی بسازی. یک ابزار کمکی در دسترس است: node shot.js --help را اجرا کن تا ببینی چطور از index.html در چند لحظه اسکرینشات بگیری؛ اسکرینشاتها را کنار مرجع نگاه کن و تا وقتی راضی نشدهای بهبود بده، سپس با خلاصه کوتاهی از آنچه ساختهای پاسخ بده.
از دستنوشته تا اپلیکیشن
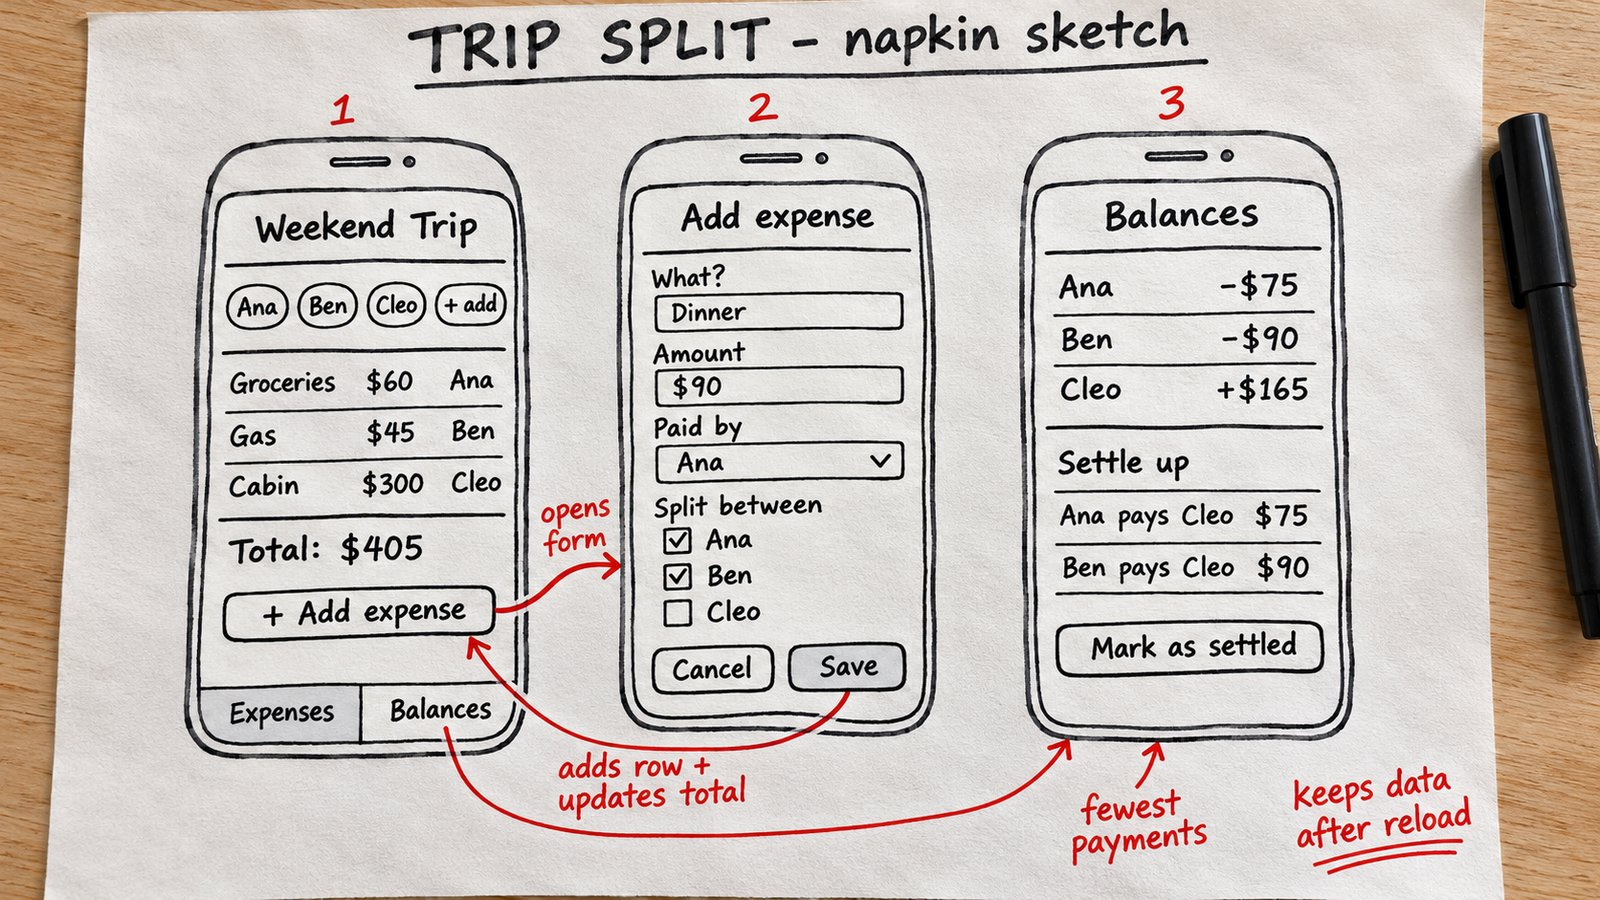
طرح اولیه دستنویس
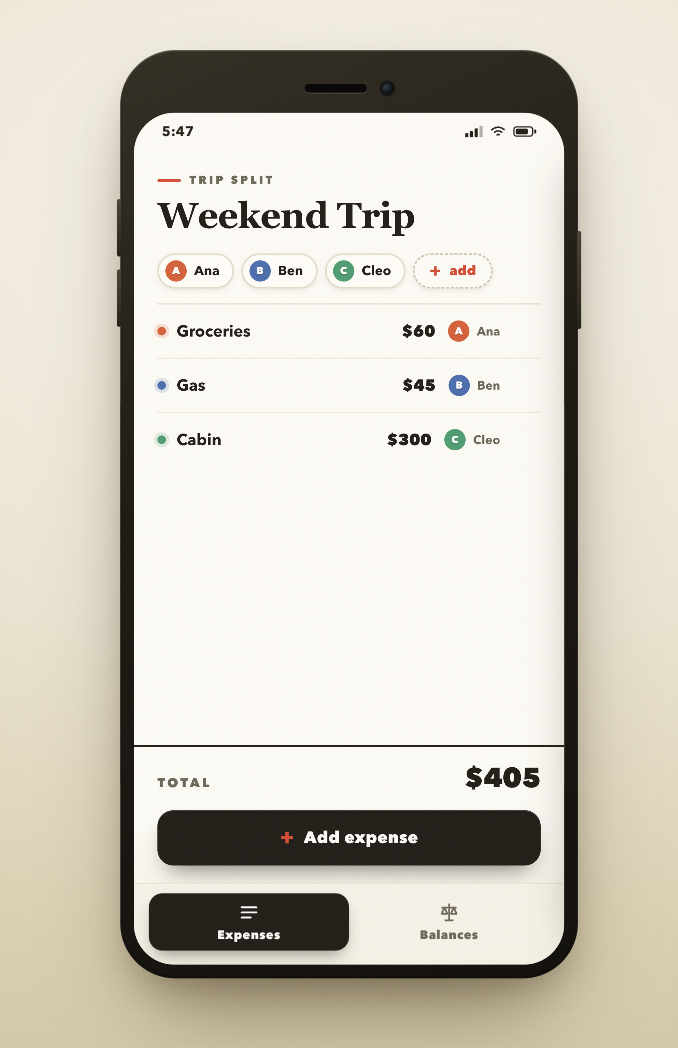
اپلیکیشن Trip Split تولیدشده
در محیط کدنویسی Pi، یک عکس از وایرفریم دستنویس Trip Split و یک درخواست یکپاراگرافی به Inkling 2 Mini دادیم. Inkling از برچسبها، هزینههای نمونه و یادداشتهای دستنویس طرح استفاده کرد تا فهرست هزینهها، فرم افزودن هزینه و نمای ماندهها را در یک فایل HTML با CSS و JavaScript خالص بسازد. اپلیکیشن با تغییر هزینهها، مجموعها و ماندهها را بهروز میکند، پرداختهایی برای تسویه سفر پیشنهاد میدهد و دادهها را در حافظه محلی مرورگر (localStorage) ذخیره میکند تا پس از بارگذاری دوباره باقی بمانند.
سه تلاش مستقل Inkling را اجرا کردیم و با Playwright روی هر نسخه کلیک کردیم و در جاهایی که قضاوت بصری لازم بود، اسکرینشاتها را بررسی کردیم. تلاش اول که اینجا نشان داده شده، از همه ۱۳ بررسی گذشت. افزودن شام ۹۰ دلاری طرح، مجموع را از ۴۰۵ دلار به ۴۹۵ دلار رساند و سهم هر نفر را دوباره محاسبه کرد.
عکس sketch.jpg در این پوشه، وایرفریم دستنویس یک طراح محصول برای یک اپلیکیشن کوچک است. آن اپلیکیشن را واقعاً بساز، بهصورت چشمگیرترین و اصیلترین نسخه باکیفیت تولیدی که میتوانی: یک فایل index.html مستقل و خودکفا در این پوشه فقط با HTML، CSS و JavaScript خالص (بدون چارچوب، CDN، فایل خارجی یا درخواست شبکه؛ localStorage مجاز است) که باید در Chrome دسکتاپ با رزولوشن 1920x1080 روان اجرا شود. هر چیزی روی کاغذ را مشخصات در نظر بگیر: هر صفحه، برچسب، دکمه و عدد، دادههای نمونه و هر یادداشت قرمز، رفتاری را توصیف میکنند که باید واقعاً کار کند؛ در حالی که طراحی بصری، تایپوگرافی و حرکت را تو با زیبایی اجرا میکنی. طرح را با دقت و با بینایی خودت نگاه کن و دوباره با بیناییات کار خودت را بررسی کن: node shot.cjs --help یک ابزار کمکی را توضیح میدهد که از index.html در Chrome بیسر و در هر اندازه پنجره، پس از کلیکها یا سایر مراحل JavaScript، اسکرینشات میگیرد (اگر اسکریپتهای خودت را ترجیح میدهی، Playwright هم نصب است) و میتوانی هر اسکرینشات را با ابزار read ببینی. روی هر قابلیت کلیک کن، هر صفحه را با طرح مقایسه کن و تا وقتی کاملاً راضی نشدهای بهبود بده؛ سپس با خلاصه کوتاهی از آنچه ساختهای پاسخ بده.
مدل ۴ بیتی
از نسخه کوانتیزهشده ۴ بیتی GGUF مدل Inkling 2 Mini (IQ4_NL) میخواهیم برای یک سرویس SaaS به نام plant therapy وبسایتی بسازد که در آن گیاهان آپارتمانی به درمانگرهای دارای مجوز وصل میشوند.
مدل کاملاً خودمختار عمل میکند؛ SVGهای تصاویر وبسایت را خودش ساخته و حتی منطق تطبیق را هم پیاده کرده است، همه از یک درخواست کوتاه: «میشه برای SaaS من به نام plant therapy یه وبسایت بسازی که توش گیاهان آپارتمانی رو به درمانگرهای دارای مجوز وصل میکنم تا گیاهها نمیرن، یه HTML تکفایلی برگردون».
«خودت را به یک عامل مرورگر تبدیل کن»
Inkling 2 Mini را با عامل کدنویسی Pi جفت کردیم تا با استفاده از Helium، Chromium و Hugging Face Sandboxes خودش را به یک عامل مرورگر تبدیل کند. ردهای اجرا و فایل نهایی (که میتوان بهعنوان عامل مرورگر از آن استفاده کرد) را در این باکت گذاشتهایم.
جمعبندی
بسیار خوشحالیم که با Thinking Machines Lab همکاری کردیم تا Inkling 2 Mini را عرضه کنیم؛ مدلی میاناندازه و خوشعملکرد برای محیطهای محلی. این مدل را امتحان کنید و نظرتان را در بخش دیدگاهها برایمان بنویسید!
 سارا نادری
 نگار رضایی