 نگار رضایی
هرس مرتبه بالای کارشناسان (HOPE) در مدلهای زبانی ترکیبخبرگان
مقدمه
مدلهای ترکیبخبرگان (Mixture-of-Experts یا MoE) امکان مقیاسپذیری مدلهای زبانی بزرگ پیشرو تا صدها میلیارد پارامتر را فراهم کردهاند، اما یک اشکال بنیادی و پرهزینه هم دارند: هر شبکه MLP کارشناس باید در زمان استنتاج حافظه اشغال کند، حتی اگر برای هر توکن مشخص، اکثریت قاطع آنها بیکار بمانند. برای نمونه، Qwen3.5-122B در هر یک از ۴۸ لایه MoE خود ۲۵۶ کارشناس دارد و ۹۵٪ از ردپای حافظه پارامتری حدود ۲۵۰ گیگابایتی آن صرفاً به همین MLPهای کارشناس اختصاص دارد. با این حال، برای هر توکن، تنها ۸ کارشناس در هر لایه واقعاً استفاده میشوند.
هرس کارشناسان یکی از مستقیمترین راهحلها برای این گلوگاه حافظه است؛ یعنی حذف دائمی کمفایدهترین کارشناسان. هرس از مشکلات تأخیری که بارگذاری و تخلیه پویای کارشناسان را غیرعملی میکند پرهیز میکند، به هیچ آموزشی نیاز ندارد و با کوانتیزهسازی هم قابل ترکیب است. با این مزیتهای جذاب و سادگی ایده، بهراحتی میتوان فهمید چرا هرس کارشناسان به روشی پیشفرض برای کوچککردن MoEها تبدیل شده است. دشواری کار در تصمیمگیری درباره این است که کدام کارشناسان با کمترین خطر حذف شوند.
روشهای هرس موجود هر کارشناس را مستقل امتیازدهی میکنند: به هر کارشناس یک امتیاز اهمیت اسکالر میدهند (بر پایه یک مجموعه داده کالیبراسیون) و کماهمیتترین کارشناسان را (در هر لایه بهصورت مستقل) حذف میکنند. اینها روشهای مرتبه اول هستند، چون فرض میکنند سهم هر کارشناس مستقل از بقیه است. در واقعیت، کارشناسان گروههای همکار تشکیل میدهند. ما در آزمایشهای خود خوشههای پایداری از کارشناسان همفعال مشاهده کردیم و کارهای مستقل دیگر هم نشان دادهاند که همکاری کارشناسان ویژگی پایداری در MoEهاست و برای عملکرد مدل اهمیت دارد. نادیدهگرفتن این تعاملات به هرسی غیربهینه میانجامد، بهویژه در نرخهای تهاجمی.
تازهترین مقاله ما روش HOPE (هرس مرتبه بالای کارشناسان) را معرفی میکند؛ روشی مرتبه دوم که تعاملات جفتی کارشناسان را در نظر میگیرد. در هرس ۵۰٪، HOPE بهترین میانگین رتبه را میان همه روشها به دست میآورد و در وظایف کدنویسی عاملی تا +۶٫۱٪ نسبت به روش هرس بعدی بهتر عمل میکند.
در این مطلب توضیح میدهیم HOPE چگونه کار میکند، نشان میدهیم کجا از روشهای موجود بهتر عمل میکند و مرور میکنیم که چگونه میتوانید آن را برای مدلهای خودتان به کار ببرید. خوانندگانی که با معماری MoE آشنا نیستند، میتوانند مطلب «ترکیبخبرگان (MoE) در ترنسفورمرها» را ببینند.
کارشناسان تنها کار نمیکنند
در یک MoE استاندارد، هر لایه E کارشناس دارد و هر توکن ورودی x بهصورت مستقل به K کارشناس از این کارشناسان مسیریابی میشود (K = 8 یک انتخاب معمول است). مسیریابی را یک لایه واحد انجام میدهد که وزنهای گیت نرمالشده با softmax، یعنی g_k(x)، را برای هر کارشناس k تولید میکند؛ سپس K کارشناسی که بالاترین وزن گیت را دارند انتخاب میشوند و مجموعه فعال کارشناسان، T(x) ⊂ {1,..,E}، را میسازند. خروجی لایه آنگاه برابر است با ∑_{k∈T(x)} g_k(x) f_k(x)، که در آن f_k(x) خروجی کارشناس k برای توکن x است.
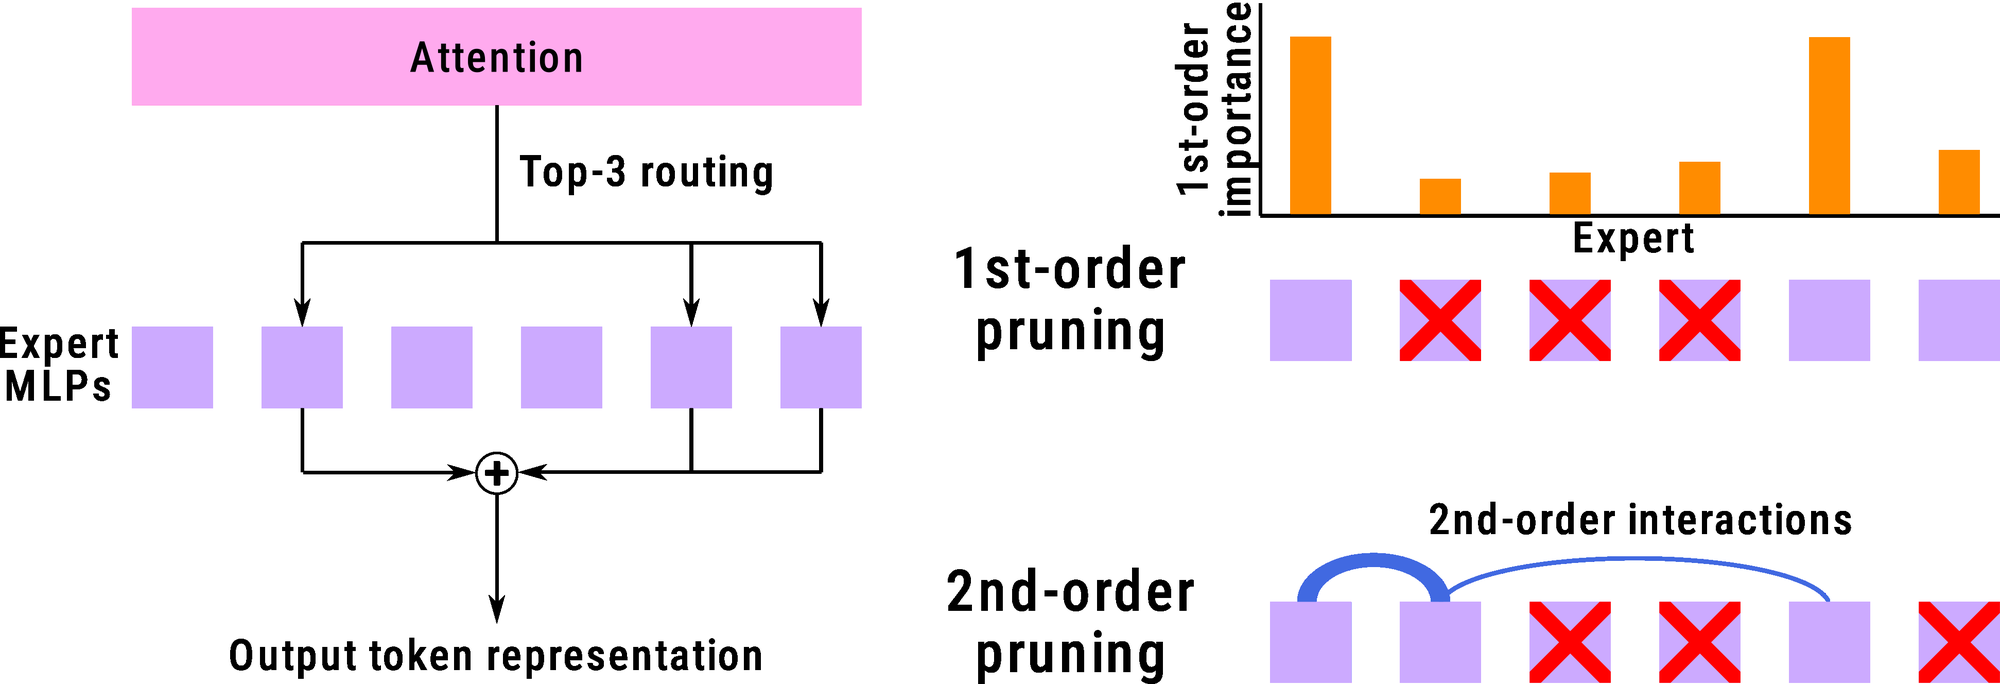
چپ: یک لایه معمول MoE که هر توکن به K کارشناس برتر مسیریابی میشود. راست: روشهای مرتبه اول کارشناسان را بر پایه یک امتیاز اهمیت اسکالر رتبهبندی و حذف میکنند، اما بهترین تصمیمهای هرس قدرت تعامل میان کارشناسان را هم در نظر میگیرند.
نکته مهم این است که کارشناسان در مجموعه انتخابشده T(x) مستقل از هم نیستند. کارشناسان گروههای همکار پایداری تشکیل میدهند که پیوسته با هم فعال میشوند. این موضوع پیشتر در ادبیات هم مشاهده شده است: الگوهای انتخاب همزمان کارشناسان در اوایل آموزش پدیدار میشوند و در ادامه تثبیت میشوند.
این یعنی وقتی کارشناسانی را از یک لایه MoE هرس میکنیم، تصمیمهای هرس باید اثرهای مرتبه بالاتر میان این کارشناسان را در نظر بگیرند. حذف کارشناس A بهتنهایی ممکن است بیاشکال به نظر برسد، اما اگر کارشناس B که اغلب با A همکاری میکند و به آن وابسته است اهمیت زیادی داشته باشد، حذف A با همین یک حذف، یک گروه همکار را از هم میپاشد. روشهای مرتبه اول این نکته را کاملاً از دست میدهند، چون A و B را جداگانه امتیازدهی میکنند.
این اثر در نرخهای هرس بالا تشدید میشود. وقتی تا ۵۰٪ کارشناسان را حذف میکنیم، خطر شکستن بسیاری از پیوندهای همکاری را داریم. اینجا همان جایی است که هرس مرتبه دوم بیشترین سود را دارد.
HOPE چگونه مجموعه هرس را مشخص میکند
(برای استخراج کامل تابع هدف HOPE به پیوست A در مقاله مربوطه مراجعه کنید)
وقتی مجموعهای از P کارشناس را از یک لایه MoE حذف میکنیم، مجموعه کارشناسان انتخابشده T(x) (برای هر توکن x) میتواند تغییر کند. کارشناسان هرسشدهای که در غیر این صورت انتخاب میشدند، با کارشناسانی جایگزین میشوند که بالاترین وزن گیت بعدی را دارند. تغییر حاصل در خروجی لایه همان خطای هرس است. هدف ما یافتن مجموعه هرس P (با بودجه هرس از پیش تعیینشده |P|) است که خطای هرس حاصل را (روی توکنهای x از مجموعه کالیبراسیون) کمینه کند.
متأسفانه کمینهکردن مستقیم خطای هرس روی P عملاً حلشدنی نیست. خطای هرس به هویت کارشناسان جایگزین بستگی دارد و آنها هم به نوبه خود به خود مجموعه هرس P وابستهاند. HOPE با تعریف یک جانشین حلشدنی به نام Z از این مشکل میگذرد؛ کمیتی که بهطور اکید کران بالای مؤلفه غالب خطای هرس است:
Z = [∑_{j ∈ P∩T(x)} g_j(x)‖f_j(x)‖₂]² ≥ خطای واقعی
چون Z یک مجموع مربع است، بسط آن بهطور طبیعی جملههای متقاطع g_i(x) g_j(x) ‖f_i(x)‖₂ ‖f_j(x)‖₂ را میان جفتهای کارشناس تولید میکند. همینها جملههای تعاملی هستند که روشهای مرتبه اول دور میریزند.
برای یافتن مجموعه هرس بهینه، HOPE مقدار E[Z] را روی مجموعه کالیبراسیون کمینه میکند که میتوان آن را به شکل برنامهریزی درجه دوم (quadratic program) زیر بازنویسی کرد:
P* = argmin_p pᵀFp با شرط p ∈ {0,1}^E و ∑_{k=1}^{E} p_k = |P|
که در آن F ∈ ℝ^{E×E} چنین تعریف میشود:
F_{i,j} = (1/|X_{i,j}|) ∑_{x∈X_{i,j}} g_i(x) g_j(x) ‖f_i(x)‖₂ ‖f_j(x)‖₂، که در آن X_{i,j} = {x: i,j ∈ T(x)}
این ماتریس F روی مجموعه داده کالیبراسیون جمعآوری میشود و مجموعه هرس بهینه با حل برنامهریزی درجه دوم حاصل (با یک آسودهسازی پیوسته و سپس گردکردن به جوابهای دودویی) به دست میآید. هر درایه F_{i,j} میانگین حاصلضرب خروجی وزندار با گیت کارشناسان i و j را در توکنهایی نشان میدهد که هر دو با هم فعالاند. در حالی که قطر F_{k,k} اهمیت فردی کارشناس را میسنجد، درایههای خارج از قطر (F_{i,j} برای i ≠ j) سهم همکاری جفتی را اندازه میگیرند.
ماتریس F در عمل چه شکلی است؟ ساختار همکاری کارشناسان را نشان میدهد که به لایه بستگی دارد:
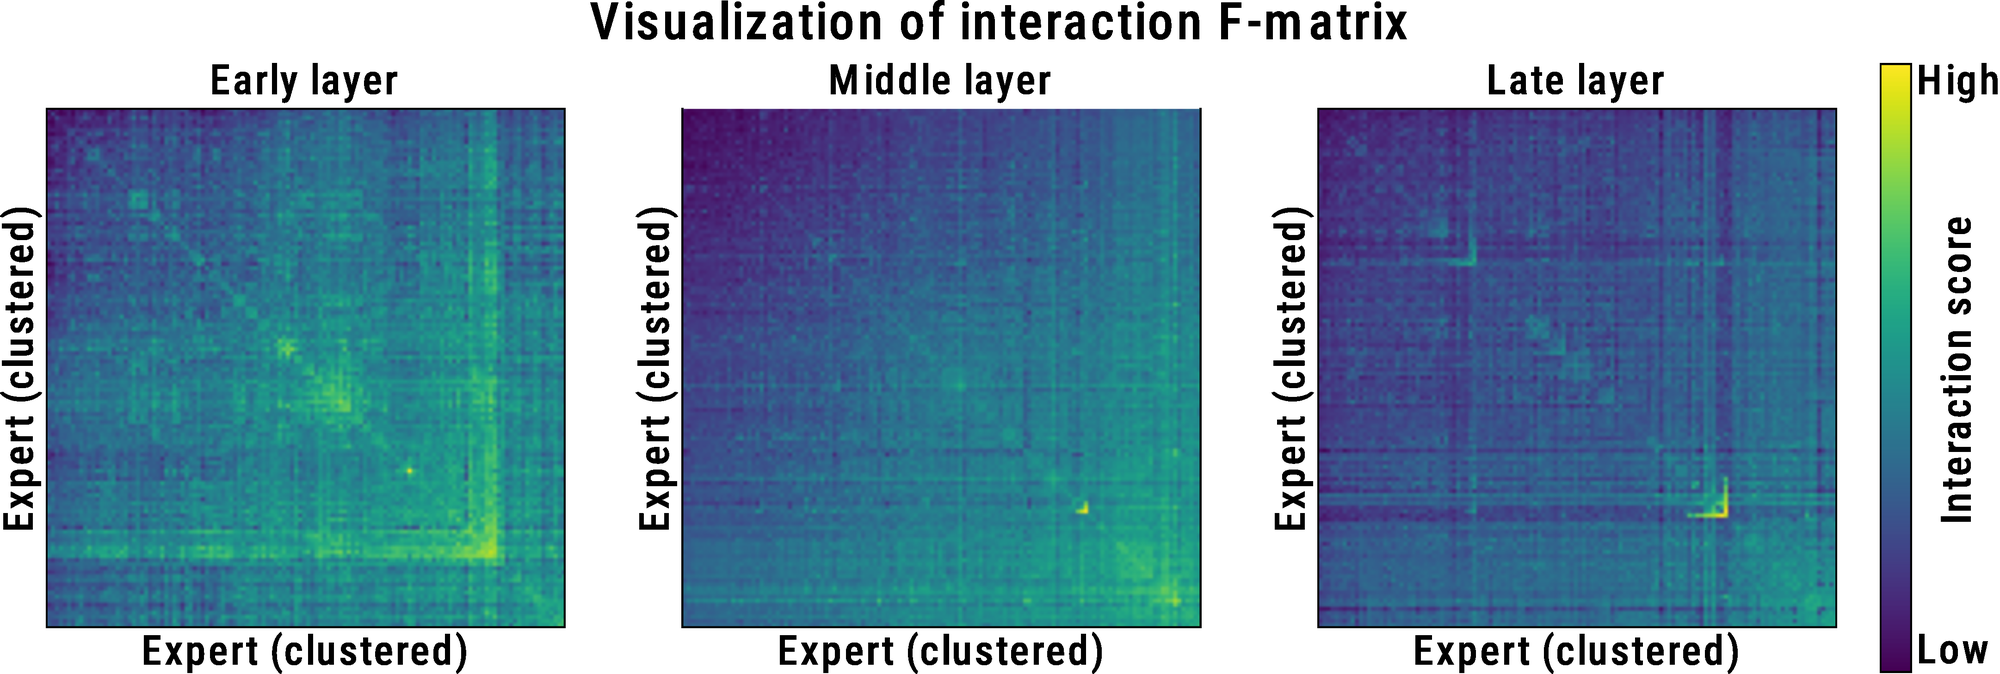
مصورسازی ماتریس تعامل F برای GLM-4.5-Air (۱۲۸ کارشناس در هر لایه، در مجموع ۱۰۶ میلیارد پارامتر) در سه لایه نمونه (ابتدایی، میانی، انتهایی). کارشناسان خوشهبندی شدهاند تا ساختار بلوکی آشکار شود. بلوکهای روشن روی قطر نشاندهنده گروههایی از کارشناسان با امتیاز تعامل جفتی قوی هستند.
از نظر هزینه عملی، HOPE همان یک بار کالیبراسیون هر روش هرس کارشناس دیگر را لازم دارد (یک گذر رو به جلو روی داده کالیبراسیون). تنها افزوده آن حل برنامهریزی درجه دوم است که محدب نیست، اما میتوان آن را با یک حلکننده استاندارد QP بهطور کارآمد حل کرد (۱ تا ۲ ثانیه برای هر لایه). سرباز اضافی کل در مقایسه با روشهای مرتبه اول ناچیز است، چون زمان کالیبراسیون غالب است.
ارتباط با REAP
نکته قابل توجه این است که HOPE پیوند محکمی با REAP (هرس فعالسازی کارشناسان با وزندهی مسیریاب)، یک روش پیشروی هرس کارشناسان از نوع مرتبه اول، دارد. ماتریس F در HOPE امتیازهای اهمیت فردی کارشناسان را روی قطر خود دارد و همین قطر در عمل همان امتیازهایی را بازمییابد که REAP برای رتبهبندی مستقل کارشناسان جهت هرس به کار میبرد (تنها تفاوت در واریانس سهم کارشناسان است). قطر F رتبهبندی کارشناسان در REAP را تقریباً بهطور کامل بازمییابد (ρ اسپیرمن = ۰٫۹۸۸). بنابراین هر بهبودی که HOPE نسبت به REAP به دست میآورد، به جملههای تعامل مرتبه دوم در درایههای خارج از قطر ماتریس F نسبت داده میشود.
نتایج
ما HOPE را بهعنوان یک روش هرس کارشناسان روی ۳ مدل (Qwen3.5-122B، Qwen3.5-35B و GLM-4.5-Air) و با ۲ مجموعه داده کالیبراسیون (Evol-CodeAlpaca و SWE-Bench Verified trajectories) ارزیابی کردیم. برای آزمودن مدلهای هرسشده حاصل، از مجموعه Tulu3 و SWE-Bench Pro (کدنویسی عاملی) استفاده کردیم و HOPE را با ۴ خط پایه مرتبه اول (REAP، MAN، EAN و Frequency) در نرخهای هرس از ۱۰٪ تا ۵۰٪ مقایسه کردیم.
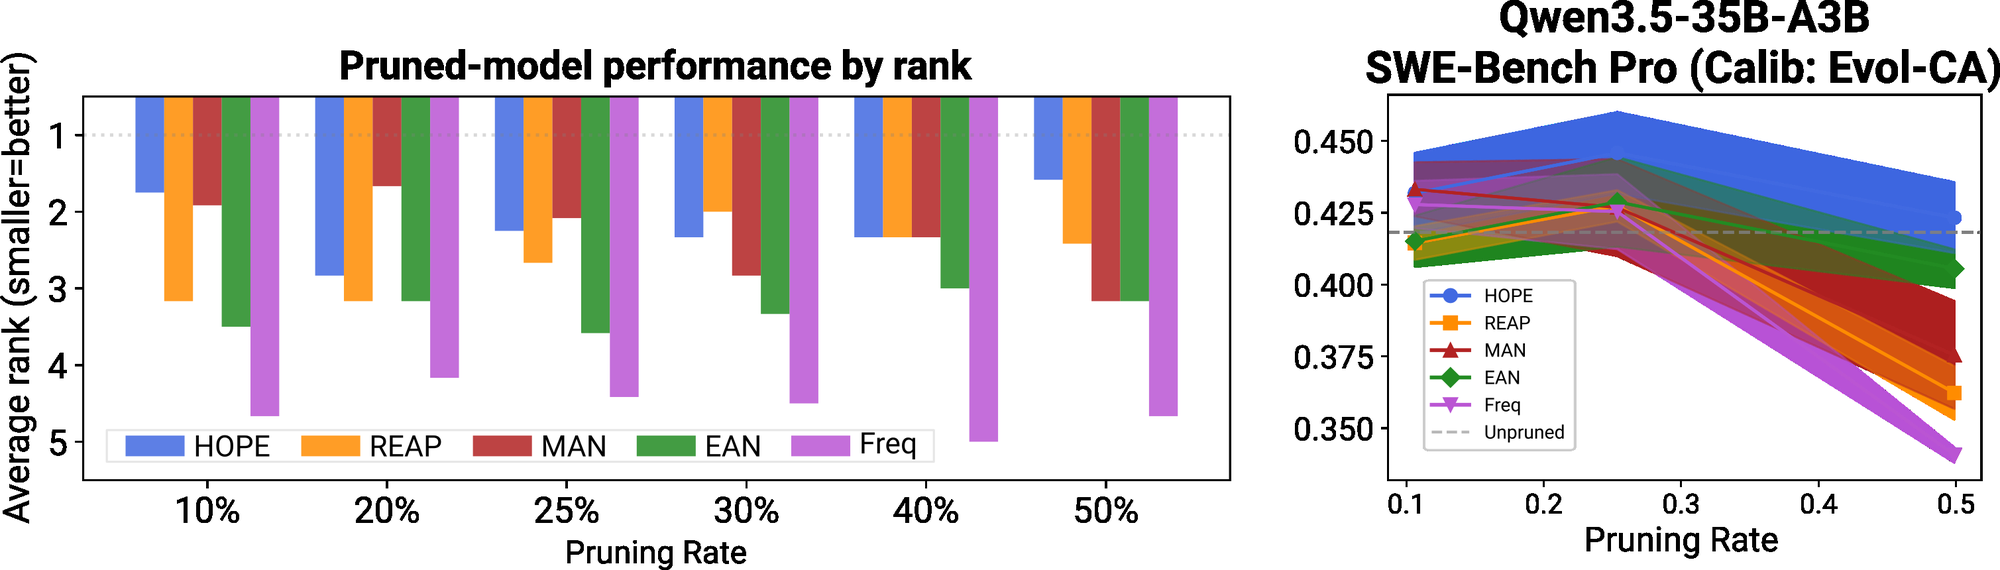
HOPE در همه شرایط بهترین رتبه کلی را به دست میآورد و در نرخهای هرس تهاجمی غالب است. چپ: میانگین رتبه (کمتر بهتر است) در همه مدلها، مجموعههای کالیبراسیون و بنچمارکها. راست: عملکرد SWE-Bench Pro روی Qwen3.5-35B.
در همه شرایط، HOPE بهترین میانگین رتبه را کسب کرد (۲٫۰۷ از ۵ روش)، با بالاترین نرخ قرارگرفتن در جایگاه اول (۳۹٪ شرایط) و جایگاه دوم (۶۷٪). در مقایسه رو در رو، HOPE در اکثر شرایط از هر خط پایه دیگری بهتر عمل میکند.
همانطور که انتظار میرفت، مزیت HOPE در نرخهای هرس بالاتر بیشتر میشود. هرچه کارشناسان بیشتری حذف شوند، پیوندهای همکاری بیشتری شکسته میشود و جملههای خارج از قطر F اهمیت بیشتری پیدا میکنند. در هرس ۵۰٪، میانگین رتبه HOPE به ۱٫۵۸ بهبود مییابد (در مقابل ۲٫۴۲ برای روش بعدی، REAP). این همچنین مرتبطترین حالت با استقرار در عمل است، جایی که صرفهجویی حافظه بهقدری زیاد است که زمینههای طولانیتر، استدلال عمیقتر و فراخوانی ابزارهای بیشتر را ممکن میکند.
مزیت HOPE بیشترین نمود را در SWE-Bench Pro دارد؛ بنچمارکی برای کدنویسی عاملی که در آن مدلها باید مسائل واقعی GitHub را بهطور مستقل حل کنند. این مسائل شامل وظایف متنوع از نظر ترکیب (مثلاً کدنویسی، فراخوانی ابزار، استدلال و غیره) در طول نوبتهای متعدد است و احتمالاً ترکیبهای متنوعی از کارشناسان را به کار میگیرد؛ دقیقاً همان حالتی که حفظ ساختار همکاری در آن بیشترین اهمیت را دارد. روی Qwen3.5-35B-A3B با هرس ۵۰٪، HOPE در SWE-Bench Pro به ۴۲٫۳ رسید و با ۴۱٫۸ مدل هرسنشده همتراز شد (در حالی که REAP به ۳۶٫۲ افت کرد، یعنی ۱۳٪ پسرفت).
نکته قابل توجه این است که مدلهای هرسشده گاهی میتوانند با خط پایه هرسنشده برابر یا از آن بهتر شوند؛ احتمالاً چون حذف کارشناسان کممرتبط، نویز را در وظایف هدف کاهش میدهد. این اثر مخصوص HOPE نیست و در روشهای مختلف هرس مشاهده شده است. افزون بر این، آزمایشهای ما نشان داد کالیبراسیون متمرکز بر کد با هر روش هرسی (از جمله HOPE) بنچمارکهای غیرکدنویسی را بهشدت تضعیف نکرد و HOPE در کل مجموعه Tulu3، مستقل از مجموعه کالیبراسیون، خوب عمل کرد.
HOPE کارشناسان همکار بیشتری را نگه میدارد
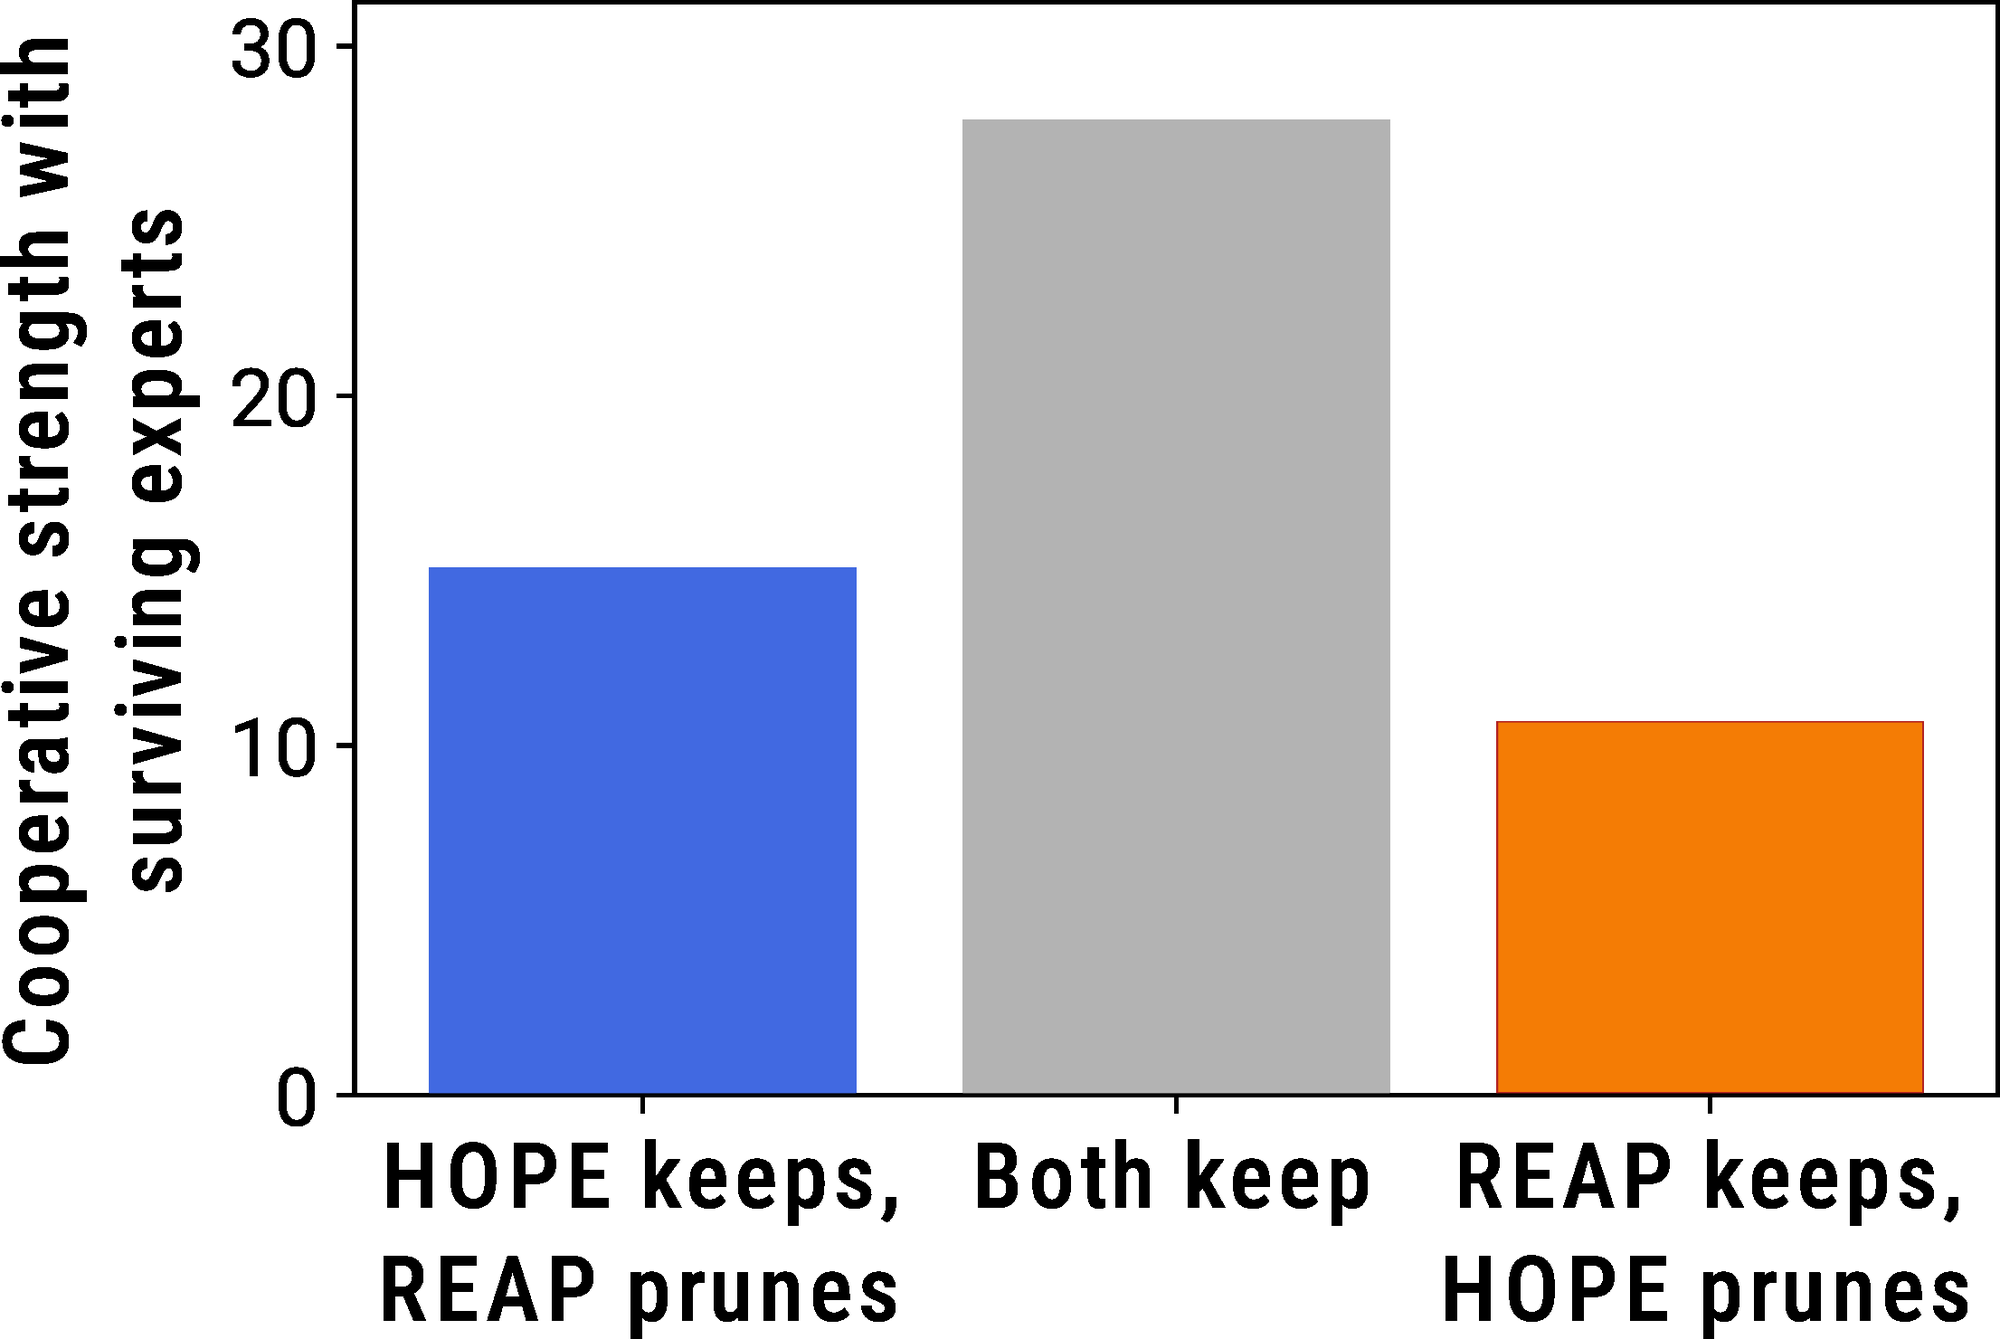
میانگین قدرت همکاری (بر پایه مقدار ماتریس F) با کارشناسان نگهداشتهشده، به تفکیک کارشناسانی که HOPE و REAP دربارهشان اختلاف دارند.
مزیت HOPE از بهینهسازی روی کل ماتریس تعامل F میآید. برای درک اینکه این موضوع در عمل چگونه بر تصمیمهای هرس اثر میگذارد، کارشناسانی را بررسی میکنیم که HOPE و REAP دربارهشان اختلاف دارند. برای هر کارشناس مورد اختلاف، امتیاز همکاری آن (یعنی میانگین مقدار F آن با دیگر کارشناسان نگهداشتهشده) را محاسبه میکنیم. کارشناسانی که فقط HOPE آنها را نگه میدارد، پیوسته امتیاز همکاری بالاتری از کارشناسانی دارند که فقط REAP نگه میدارد. به بیان دیگر، HOPE در جریان بهینهسازی QP، برخی کارشناسان با امتیاز فردی بالا را فدای حفظ خوشههای همکار میکند. بهبود عملکرد در بنچمارکها (که پیشتر نشان داده شد) تأیید میکند که این مصالحه سودمند است.
چگونه HOPE را اجرا کنیم
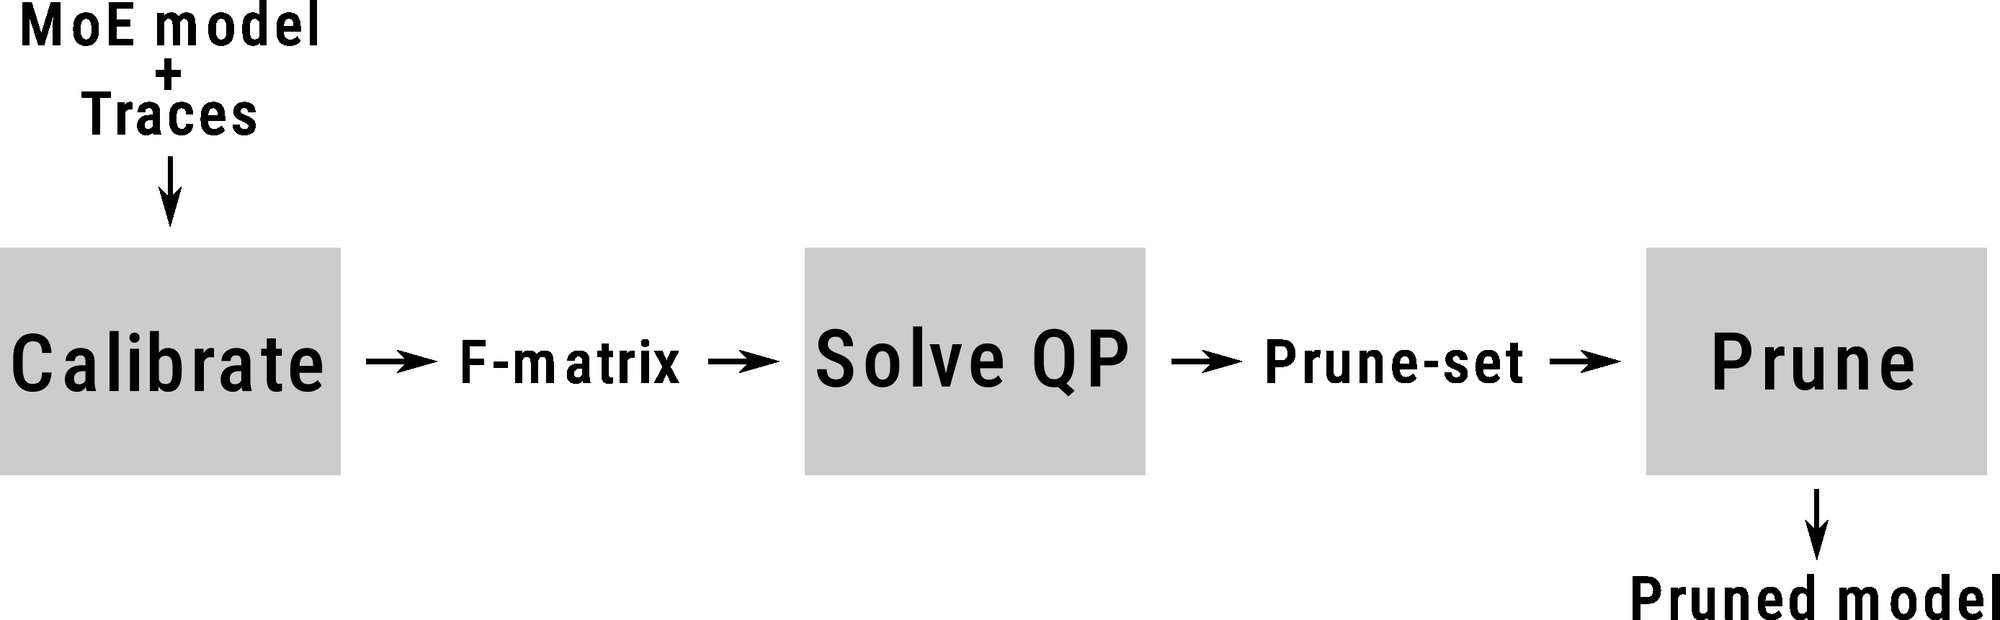
ما یک بسته پایه برای اجرای HOPE ساختیم. سه مرحله دارد: ۱) کالیبراسیون؛ ۲) حل؛ ۳) هرس. بسته ما روی Qwen3، Qwen3-Next، Qwen3.5 و GLM-4.5 آزموده شده است.
مرحله ۱: کالیبراسیون
hope calibrate \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --prompts calibration_prompts.txt \
    --out-path observations.h5
مرحله کالیبراسیون یک گذر رو به جلو روی داده کالیبراسیون اجرا میکند، چه این داده خروجیهای عاملی باشد و چه ردهای تکنوبتی. این مرحله از transformers در HuggingFace استفاده میکند تا به گذر رو به جلو هر لایه MoE جداگانه متصل شود. برای هر توکن، ثبت میکند کدام کارشناسان انتخاب شدهاند، وزنهای گیت، نرمهای خروجی و آمارههای همفعالی جفتی آنها چیست. خروجی این مرحله ماتریس F است که در یک فایل HDF5 ذخیره میشود.
مرحله ۲: حل QP
hope solve \
    --obs-path observations.h5 \
    --prune-frac 0.50 \
    --out-path pruneset.json
این فرمان ماتریس F را مادی میکند و برنامهریزی درجه دوم دودویی را با یک آسودهسازی پیوسته حل میکند. این کار چند ثانیه برای هر لایه طول میکشد و خروجی یک فایل JSON است که مجموعه هرس را در خود دارد. از نظر فنی، این خروجی نهایی الگوریتم HOPE است.
مرحله ۳: هرس
hope prune \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --pruneset-path pruneset.json \
    --out-path ./Qwen3.5-35B-A3B-pruned-50
برای تکمیل خط لوله، این فرمان را اجرا میکنیم تا در واقع چکپوینت مدل کوچکتر را از مجموعه هرس بسازیم. مدل هرسشده یک چکپوینت استاندارد HuggingFace است که هم روی دیسک و هم در حافظه کوچکتر است (نیازی به تغییر تعریف مدل در vLLM یا SGLang نیست).
ما یک API پایتونی فشردهتر هم منتشر کردیم:
from hope.calibrate import calibrate
from hope.solve import solve
from hope.prune import prune_model

calibrate("Qwen/Qwen3.5-35B-A3B", calibration_prompts, "observations.h5")
solve("observations.h5", prune_frac=0.50, out_path="pruneset.json")
prune_model("Qwen/Qwen3.5-35B-A3B", "pruneset.json", "./Qwen3.5-35B-A3B-pruned-50")محدودیتهای HOPE
مزیت HOPE بیشترین نمود را در نرخهای هرس بالاتر (۴۰ تا ۵۰٪) دارد. در نرخهای هرس پایینتر (۱۰ تا ۲۰٪)، روشهای مرتبه اول مانند REAP و MAN گاهی رقابتی هستند و مزیت HOPE کوچکتر میشود. افزون بر این، مانند بیشتر الگوریتمهای هرس کارشناسان، HOPE هر لایه را مستقل هرس میکند و تعاملات بینلایهای را در نظر نمیگیرد. در مقاله ما چارچوبی نظری برای HOPE بینلایهای ارائه شد، اما نتایج آن مقدماتی است. در نهایت، HOPE تعاملات جفتی را میگیرد، اما تعاملات حتی مرتبه بالاتر (سهتاییها و فراتر) هم میتوانند سیگنال بیشتری فراهم کنند، هرچند برآورد آنها از نظر ترکیبیاتی دشوار است.
اطلاعات بیشتر
برای اطلاعات بیشتر، مقاله و مخزن کد مربوطه را ببینید.
مقاله: https://arxiv.org/abs/2609.18916
کد: https://github.com/awslabs/HOPE
برای دیدن اینکه HOPE چگونه میتواند روی معماریهای ترکیبی نسل بعدی به کار رود، مخزن مربوطه ما را ببینید.
ارجاع:
@article{tseng2026hope,
    title={Higher-Order Pruning of Experts in Mixture-of-Experts Language Models},
    author={Tseng, Alex M. and Kaul, Prannay and Zancato, Luca and Xia, Wei and Soatto, Stefano},
    journal={arXiv preprint arXiv:2609.18916},
    year={2026},
}
 سارا نادری
 آرمان کریمی