 سارا نادری
ترکیب یادگیری تقویتی روی توزیع وظیفه سفارشی با هارنس عامل دلخواهتان، مدلهایی دقیقتر و کممصرفتر برای همان هارنس و همان توزیع وظیفه به دست میدهد.
مدلها برای همه هارنسها و همه کارهایی که شما انجام میدهید بهینه نشدهاند و هدفشان عملکرد عمومی است. بنابراین وقتی یک مدل و یک هارنس را کنار هم میگذارید، برای کاری که واقعاً انجام میدهید، بخشی از عملکرد و کارایی را هدر میدهید. با یادگیری تقویتی میتوانید یک آداپتر هارنس سفارشی آموزش دهید که بیشترین بهره را از مدلتان برای ترکیب هارنس و وظیفه شما بیرون بکشد.
مدل Qwen3.8-27B را در نظر بگیرید: امتیازش در بنچمارک Terminal-Bench 2.1 با هارنس Pi برابر ۳۹٪ است و بهطور میانگین برای هر وظیفه ۲٫۹ هزار توکن مصرف میکند. اگر وزنهای این مدل را ثابت نگه داریم و یک آداپتر LoRA آموزشدیده با یادگیری تقویتی به آن اضافه کنیم، به pass@1 برابر ۵۵٪ میرسیم و میانگین مصرف توکن به ۱٫۵ هزار کاهش مییابد. بیشتر این بهبود به این برمیگردد که مدل کمتر استدلال میکند، ابزار کمتری فراخوانی میکند و بار اول بهتر عمل میکند.
کارهای پیشین ما (یادگیری تقویتی چندهارنسی و آداپترهای هارنس) نشان داد که یادگیری تقویتی روی توزیع وظیفه خودتان و داخل هارنس خودتان، مدلی دقیقتر و کممصرفتر به دست میدهد. آن آزمایشها وظایف تحلیل داده و ساخت کد را پوشش میدادند. اینجا میخواستیم این موضوع را جلوتر ببریم و بررسی کنیم آیا این نتیجه در مقیاس ۲۷ میلیارد پارامتر، روی وظایف سختتر و واقعی مهندسی نرمافزار و در سه هارنس Pi، OpenCode و Hermes Agent هم برقرار میماند یا نه. و مهمتر از همه، یک دستور کار کاملاً قابل استفاده مجدد منتشر کنیم تا خودتان بتوانید آن را روی ترکیب وظیفه، هارنس و مدل خودتان بازتولید کنید.
خلاصه
برای مدل Qwen3.8-27B به ازای هر هارنس عامل (Pi، Hermes Agent و OpenCode) یک آداپتر LoRA آموزش دادیم، با یادگیری تقویتی داخل خود هارنس.
دادهها، آموزش و رولاوتهای عامل همه روی Hub و در Jobs انجام میشوند، با AsyncGRPOTrainer از کتابخانه TRL، OpenEnv و Harbor.
هر آداپتر هارنس، مدل پایه را زیر هارنس خودش و در هر دو بنچمارک شکست میدهد؛ هم از نظر عملکرد و هم از نظر کارایی.
سه LoRA همچنین در یک سوپرآداپتر واحد ادغام شدهاند که بدون تغییر زیر Pi، Hermes Agent و OpenCode اجرا میشود.
همه خروجیها (آداپترها، فایلهای GGUF، وظایف RL و افزونه safeagents) را میتوانید از طریق این مجموعه در Hugging Face ببینید.
فهرست مطالب
آموزش داخل هارنسهای عامل
تولید وظایف RL سفارشی در Hugging Face
آزمودن فیلترها با اجراهای کوتاه آموزش
AsyncGRPOTrainer برای آموزش کارآمدتر GRPO
تنظیمات آموزش
سوپرآداپتر: ادغام همه آداپترها در یکی
نتایج نهایی
پرسش باز: مدل واقعاً چه چیزی یاد گرفت؟
سخن پایانی و مسیرهای آینده
آموزش داخل هارنسهای عامل
ما از یکپارچگی Harbor در OpenEnv و راهنمای OpenEnv در TRL استفاده میکنیم تا مدل را داخل همان هارنسهایی آموزش دهیم که برای آموزش نهایی انتخاب کردیم. برای همه وظایف RL خود ایمیجهای داکر آمادهای ساختهایم که هارنسهای هدف از پیش داخلشان نصب شدهاند. در ایمیجهای داکر نهایی از Pi 1.5.2، OpenCode 2.2.7 و Hermes Agent v0.22.6 استفاده میکنیم. نمودار زیر از همان پست وبلاگ، کل این پروتکل را بهخوبی توضیح میدهد:
بیشتر چارچوبهای یادگیری تقویتی، بازپیادهسازی حلقه عامل را آموزش میدهند: عامل در برابر رابط خود چارچوب نوشته میشود، مثل AgentLoop در verl، محیطهای SkyRL-Gym، کلاسهای عامل و محیط در rLLM، توابع رولاوت سفارشی slime، یا کلاینت ART داخل عامل پایتونی خودتان. اینجا هارنس دقیقاً همانطور که عرضه شده اجرا میشود و آموزشدهنده از همان توکنهایی یاد میگیرد که هارنس تولید کرده و یک پراکسی میان هارنس و vLLM آنها را ثبت میکند. کارهای اخیر هم در همین جهت حرکت میکنند: Agent Lightning v1.0 هارنس زمان استقرار را از طریق یک پراکسی در حلقه نگه میدارد («یادگیری تقویتی عامل با هارنس») و یکپارچگی Harbor در SkyRL روی آزمونهای Harbor آموزش میدهد و تاریخچه چت آنها را به توکن برای آموزشدهنده تبدیل میکند.
تولید وظایف RL سفارشی در Hugging Face
برای این دستور کار، یک دیتاست سفارشی برای عامل کدنویسی با Hub، OpenEnv و Repo2RLEnv ساختیم. بازیابی وظایف از محیطهای RL موجود، تولید وظیفه با Repo2RLEnv، اعتبارسنجی وظیفه با OpenEnv و نمونهگیری را در یک خط لوله داده واحد ترکیب کردیم. نتیجه، مجموعهای با بالاترین کیفیت از وظایف اعتبارسنجیشده و مرتبط بود تا Qwen3.8-27B را در عامل کدنویسی بهبود دهد. در این بخش مرور میکنیم که چطور آن را ساختیم تا شما هم بتوانید آن را در حوزههای خودتان امتحان کنید.
آموزش RL به وظایفی نیاز دارد که عامل بتواند روی آنها تلاش کند، یک ارزیاب که هر تلاش را نمره بدهد و شواهدی که نشان دهد ارزیاب درست عمل میکند. ارزیابی که پاسخهای غلط را قبول کند، رفتار غلط را یاد میدهد. وظیفهای که از قبل قابل حل باشد هم چیزی به مدل یاد نمیدهد.
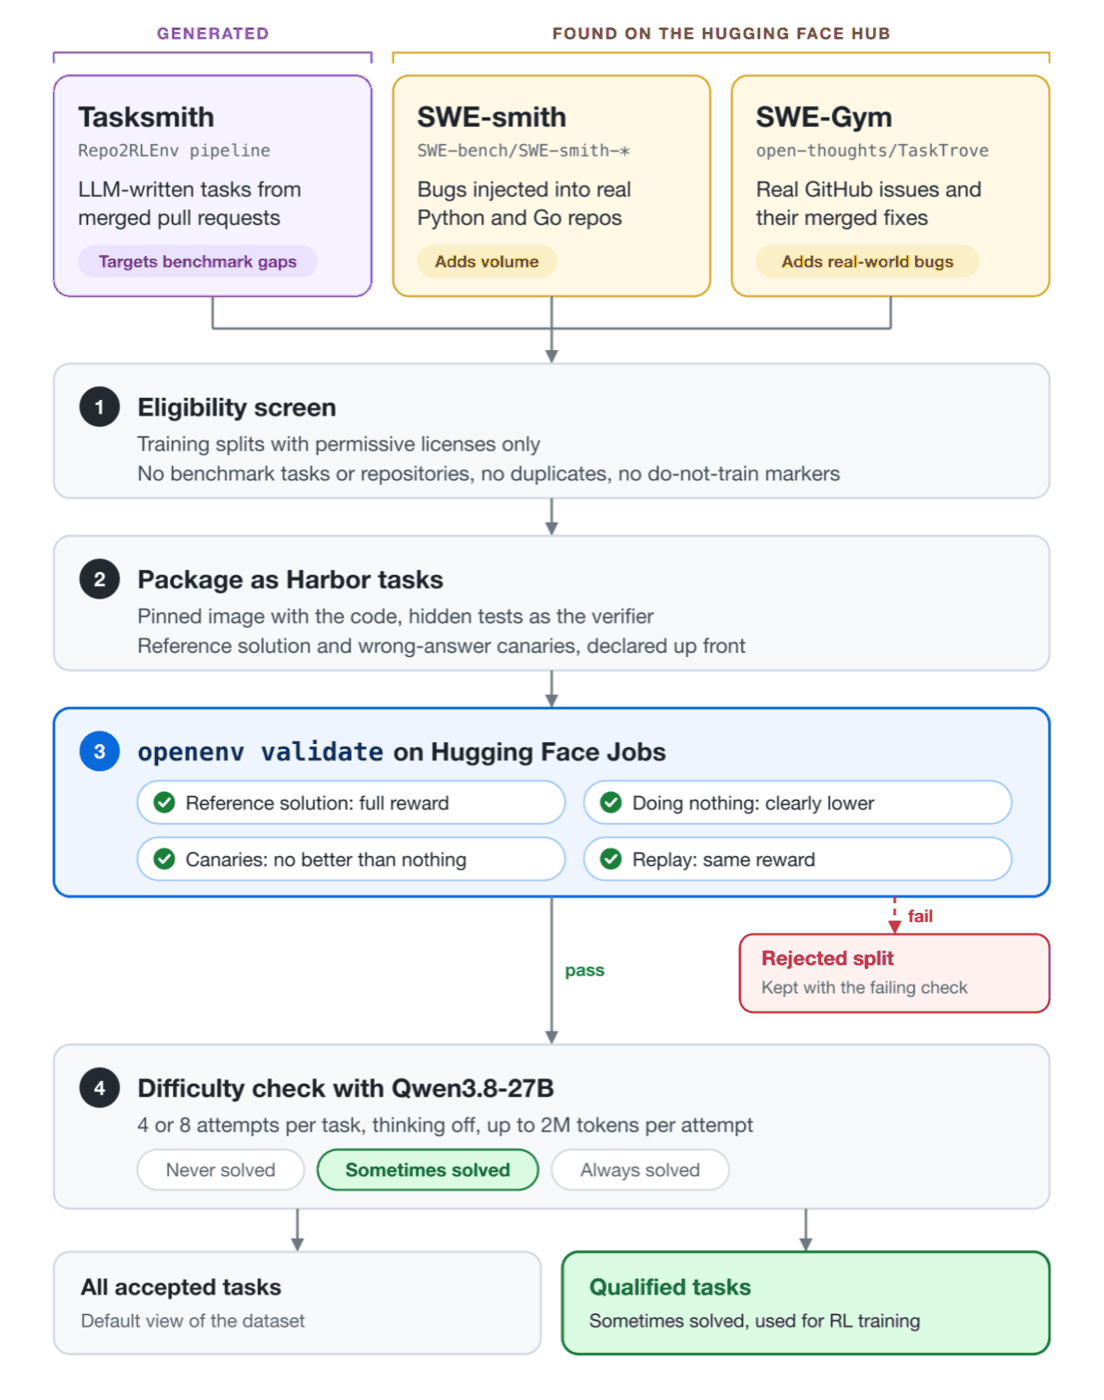
این بخش توضیح میدهد که مجموعه وظایف را از سه منبع ساختیم: دو منبع روی Hugging Face Hub و منبع سومی که با Tasksmith، یک خط لوله در Repo2RLEnv، تولید شد. هر وظیفه از یک غربال واجد شرایط بودن با openenv validate و همان بررسی دشواری در برابر مدل پایه، Qwen3.8-27B، عبور میکند.
سه منبع
هر وظیفه از قالب Harbor استفاده میکند که Terminal-Bench 2.1 هم از آن استفاده میکند. جستوجوی گسترده در Hub برای محیطهای Harbor حدود ۵۹٬۰۰۰ وظیفه برگرداند، اما اینها شامل تکراریها، مجموعههای ارزیابی و وظایف علامتخورده بهعنوان غیرقابلاستفاده برای آموزش بودند. ما فقط به دو منبع Hub که برای آموزش ساخته شده بودند محدود شدیم و مجموعه سوم را خودمان تولید کردیم:
SWE-smith (پایتون و Go) باگهایی را به مخازن واقعی پایتون و Go تزریق میکند، با بازنویسی توسط یک مدل زبانی یا یک جهش مانند وارونهکردن یک عملگر. تستهایی که هر باگ را میگیرند، تستهای همان وظیفه میشوند. این منبع حجم اضافه میکند.
SWE-Gym که در TaskTrove بهصورت وظایف Harbor بستهبندی شده، issueهای واقعی GitHub و اصلاحات ادغامشدهٔ آنها را به وظیفه تبدیل میکند. این منبع باگهای دنیای واقعی را اضافه میکند.
Tasksmith وظایف را از pull requestهای ادغامشده تولید میکند. یک عامل مدل زبانی دستورالعمل و تستها را مینویسد و Tasksmith نتیجه را بررسی میکند: راهحل مرجع و یک راهحل جایگزین معتبر باید قبول شوند، در حالی که کد اصلاحنشده و یک راهحل مشخصاً غلط باید رد شوند.
از Tasksmith برای پر کردن شکافها استفاده کردیم. مهارتهایی را که بنچمارکهای هدف ما میسنجند (Terminal-Bench 2.1، زیرمجموعهٔ سخت SWE-bench Pro و DeepSWE) نقشهبرداری کردیم و سپس pull requestهایی را انتخاب کردیم که آن مهارتها را تمرین میدهند، مثل استریم HTTP، عملیات فایلسیستم و سریالسازی. Tasksmith از ۳۰ pull request ادغامشده، ۲۴ وظیفه در ۱۰ مخزن پایتون تولید کرد که بررسیهایش را پاس کردند؛ ۱۷ مورد از آنها در اجرای دوم. بررسیهای Tasksmith جای بررسیهای ما را نمیگیرند، بنابراین این وظایف هم مثل بقیه از همان خط لوله عبور میکنند.
اعتبارسنجی با openenv validate
ابتدا یک غربال فراداده اجرا میشود. وظایفی را نگه میدارد که از بخشهای آموزش با مجوزهای آزاد آمدهاند. تکراریها، وظایف علامتخورده بهعنوان غیرقابلاستفاده برای آموزش، ۲۵۳ وظیفهٔ بنچمارکهای هدف ما و هر وظیفهای از مخزنی که این بنچمارکها استفاده میکنند را حذف میکند. سپس بررسیهای معنایی openenv validate را روی هر وظیفه در آزمونهای تازه اجرا کردیم:
راهحل مرجع حداکثر پاداش را میگیرد (semantic.oracle_max).
انجامندادن هیچ کاری بهطور واضح امتیاز کمتری میگیرد (semantic.floor_gap).
هیچ canary امتیازی بیشتر از انجامندادن هیچ کاری نمیگیرد (semantic.canary_floor).
بازپخش راهحل مرجع همان پاداش را میدهد (runtime.episode_determinism).
هر آزمون بهصورت یک Job جداگانه در Hugging Face اجرا شد که به ما اجازه داد دهها وظیفه را همزمان اعتبارسنجی کنیم. openenv validate همین گزینه را برای هر وظیفهٔ Harbor ارائه میدهد:
openenv validate path/to/task --sandbox hf-sandbox۸۵۸ وظیفه از ۱٬۱۲۷ نامزد Hub قبول شدند. کنترلهای پاسخ غلط نقصها را گرفتند، از جمله یک وظیفهٔ Tasksmith که یک پیادهسازی ناقص را قبول میکرد و یک ارزیاب Terminal-Bench 2.1 (regex-log) که پاسخهای مشخصاً غلط را قبول میکرد. بیشتر شکستها مشکلات زیرساختی بودند، مثل ایمیجهایی که بالا نمیآمدند. وظایف ردشده در یک بخش ردشده با ثبت بررسی ناموفق باقی میمانند.
بررسی دشواری با مدل پایه
یک وظیفهٔ معتبر هم میتواند هیچ چیزی یاد ندهد. GRPO (بهینهسازی سیاست نسبی گروهی) هر تلاش را نسبت به تلاشهای دیگر همان وظیفه میسنجد، بنابراین وظیفهای که همهٔ تلاشها در آن قبول میشوند یا همه شکست میخورند، هیچ سیگنال یادگیری نمیدهد. پیش از آموزش، Qwen3.8-27B هر وظیفه را ۴ بار امتحان کرد، یا ۸ بار برای یک نمونهٔ طبقهبندیشده شامل شش وظیفه از هر مخزن.
از ۴۴۲ وظیفهٔ نمرهخورده، Qwen3.8-27B در ۱۵۱ وظیفه هر بار موفق شد و در ۱۲۰ وظیفه هیچوقت. ۱۷۱ وظیفهای که فقط گاهی حل کرد، مجموعهٔ واجد شرایط را تشکیل میدهند. نمودار زیر نشان میدهد چطور امتیازها در دو انتها انباشته میشوند و چطور بر اساس منبع تفاوت دارند. مدل بیشتر وظایف Go را هر بار حل میکند، در بیش از یکسوم وظایف SWE-smith پایتون در همهٔ تلاشها شکست میخورد و در ۷۳٪ وظایف SWE-Gym در میانه قرار میگیرد.
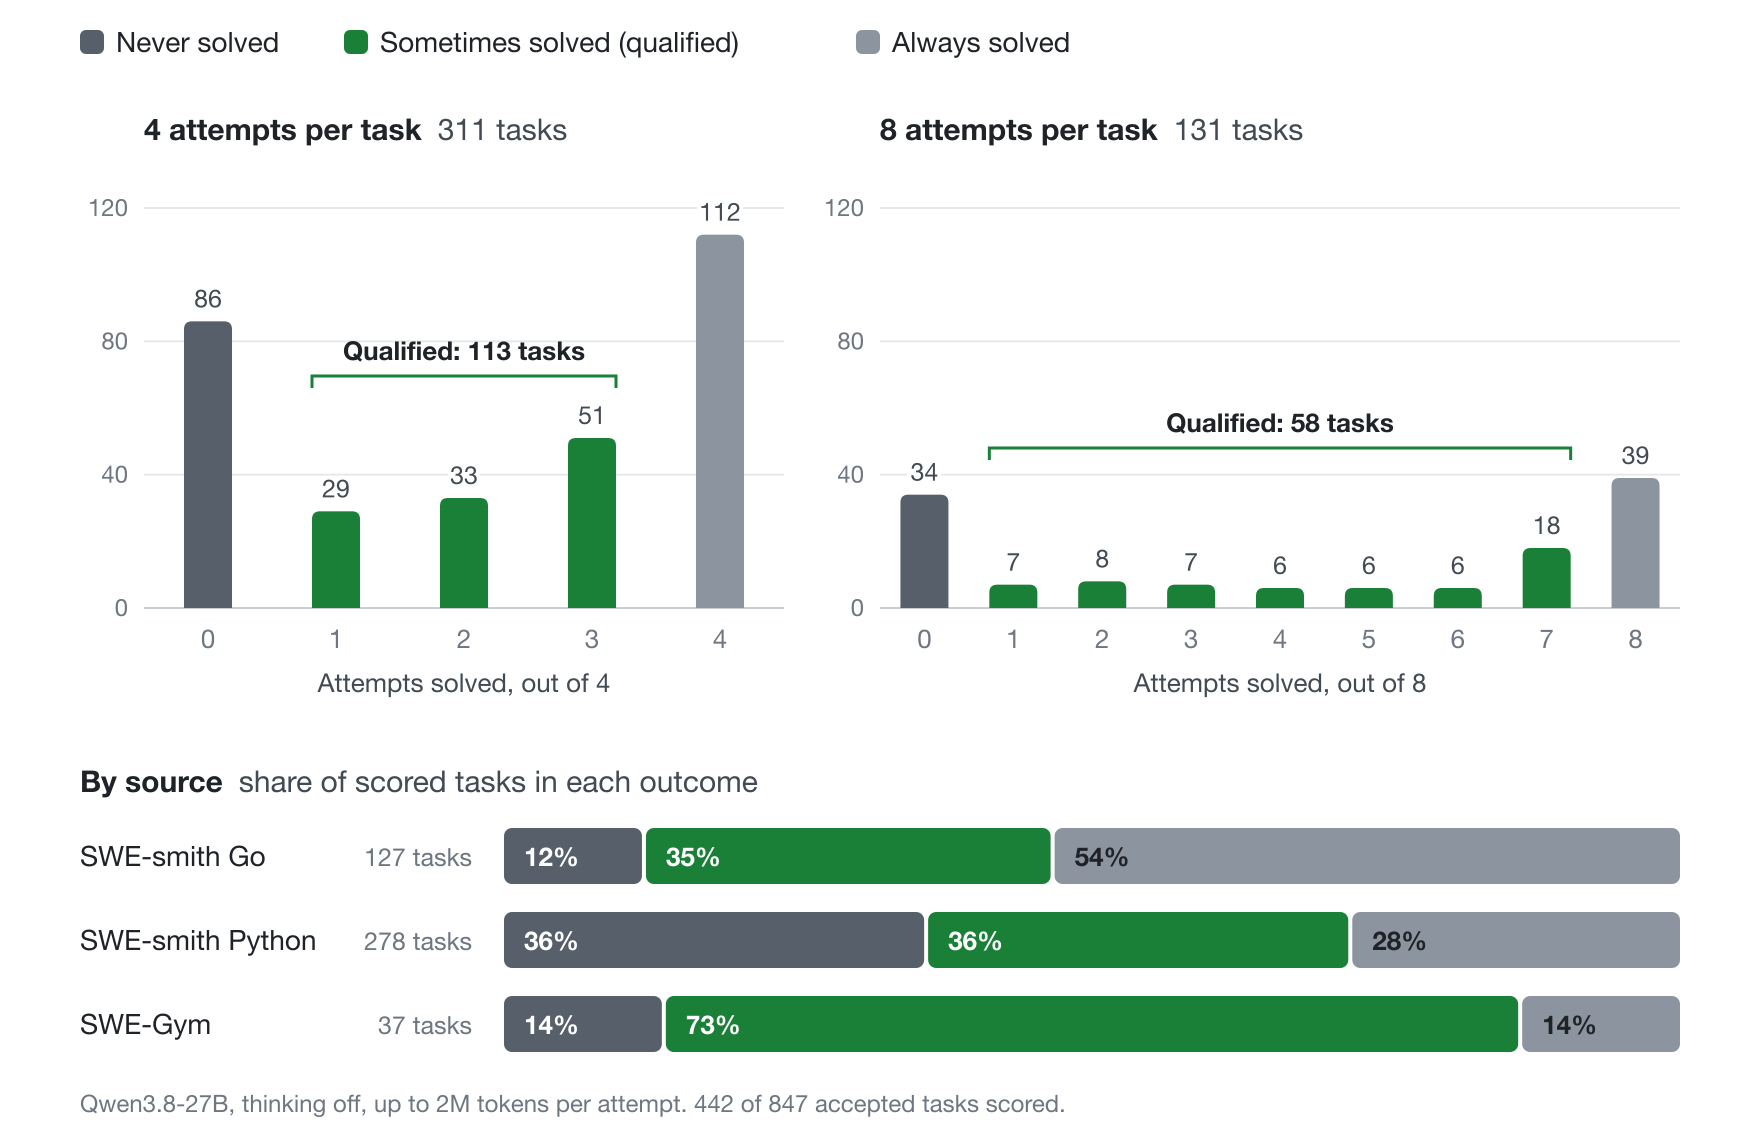
نتایج Qwen3.8-27B روی ۴۴۲ وظیفهٔ نمرهخورده. رنگ سبز وظایف واجد شرایط را نشان میدهد؛ وظایفی که مدل در برخی تلاشها حل میکند اما نه همه.
این مثال نشان میدهد چطور ۱٬۱۲۷ وظیفه را فیلتر و اعتبارسنجی کردیم تا به ۲۷۸ وظیفه رسیدیم که مستقیماً در دیتاست نهایی گنجاندیم. خط لوله سپس ۵۲۲ وظیفهٔ ردشدهٔ باقیمانده را برداشت، با Tasksmith آنها را تعمیر و پیچیدهتر کرد و اعتبارسنجی را تکرار کرد.
آزمودن فیلترها با اجراهای کوتاه آموزش
خط لوله دو فیلتر اعمال میکند: اعتبارسنجی وظایف خراب را حذف میکند و بررسی دشواری وظایفی را نگه میدارد که مدل پایه فقط گاهی حل میکند. این بخش بررسی میکند آیا این فیلترها چیزی را که مدل یاد میگیرد تغییر میدهند یا نه. چهار اجرای کوتاه تا ۵۰ گام آموزش دادیم، هر کدام روی وظایفی از یک مرحلهٔ متفاوت خط لوله، و آنها را با مدل پایه در Terminal-Bench 2.1 مقایسه کردیم.
هر اجرا Qwen3.8-27B را با LoRA و GRPO و با AsyncGRPOTrainer از TRL روی ۳۲ وظیفه آموزش میدهد. هر چهار اجرا از یک هارنس عامل یکسان (OpenCode با حداکثر ۴۸ فراخوانی مدل)، تنظیمات یکسان و یک Job 8×H200 در Hugging Face استفاده میکنند و پاداش همان قبولی یا شکست ارزیاب است. مجموعهٔ وظایف در نحوهٔ فیلترشدن تفاوت دارند:
اعتبارسنجینشده: ۲۴ وظیفهٔ قبولشده بهعلاوهٔ ۸ وظیفهای که اعتبارسنجی را رد کردند.
اعتبارسنجیشده: ۳۲ وظیفهٔ قبولشده، بدون توجه به دشواری انتخاب شدهاند.
واجد شرایط نبودن: ۳۲ وظیفهٔ قبولشده که مدل پایه همیشه یا هیچوقت حلشان میکند.
واجد شرایط: ۳۲ وظیفهٔ قبولشده که مدل پایه در برخی تلاشها حلشان میکند.
نمودار زیر نشان میدهد وظایف چطور بر یادگیری مدل اثر گذاشتند. جدول گامهای هر اجرا و چکپوینتی را که ارزیابی میکنیم فهرست میکند. نمودار پاداش آموزش را در زیرمجموعههای وظایف با وضعیت اعتبارسنجی متفاوت دنبال میکند.
دیتاست
دیتاست harness-hub/agentic-coding-envs شامل ۸۷۱ وظیفه از ۳۵ مخزن است. وظایف Hub حداکثر ۴۰ مورد در هر مخزن هستند تا هیچ پروژهای غالب نشود. جدول زیر نشان میدهد هر منبع چه سهمی دارد. دیتاست دو نما دارد: همهٔ وظایف قبولشده و زیرمجموعهٔ واجد شرایط برای آموزش GRPO. تلاشهای ردشده در یک پیکربندی جداگانه باقی میمانند.
منبع | نوع وظیفه | تعداد وظایف | واجد شرایط
SWE-smith | باگهای تزریقشده در پایتون و Go | ۷۱۷ | ۱۴۴
SWE-Gym (TaskTrove) | issueهای واقعی GitHub | ۱۳۰ | ۲۷
Tasksmith | تولیدشده از pull requestهای ادغامشده | ۲۴ | ۲۲
مجموع | | ۸۷۱ | ۱۷۱
AsyncGRPOTrainer برای آموزش کارآمدتر GRPO
از نسخه پایدار AsyncGRPOTrainer در TRL استفاده کردیم. مزیت اصلی این آموزشدهنده آن است که پیش از رفتن به گام بهینهسازی بعدی، منتظر پایان همه رولاوتها نمیماند.
برای مطالعه دقیقتر درباره این آموزشدهنده و اجزای سازندهاش، به پست وبلاگ AsyncGRPO مراجعه کنید.
تنظیمات آموزش
برای به دست آوردن آداپترهای هارنس نهایی، آداپترهای LoRA را روی Qwen/Qwen3.8-27B با AsyncGRPOTrainer از TRL آموزش دادیم. آداپترها با پرچم all-linear به مدل متصل شدند. برای بیشینهکردن کارایی آموزش، حالت تفکر در مرحلههای رولاوت خاموش بود و آداپتر نهایی را با و بدون تفکر برای مقایسه گستردهتر ارزیابی کردیم.
تابع پاداش نهایی از درستی ارزیاب بهعلاوه یک پاداش کوچک برای کارایی ابزار (۰٫۱، برگرفته از آزمایشهای اولیه نسخه قبلی آداپترهای هارنس که نشان داد ۰٫۱ بهترین نتیجه را میدهد) تشکیل شده است.
یک جستوجوی کوچک نرخ یادگیری روی ۵۰ گام با محیطهای Termgrade انجام دادیم (1e-5، 5e-5 و 1e-4) و دیدیم که 1e-5 بهسختی درستی آموزش را جابهجا کرد (از ۰٫۵۲ به ۰٫۵۰)، 1e-4 رولاوتها را بهجای بهبود فروپاشاند (تعداد نوبت در هر رولاوت از ۱۸ به ۶ رسید و آنتروپی بالا رفت) و فقط 5e-5 بهطور واضح بهبود داد (از ۰٫۴۹ به ۰٫۶۰ تا گام ۴۰). اجراهای طولانیتر با 5e-5 بعداً نشانههای ناپایداری نشان دادند (کوتاهشدن طول رولاوت و بالا رفتن آنتروپی)، بنابراین برای اجراهای نهایی روی 2e-5 ماندیم.
زیرساخت آموزش
هر آداپتر هارنس با دو GPU مدل NVIDIA B200 آموزش دید؛ یک GPU به سرور vLLM و دیگری به فرایند آموزش اختصاص داشت. ابتدا کمی تست فشار انجام دادیم تا بیشترین تعداد وظیفه RL را که میتوان در یک گام بهینهسازی آموزش داد پیدا کنیم. برای این کار، آرگومان --token-budget در AsyncGRPOTrainer را برای تنظیمات موجود تا حد ممکن بالا بردیم. نمودار زیر تحول تعداد گروهها در هر گام را برای هر هارنس نشان میدهد (آبی: Pi، سبز: OpenCode و نارنجی: Hermes).
هرچه مدل در طول آموزش بهتر میشود، گروههای بیشتری در هر گام آموزش جا میگیرد و این سیگنالهایی را که مدل در هر گام بهینهسازی میگیرد متنوعتر میکند.
ترکیب نهایی
ترکیب داده نهایی شامل ۷۵۰ وظیفه از محیطهای RL در harness-adapters و ۳۰۰ وظیفه از termgrade است. برای بیشینهکردن تنوع وظایف نمونهگیریشده در طول آموزش، استراتژی نمونهگیری داده را کمی سفارشی کردیم که در ادامه توضیح داده میشود:
پیش از آموزش، وظایف در ترتیبی ثابت قرار میگیرند که آنها را بر اساس خانواده (یعنی مخزنشان برای محیطهای RL تولیدشده ما؛ برای Termgrade فقط بر اساس نام مرتب شدند چون هر وظیفه خانواده خودش حساب میشود) درهم میآمیزد، تا هر گام آموزش تا حد امکان مخزنهای بیشتری را ترکیب کند و در عین حال توزیع ترکیب را رعایت کند.
safeagents در حلقه
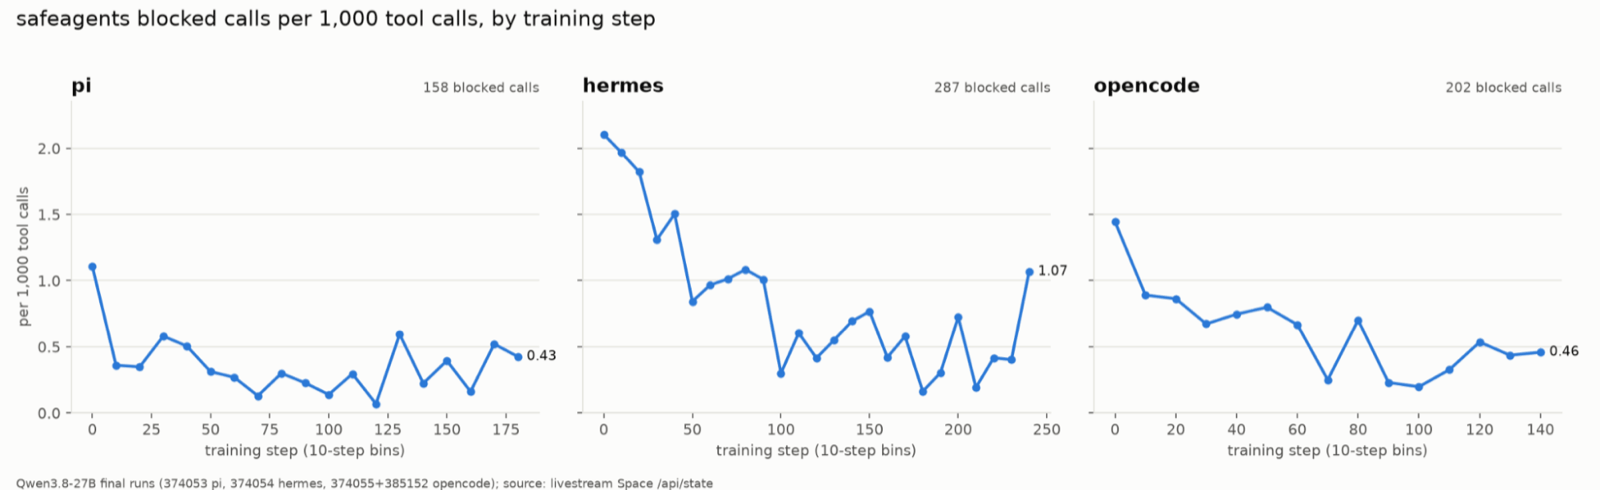
ابزار safeagents را هم وصل کردیم تا هر رفتار نادرست مدل در طول آموزش مسدود شود. افزونه نهایی (که شامل قواعد regex و الگوهای مخصوص وظایف RL و مسیر تست است) در harness-hub/qwen-safeagents-plugin میزبانی میشود و با آخرین نسخه safeagents بهصورت آماده قابل استفاده است، اگر کسی بخواهد تنظیمات آموزش را بازتولید کند.
تعداد ابزارهای مسدودشده توسط safeagents در طول آموزش بهطور پیوسته کاهش مییابد که نشان میدهد مدل پس از هر گام بهینهسازی «ایمنتر و ایمنتر» میشود. نمودار زیر تعداد فراخوانیهای مسدودشده safeagents به ازای هر ۱۰۰۰ فراخوانی ابزار را بر حسب گام آموزش برای هر آداپتر هارنس نشان میدهد.
سوپرآداپتر: ادغام همه آداپترها در یکی
ادغام مدلها اغلب تواناییهایشان را ترکیب میکند و بیشتر آنچه هر کدام میتوانستند انجام دهند را حفظ میکند. پس از آموزش سه آداپتر هارنس، دو پرسش مطرح کردیم. آیا ادغام آنها دقت را کاهش میدهد؟ و آیا یک «سوپرآداپتر» واحد میتواند زیر هر هارنسی دقیق و کارا باشد؟
ابتدا بهروزرسانیهای وزنی سه آداپتر را لایه به لایه مقایسه کردیم. شباهت کسینوسی بین هر دو آداپتر حدود ۰٫۰۱ تا ۰٫۰۲ است: هر آداپتر در طول آموزش مدل را در جهتی تقریباً متعامد هل داده است. این بهترین حالت برای ادغام است، چون بهروزرسانیها تقریباً با هم تداخل ندارند.
سه آداپتر LoRA را در بُعد رتبه به هم میچسبانیم (combination_type="cat" در PEFT). آداپتر ادغامشده رتبه ۹۶ دارد (۳ × ۳۲) و دقیقاً w · (ΔW_pi + ΔW_hermes + ΔW_opencode) را اعمال میکند. کارهای پیشین در ادغام (حساب وظیفه، TIES، KnOTS) نشان میدهند که مقیاسکردن هر بهروزرسانی به کمتر از ۱ بهترین نتیجه را میدهد، بنابراین سه وزن را روی همه ۸۹ وظیفه Terminal-Bench 2.1 و زیر هر هارنس با آداپترهای step-120 مقایسه کردیم:
⅓ (میانگین): هر هارنس فقط یکسوم بهروزرسانی خودش را نگه میدارد.
½: هر بهروزرسانی با نصف قدرت.
۱ (جمع ساده): هر بهروزرسانی بهطور کامل اعمال میشود.
وزن | Pi | Hermes | OpenCode | هر سه هارنس | فراخوانی ابزار در هر وظیفه
مدل پایه | ۳۹٫۱٪ | ۴۶٫۰٪ | ۴۴٫۸٪ | ۴۳٫۳٪ | ۴۹٫۲
⅓ (میانگین) | ۴۹٫۴٪ | ۵۱٫۲٪ | ۴۷٫۱٪ | ۴۹٫۲٪ | ۳۵٫۶
½ | ۴۸٫۸٪ | ۵۳٫۵٪ | ۵۵٫۲٪ | ۵۲٫۵٪ | ۲۵٫۹
۱ (جمع) | ۴۰٫۲٪ | ۶۲٫۸٪ | ۴۷٫۱٪ | ۵۰٫۰٪ | ۱۳٫۴
جمع ساده، بهروزرسانیها را بیش از حد اعمال میکند. عاملها بسیار کوتاه میشوند (۱۳ فراخوانی ابزار در هر وظیفه، در مقابل ۴۹ برای مدل پایه) و هرچند Hermes به ۶۲٫۸٪ میرسد، Pi به سطح مدل پایه برمیگردد. میانگین، بهروزرسانی هر هارنس را رقیق میکند. وزن ½ بهترین تعادل را میدهد، بنابراین سوپرآداپتر نهایی را از چکپوینتهای منتشرشده (Pi گام ۱۶۰، Hermes گام ۱۶۰، OpenCode گام ۱۵۰) با وزن ½ ساختیم.
نتایج ارزیابی ادغام آداپترها
زیر هر هارنس، روی وظایفی که همه اجراها نمره دادند (۵۰ تا ۵۱ در SWE-bench Pro و ۸۲ تا ۸۵ در Terminal-Bench 2.1)، یک تلاش برای هر وظیفه (در پرانتز، بهبود کارایی نسبت به مدل پایه):
هارنس | بنچمارک | Qwen3.8-27B | Qwen3.8-27B-<harness>-adapted | Qwen3.8-27B-super-adapter | Qwen3.8-27B با تفکر | Qwen3.8-27B-super-adapter با تفکر
Pi | SWE-bench Pro (سخت ۵۱) | ۴۰٫۰٪ | ۶۴٫۰٪ (−۶۰٪) | ۴۶٫۰٪ (−۷۳٪) | ۷۴٫۰٪ | ۷۴٫۰٪ (−۴۸٪)
Hermes | SWE-bench Pro (سخت ۵۱) | ۲۹٫۴٪ | ۴۳٫۱٪ (−۵۶٪) | ۴۷٫۱٪ (−۶۰٪) | ۴۵٫۱٪ | ۶۰٫۸٪ (−۳۶٪)
OpenCode | SWE-bench Pro (سخت ۵۱) | ۳۵٫۳٪ | ۵۱٫۰٪ (−۷۲٪) | ۴۵٫۱٪ (−۶۳٪) | ۴۷٫۱٪ | ۶۶٫۷٪ (−۳۱٪)
Pi | Terminal-Bench 2.1 | ۴۰٫۰٪ | ۵۶٫۵٪ (−۵۶٪) | ۴۸٫۲٪ (−۵۶٪) | ۵۲٫۹٪ | ۵۷٫۶٪ (−۲۵٪)
Hermes | Terminal-Bench 2.1 | ۴۴٫۷٪ | ۵۸٫۸٪ (−۷۰٪) | ۵۵٫۳٪ (−۵۳٪) | ۵۸٫۸٪ | ۶۳٫۵٪ (−۱۹٪)
OpenCode | Terminal-Bench 2.1 | ۴۷٫۶٪ | ۵۲٫۴٪ (−۵۳٪) | ۵۲٫۴٪ (−۶۸٪) | ۵۴٫۹٪ | ۵۸٫۵٪ (−۲۲٪)
«تفکر» یعنی حالت تفکر قالب چت با تلاش پیشفرض آن (xhigh). آداپترهای تخصصی با تفکر خاموش آموزش دیده و سرو شدهاند.
با تفکر خاموش، سوپرآداپتر در هر شش جفت هارنس–بنچمارک از مدل پایه بهتر است (میانگین pass@1 از ۳۹٫۵٪ به ۴۹٫۰٪؛ ۷۱ وظیفه تازه حلشده در مقابل ۳۴ وظیفه ازدسترفته، p < 0.001).
با اینکه اصلاً با تفکر روشن آموزش ندیده، قویترین مدلی است که با حالت تفکر ارزیابی کردیم. در برابر مدل پایه با تفکر و همان سطح تلاش، در پنج جفت از شش جفت برنده میشود و در ششم مساوی (میانگین از ۵۵٫۵٪ به ۶۳٫۵٪؛ ۶۷ وظیفه تازه حلشده در مقابل ۳۷ وظیفه ازدسترفته، p = 0.004). بزرگترین بهبودها در SWE-bench Pro است: +۱۶ واحد درصد زیر Hermes و +۲۰ واحد درصد زیر OpenCode. زیر Pi در SWE-bench Pro، جایی که تفکر بهتنهایی از قبل به ۷۴٪ میرسد، مساوی میشود.
وقتی تفکر خاموش است از آداپترهای تخصصی هارنس استفاده کنید. آداپتر اختصاصی هر هارنس در چهار جفت از شش جفت جلوتر است و بیشترین برتری را زیر Pi دارد (۶۴٫۰٪ در مقابل ۴۶٫۰٪ در SWE-bench Pro و ۵۶٫۵٪ در مقابل ۴۸٫۲٪ در Terminal-Bench). تقسیم یک مدل بین سه هارنس، بیشترین آسیب را به بهره Pi میزند. اگر فقط از یک هارنس استفاده میکنید و تفکر را خاموش نگه میدارید، آداپتر تخصصی همان هارنس را بردارید.
سوپرآداپتر همچنین بسیار کاراتر است. روی وظایفی که هم مدل پایه و هم سوپرآداپتر حل میکنند، با تفکر خاموش، ۵۳ تا ۷۳٪ فراخوانی ابزار کمتر و ۴۴ تا ۶۰٪ توکن کمتر در هر وظیفه تولید میکند و در ۱۱۱ وظیفه از ۱۳۰ وظیفه فراخوانی ابزار کمتری دارد. با تفکر روشن هم در SWE-bench Pro فراخوانی ابزار را ۳۱ تا ۴۸٪ و توکنها را ۲۴ تا ۴۳٪ کاهش میدهد. در Terminal-Bench، فراخوانی ابزار ۱۹ تا ۲۵٪ کم میشود و تعداد توکنها تقریباً ثابت میماند.
وزن ½ روی Terminal-Bench 2.1 و با آداپترهای step-120 انتخاب شد، بنابراین اعداد Terminal-Bench کمی خوشبینانهاند؛ SWE-bench Pro در این انتخاب هیچ نقشی نداشت. نتایج کامل جفتشده در کارت مدل سوپرآداپتر آمده است.
نتایج نهایی
این بخش گزارش میکند که در طول آموزش چه اتفاقی افتاد و سپس آداپترها در بنچمارکهای نگهداشتهشده، هم داخل و هم خارج از هارنس خودشان، چه امتیازی میگیرند.
نتایج آموزش
آموزش در مجموع ۵۹۸ گام طول کشید و در کل ۷۸٬۱۱۴ نمونه آموزش دید که دقیقاً معادل ۱۶۷ میلیون توکن آموزشدیده است.
در طول آموزش، نشانه روشنی میبینیم که مدل یاد میگیرد وظایف را در گامهای کمتر و کمتری حل کند، بدون نشانه واضحی از اشباع. هرچند گاهی روند افزایشی روشنی دیده میشود، درستی آموزش در کل تقریباً ثابت میماند. این را میتوان با این توضیح داد که مدل در طول آموزش با وظایف تازه روبهرو میشود، اما تعداد گروههایی که در بودجه توکن یک گام جا میگیرند با کوتاهترشدن مسیرها بیش از دو برابر میشود. بهبود دقت در بنچمارکهای نگهداشتهشده در بخش زیر دیده میشود.
از سوی دیگر، safeagents توانست چندین تلاش مشکوک را مسدود کند. در سه اجرای آموزش، در مجموع ۱٫۳ میلیون فراخوانی ابزار بررسی شد و ۶۴۷ فراخوانی ابزار مسدود شد.
نتایج ارزیابی
این بخش تنظیمات ارزیابی، نتایج داخل هارنس، انتقال بین هارنسها و یک بررسی خارج از توزیع را پوشش میدهد.
تنظیمات ارزیابی
هر آداپتر را داخل همان هارنسی ارزیابی میکنیم که در آن آموزش دیده، روی دو بنچمارک عامل کدنویسی: همه ۸۹ وظیفه Terminal-Bench 2.1 (یک ساعت و ۱۰۰ گام عامل برای هر وظیفه) و ۵۱ وظیفه سختتر SWE-bench Pro (دو ساعت و ۱۰۰ گام عامل). حداکثر تعداد توکن در هر وظیفه را ۱۳۱۰۷۲ تعیین کردیم. تنظیمات عامل را تغییر نمیدهیم و از تنظیمات پیشفرض همه هارنسها استفاده میکنیم. برای مثال، Pi نوبتهای استدلال قبلی را نگه نمیدارد در حالی که OpenCode و Hermes نگه میدارند، و این عمدتاً روی نتایج SWE-bench Pro بهدلیل سرریز سریع زمینه اثر میگذارد. بنابراین نمیتوانید نتایج را بین هارنسهای مختلف مقایسه کنید (استفاده از Pi لزوماً به نتایج بهتر از Hermes یا OpenCode منجر نمیشود)، اما مقایسه نتایج درون یک هارنس و نتیجهگیری از آن منصفانه است.
هر رولاوت از همان پشته Harbor و OpenEnv آموزش عبور میکند، در سندباکسهای HF، با یک تلاش برای هر وظیفه در دمای ۰٫۸ و تفکر خاموش. هر چکپوینت LoRA در وزنهای پایه ادغام و بهتنهایی با vLLM روی یک GPU سرو میشود، با همان همزمانی ارزیابی مدل پایه.
برای همه بنچمارکهای ارزیابی، pass@1 و همچنین تعداد فراخوانی ابزار و کل نوبتها را برای همه وظایف و برای وظایف حلشده گزارش میکنیم.
برای شفافیت، همه مسیرهای مدل برای ارزیابیهای نهایی در این باکت عمومی منتشر شدهاند: harness-hub/harness-adapters-trajectories.
نتایج ارزیابی نهایی
هر سه آداپتر تخصصی زیر هارنس خودشان و در هر دو بنچمارک از مدل پایه بهترند. در SWE-bench Pro (سخت ۵۱)، Pi از ۳۹٫۲٪ به ۶۴٫۷٪ میرسد (+۲۵٫۵ واحد درصد: ۱۵ وظیفه تازه حلشده در مقابل ۲ وظیفه ازدسترفته، p = 0.002)، Hermes از ۲۹٫۴٪ به ۴۳٫۱٪ و OpenCode از ۳۵٫۳٪ به ۵۱٫۰٪. در کل Terminal-Bench 2.1، Pi +۱۶٫۳ واحد درصد (۱۶ در مقابل ۲، p = 0.001) و Hermes +۱۴٫۱ واحد درصد (۱۹ در مقابل ۷، p = 0.03) بهبود میگیرد. OpenCode در کل +۶٫۰ واحد درصد و در ۶۶ وظیفهای که در انتخاب چکپوینتش هیچ نقشی نداشتند +۱۳٫۶ واحد درصد (۱۲ در مقابل ۳، p = 0.035) بهبود میگیرد.
آداپترها وظایف را بسیار کاراتر هم حل میکنند: روی وظایفی که هم آنها و هم مدل پایه حل میکنند، در SWE-bench Pro ۵۶ تا ۷۲٪ و در Terminal-Bench 2.1 ۵۳ تا ۷۰٪ فراخوانی ابزار کمتری در هر وظیفه دارند. سوپرآداپتر واحد هم زیر هر سه هارنس از مدل پایه بهتر است (+۶ تا +۱۸ واحد درصد در SWE-bench Pro و +۵ تا +۱۰ واحد درصد در Terminal-Bench 2.1) و کاهش فراخوانی ابزارش هم به همان اندازه بزرگ است (۵۳ تا ۷۳٪). با تفکر خاموش، بخش کمتری از بهره هر آداپتر تخصصی را حفظ میکند، بیشتر از همه زیر Pi، اما با تفکر روشن در پنج جفت از شش جفت هارنس–بنچمارک از مدل پایه با تفکر و همان سطح تلاش بهتر است (بخش سوپرآداپتر را ببینید). نتایج کامل جفتشده در هر کارت مدل آمده است.
آیا توانایی کارایی و عملکرد بین هارنسها منتقل میشود؟
برای پاسخ به این پرسش، آداپتر هارنس Pi را زیر Hermes Agent و OpenCode هم ارزیابی کردیم.
زیر OpenCode در Terminal-Bench 2.1 با آداپتر تخصصی خود OpenCode برابر است (از ۴۴٫۸٪ به ۵۴٫۰٪، در مقابل از ۴۶٫۴٪ به ۵۲٫۴٪). زیر Hermes حدود دوسوم بهره آداپتر تخصصی را حفظ میکند (از ۴۶٫۳٪ به ۵۶٫۱٪، در مقابل از ۴۴٫۷٪ به ۵۸٫۸٪) و در هر دو حدود ۴۵٪ کاهش فراخوانی ابزار دیده میشود. بنابراین به نظر میرسد تواناییهای تازهآموختهشده بین هارنسها منتقل میشوند.
ارزیابی روی وظایف و تنظیمات خارج از توزیع
اگر در وظایف خارج از توزیع و بیرون از هارنسهایی که آداپترها با آنها آموزش دیدهاند ارزیابی کنیم، چه میشود؟
هر پنج مدل را روی ۳۰۰ وظیفهٔ AutomationBench اجرا کردیم که ارزیابیهای گردشکار اتوماسیون کاری را در بر میگیرد، با حلقهٔ عامل خود AutomationBench بهجای Pi، Hermes یا OpenCode. اینطور میتوانیم دو پرسش متفاوت را همزمان بررسی کنیم: آیا مدل میتواند مسائلی بیرون از وظایف مرتبط با SWE را حل کند؟ و وقتی مدل بیرون از هارنسی قرار میگیرد که با آن آموزش دیده، چه اتفاقی میافتد؟
نتایج نشان میدهد آداپترها نزدیک به مدل پایه میمانند. Pi و OpenCode کمی جلوترند (۲۷٫۰٪ و ۲۵٫۳٪ pass@1 در مقابل ۲۳٫۰٪)، آداپتر ادغامشده همسطح است (۲۳٫۷٪) و Hermes چند واحد درصد عقبتر (۱۷٫۷٪). تفاوتها در محدودهٔ نویز هستند، شاید بهجز Hermes؛ بنابراین یادگیری تقویتی داخل هارنسها نه بهطور واضح به این تنظیم بسیار متفاوت منتقل میشود و نه مدل را در آن خراب میکند.
مدل | pass@1 (همهٔ ادعاها برآورده شده) | نسبت به پایه | امتیاز جزئی (سهم ادعاهای برآوردهشده) | نسبت به پایه
پایه | ۲۳٫۰٪ | | ۶۲٫۲٪ |
Pi 160 | ۲۷٫۰٪ | +۴٫۰ | ۶۶٫۲٪ | +۴٫۰
OpenCode 150 | ۲۵٫۳٪ | +۲٫۳ | ۶۵٫۲٪ | +۳٫۰
ادغامشده | ۲۳٫۷٪ | +۰٫۷ | ۶۰٫۶٪ | −۱٫۶
Hermes 160 | ۱۷٫۷٪ | −۵٫۳ | ۵۶٫۶٪ | −۵٫۶
پرسش باز: مدل واقعاً چه چیزی یاد گرفت؟
از بازخورد کاربران و جامعه سپاسگزاریم؛ آزمونهای اولیه و نتایجی که جامعه گزارش کرد در مجموع بسیار مثبت به نظر میرسید و امیدواریم در آینده همین مسیر را ادامه دهیم. نتایج غافلگیرکنندهای هم دیدیم؛ مثلاً کاربران گزارش دادند که آداپترهای هارنس روی مشتقات Qwen3.8، مانند Swift-1.5، خیلی خوب کار میکنند.
این پرسشی است که پس از انتشار، دربارهاش فکر کردیم. پس از بررسی دقیق مسیرهای تولیدشده در بنچمارکهای ارزیابی مشخص شد مدل در حالت غیرتفکر پیش از پیشنهاد فراخوانی ابزار، متن کوتاهی تولید میکند؛ در حالی که مدل پایه تقریباً بدون هیچ متنی فراخوانی ابزار را تولید میکند.
این پدیده را میتوان نوعی «نشت استدلال» دانست: مدل یاد میگیرد با تولید متنی که گاهی شبیه رد استدلال به نظر میرسد (مثلاً «..wait?»، «..let me see» و مانند آن) از نسخهٔ غیرتفکر خود به نسخهٔ تفکر «فرار» کند. یک مقالهٔ اخیر هم رفتار مدلهای زبانی بزرگ را در مرحلهٔ RL بهخوبی توصیف میکند.
آیا این موضوع مدلهای ما را بیاعتبار میکند؟ به نظر ما نه؛ چون نتایج نهایی همچنان معتبرند: در شرایط دقیقاً یکسان (بودجهٔ توکن ثابت) آداپترهای ما بهمراتب بهتر از مدل پایهٔ غیرتفکر عمل میکنند و به عملکرد نسخهٔ تفکر میرسند، در حالی که از نظر توکن بسیار کممصرفترند. بازخورد مثبت جامعه هم این را بیشتر تأیید کرده است.
با این حال، این موضوع نیاز به یک کار تکمیلی درست را نشان میدهد: میخواهیم همان خط لوله را برای مدلهای صرفاً تفکری دوباره اجرا کنیم و آموزش ترکیبی تفکر/غیرتفکر را هم بررسی کنیم تا رفتار آموزش RL روی مدلهای ترکیبی را بهتر بفهمیم. پس از رسیدن به نتایج قطعی، یافتههای بعدی (و آداپترهای هارنس) را با جامعه به اشتراک میگذاریم.
سخن پایانی و مسیرهای آینده
در این کار نشان دادیم آموزش RL مدل داخل هارنس هدف، وقتی در شرایط یکسان ارزیابی شود، به مدلهای نهایی دقیقتر و در نتیجه کارآمدتری میرسد. این مشاهده با چند کار پیشین تیمهای Hugging Face، مانند multi-harness-RL یا نسخههای اولیهٔ آداپترهای هارنس، همراستا و در ادامهٔ آنهاست.
در آینده، این دستور کار را روی مدلهای بیشتری آزمایش میکنیم و همزمان راهبردهای آموزش مدلهای ترکیبی تفکر/غیرتفکر را بهتر بررسی خواهیم کرد.
همچنین کل دستور کار و خط لوله را برای بازتولید همهچیز بهصورت باز با جامعه به اشتراک میگذاریم و از همه دعوت میکنیم وظایف RL خود را از پایگاه کد خودشان یا هر منبع مرتبط بسازند و همان دستور کار و ایدههای آموزش را روی مدل و هارنس دلخواهشان به کار ببرند تا مدلهای عاملی کارآمدتری داشته باشند. امیدواریم این پست نقطهٔ شروعی باشد تا سازندگان در آینده آداپترهای هارنس خود را بسازند و به اشتراک بگذارند.
 نگار رضایی
 آرمان کریمی