 سارا نادری
امروز DaisyRose-27B را منتشر میکنیم؛ نخستین مدل RadixArk که بر پایه Qwen3.8-27B ساخته شده و با یادگیری تقویتی و با استفاده از Miles آموزش دیده است. این مدل را روی وظایف عامل با افق طولانی و نشستهایی تا ۱ میلیون توکن آموزش دادیم؛ تنها با ۱۲۰۰ وظیفه منتخب، در ۱۸ روز و روی ۱۴۴ GPU H200. DaisyRose-27B دقت pass@1 را در Terminal-Bench 4.1 از ۵.۶٪ به ۱۲.۰٪ میرساند. فراتر از Terminal-Bench 4.1، این مدل در مجموعهای از بنچمارکهای دیگر استدلال، پیروی از دستور و کدنویسی نیز بهبود نشان میدهد.
چکپوینتها با مجوز Apache 2.0 در دسترس هستند:
BF16
FP8
NVFP4
این مدل معماری، توکنایزر، قالب چت، درک تصویر و پنجره زمینه ۲۵۶ هزار توکنی Qwen3.8-27B را حفظ میکند. نشستهای طولانیتر آموزش از خلاصهسازی با هارنس استفاده میکنند تا چند مسیر (trajectory) را پوشش دهند. برای آشنایی با ویژگیهای مدل و تنظیمات استنتاج، کارت مدل را ببینید.
اجرای DaisyRose-27B
توصیه میکنیم DaisyRose-27B را با SGLang و رمزگشایی حدسی DSpark سرویس دهید. دفترچه راهنمای SGLang پیکربندیهای اجرا برای GPUها و قالبهای مختلف چکپوینت را در اختیار میگذارد.
پس از راهاندازی سرور با نام مدل DaisyRose-27B روی پورت 30000، میتوانید با کلاینت پایتون OpenAI درخواست بفرستید:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:30000/v1",
    api_key="none",
)

response = client.chat.completions.create(
    model="DaisyRose-27B",
    messages=[
        {
            "role": "user",
            "content": "How many positive divisors does 360 have?",
        }
    ],
    temperature=1.0,
    top_p=0.95,
    extra_body={"top_k": 20, "min_p": 0.0},
)

print(response.choices[0].message.reasoning_content)
print(response.choices[0].message.content)
این مدل بهطور پیشفرض پیش از پاسخ دادن فکر میکند. استدلال آن در reasoning_content و پاسخ نهایی در content برگردانده میشود. این تنظیمات مطابق بخش شروع سریع کارت مدل است.
نتایج بنچمارک
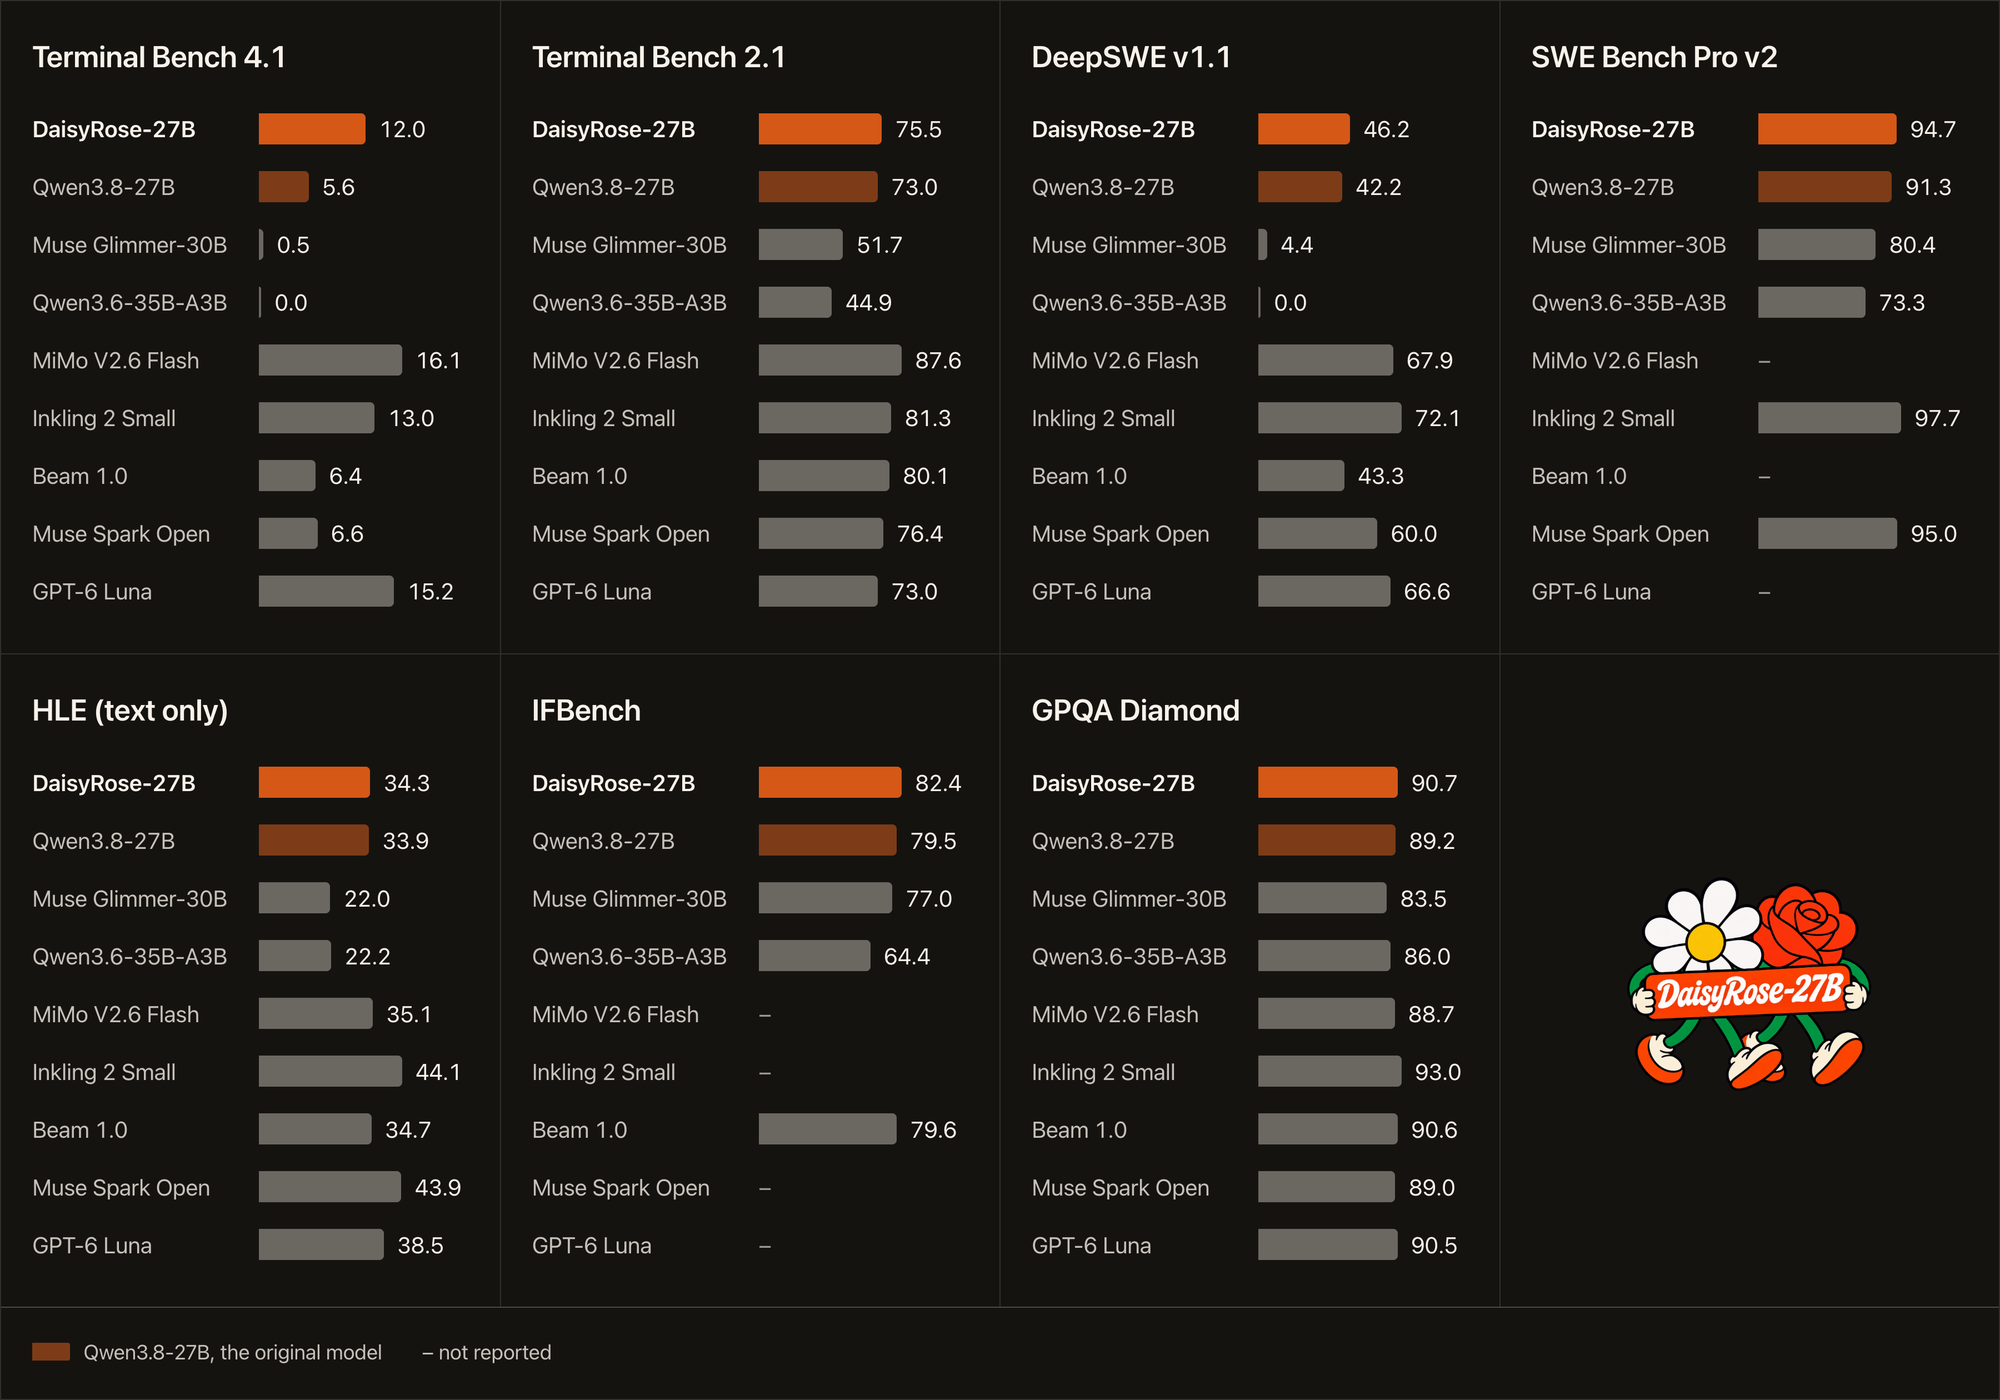
بنچمارک | Qwen3.8-27B | DaisyRose-27B
Terminal-Bench 4.1 | 5.6 | 12.0
Terminal-Bench 2.1 | 73.0 | 75.5
DeepSWE v1.1 | 42.2 | 46.2
SWE Bench Pro v2 | 91.3 | 94.7
HLE (فقط متن) | 33.9 | 34.3
IFBench | 79.5 | 82.4
GPQA Diamond | 89.2 | 90.7
DaisyRose-27B در همه بنچمارکهای بالا امتیاز بیشتری از مدل اصلی Qwen3.8-27B کسب میکند. بزرگترین بهبود در Terminal-Bench 4.1 است که pass@1 در آن از ۵.۶٪ به ۱۲.۰٪ میرسد.
امتیازها برای هر بنچمارک از میان اجرای BF16 و FP8، مقدار بالاتر را نشان میدهند؛ در هر بنچمارکی که هر دو اجرا انجام شده، اختلاف این دو کمتر از یک امتیاز است. کارت مدل منابع مقایسه و تنظیمات ارزیابی را در بر دارد.
سه بخش از تنظیمات آموزش این انتشار را ممکن کرد: وظایف با طراحی دقیق، بکاند آموزشی کارآمد و سندباکسهای قابل اتکا.
داده آموزشی باکیفیت
وظایف را با همکاری Eigent AI ساختیم و از مجموعه بزرگ وظایف آن در یادگیری ماشین، مهندسی نرمافزار، علوم و حوزههای دیگر آغاز کردیم. در مجموع هزاران گزینه ساختیم و حدود ۱۲۰۰ مورد به مجموعه نهایی آموزش راه یافت.
وظایف را بر پایه سه معیار انتخاب کردیم:
هر وظیفه به اشتباهی هدف میگیرد که مدل اصلی مرتکب میشود. Qwen3.8-27B را روی هر وظیفه اجرا کردیم و هر وظیفه را حول اشتباهاتی بازطراحی کردیم که میخواستیم مدل دیگر تکرارشان نکند. سپس دشواری را تنظیم کردیم تا نرخ حل در محدودهای مفید برای یادگیری قرار بگیرد.
هر وظیفه چند مرحله وابسته به هم میطلبد. عامل باید در یک کار طولانی استدلال، برنامهریزی و اجرا کند. هر تلاش تا ۱.۵ ساعت در سندباکس زمان دارد، با بیش از ۱۰۰ فراخوان ابزار و بیش از ۲۵۶ هزار توکن خروجی.
وظیفه باید حل واقعی مسئله را پاداش دهد. هر وظیفه را همراه با تلاشهای مدل بررسی کردیم. وظایفی که بدون حل مسئله مورد نظر قابل گذر بودند یا ایراد طراحی داشتند، اصلاح یا حذف شدند.
بکاند آموزشی کارآمد
RadixArk مدل DaisyRose-27B را با Miles، چارچوب متنباز یادگیری تقویتی خود برای پسآموزش مدلهای بزرگ، در حالت کاملاً ناهمگام آموزش داد: عامل به کار خود ادامه میدهد و مدل همزمان یاد میگیرد و هیچکدام منتظر دیگری نمیماند. ۱۲۸ GPU H200 استنتاج روی وظایف عامل را اجرا میکنند و ۱۶ GPU دیگر آموزشدهنده را اجرا میکنند و از مسیرها یاد میگیرند. پس از هر گام، مدل بهروزشده به ۱۲۸ GPU اجراکننده عامل فرستاده میشود. یادگیری روی بکاند آموزشی داخلی ما انجام میشود که برای آموزش عامل ساخته شده است: هر گام از چند نشست بسیار طولانی، بعضی تا ۱ میلیون توکن، یاد میگیرد که با خلاصهسازی با هارنس به چند مسیر تبدیل شدهاند.
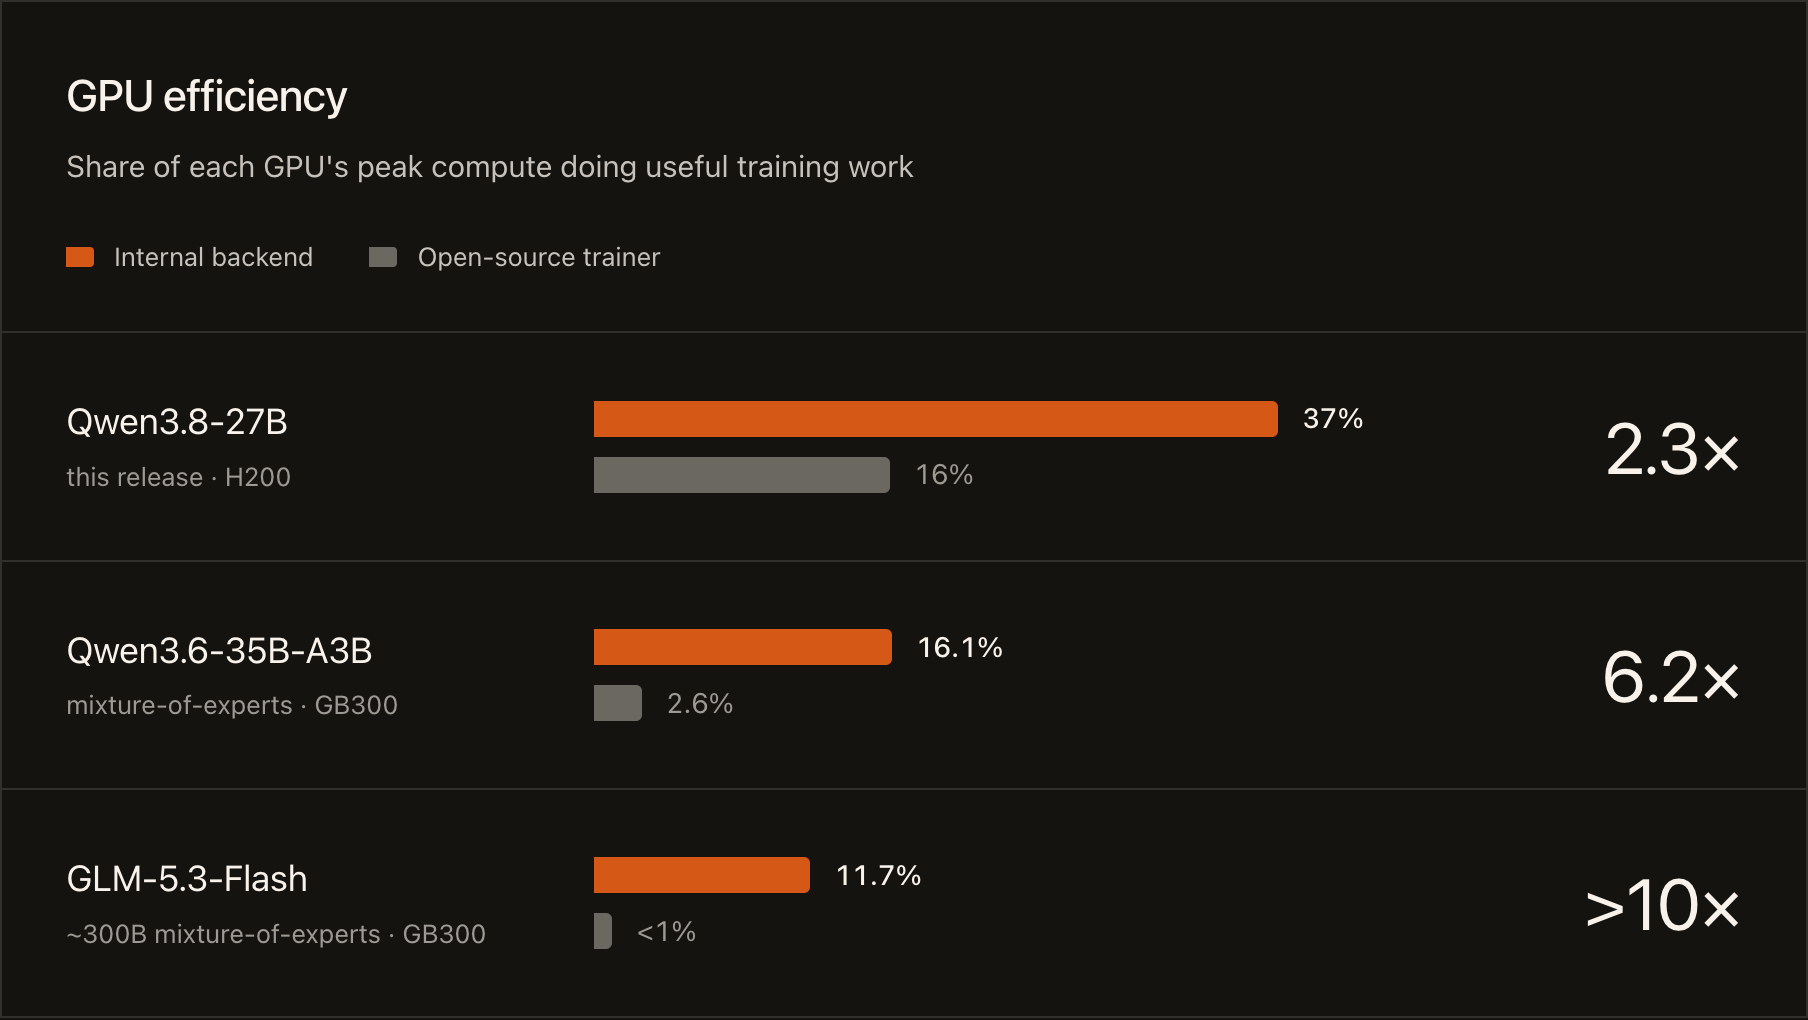
کاهش ۵۷٪ در هزینه آموزش. در این انتشار، ۳۷٪ از توان محاسباتی اوج هر GPU صرف کار مفید آموزش شد (بهرهوری FLOPs مدل، یا MFU) روی بکاند ما. آموزشدهنده متنباز که بر Megatron بنا شده است، در اجراهای قابل مقایسه به ۱۶٪ رسید. بنابراین همان آموزش به ۵۷٪ زمان GPU کمتر نیاز دارد. این بهبود در مدلهای ترکیب خبرگان حتی بیشتر است: ۶.۲ برابر در Qwen3.6-35B-A3B و بیش از ۱۰ برابر در GLM-5.3-Flash با حدود ۳۰۰ میلیارد پارامتر.
سرعت دو برابری در کل فرایند. با احتساب زمانی که عامل صرف وظایفش میکند، اجرای این انتشار روی ۱۴۴ GPU حدود ۱۶٬۸۰۰ توکن بر ثانیه آموزش دید. آموزشدهنده متنباز روی همان GPUها به حدود ۸٬۳۰۰ توکن بر ثانیه رسید.
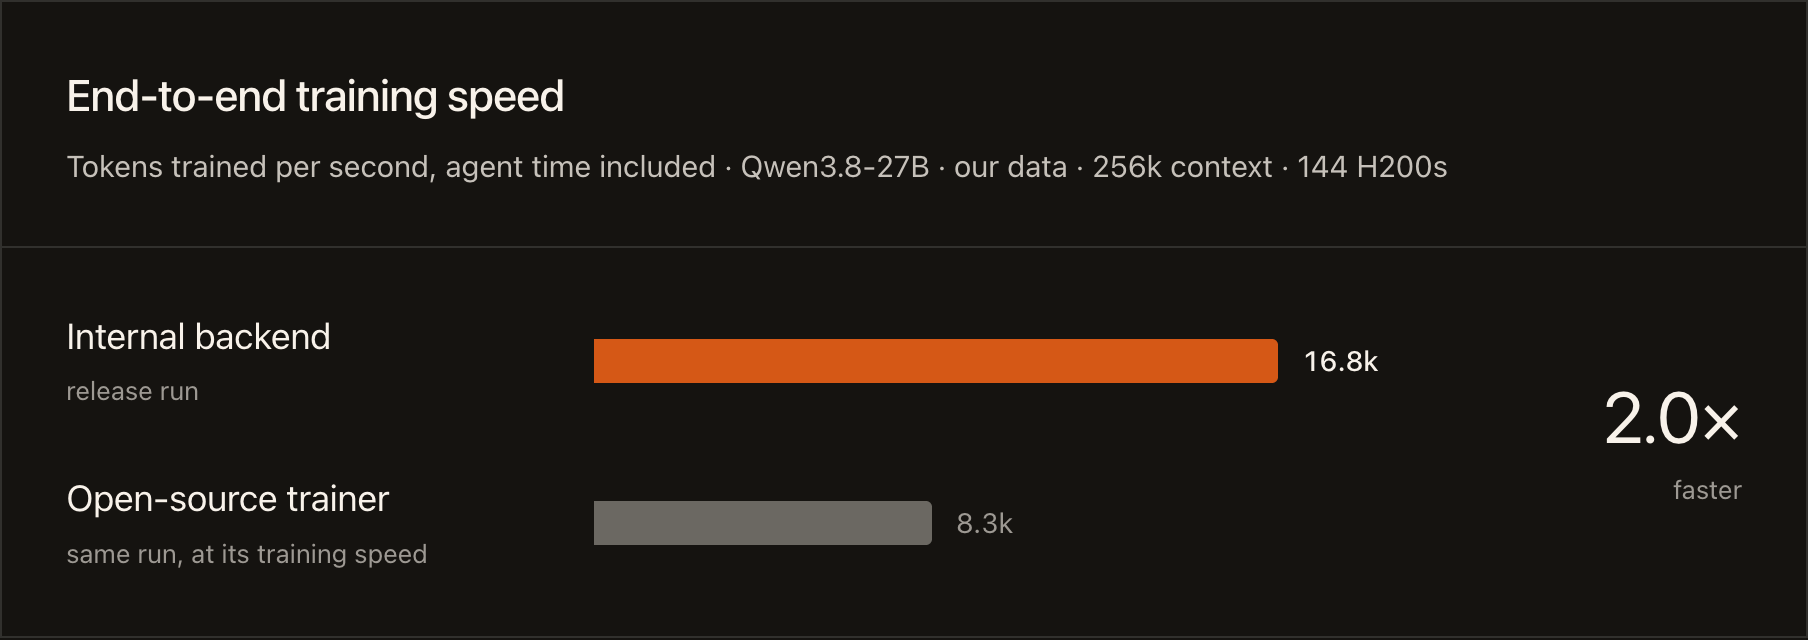
پایداری در طول هفتهها. اجرای این انتشار هفتهها روی ۱۴۴ GPU H200 ادامه داشت و در مجموع ۶۳٬۰۰۰ ساعت GPU مصرف کرد. سرعت و بهرهوری آن از نخستین گام تا آخرین گام ثابت ماند.
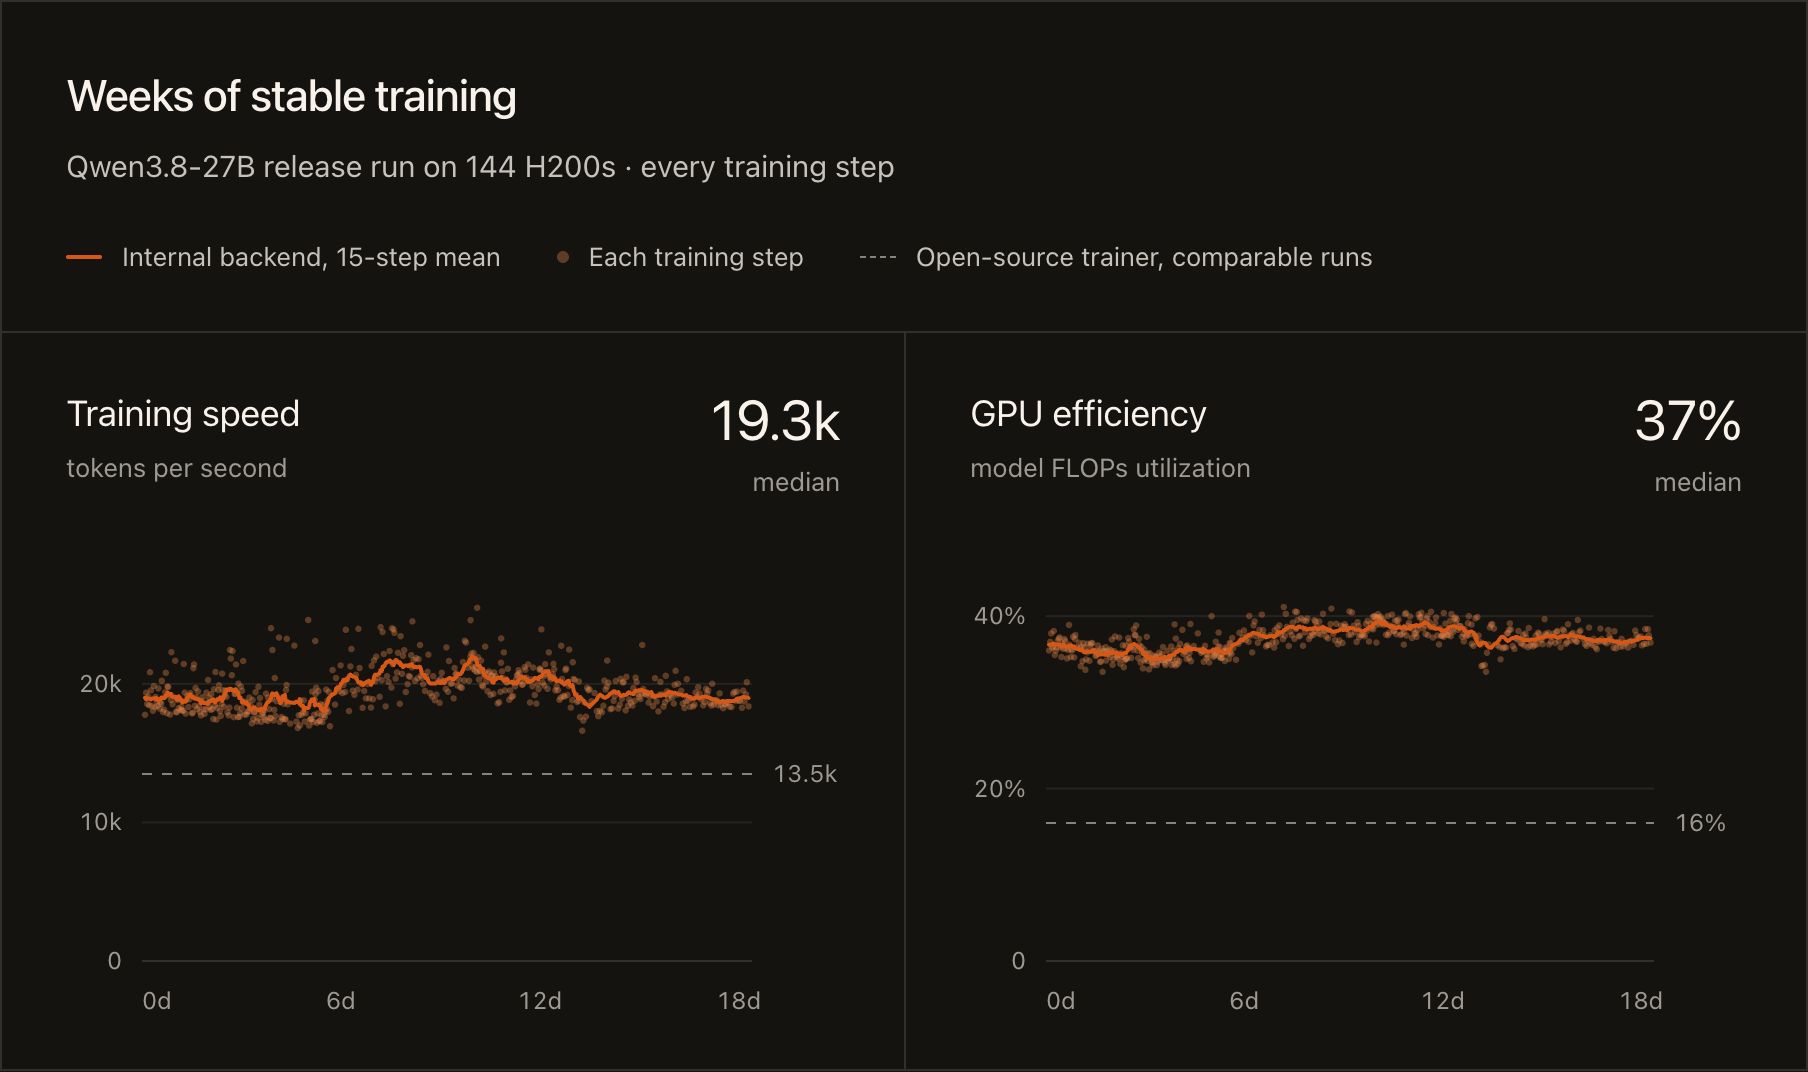
هر گام آموزش اجرای انتشار DaisyRose-27B روی ۱۴۴ GPU H200، در برابر کل زمان آموزش ترسیم شده است. خطوط چیندار: آموزشدهنده متنباز در اجراهای قابل مقایسه.
سرویس سندباکس قابل اتکا
هر تلاش آموزشی در یک سندباکس اجرا میشود: نسخه تازهای از محیط وظیفه که عامل در آن فرمان اجرا میکند، فایلها را ویرایش میکند و سپس ارزیابی میشود.
سرویس ما بر پروژه متنباز AgentENV بنا شده است و ما هم اصلاحاتی به آن مشارکت میدهیم. این سرویس بین اواسط سپتامبر و اواسط نوامبر حدود ۹۴۴٬۰۰۰ سندباکس برای این پروژه اجرا کرد و همزمان حداکثر ۱٬۵۶۶ سندباکس در حال اجرا داشت.
این سرویس از یک ماشین به حداکثر ۱۲ ماشین گسترش یافت. ده ارتقا روی آن اعمال کردیم که تقریباً همه در حین اجرای آموزش انجام شد. در تمام نُه هفته، ۹۹٪ ساخت سندباکسها موفق بود و از اواخر اکتبر این رقم از ۹۹.۹۵٪ فراتر رفته است.
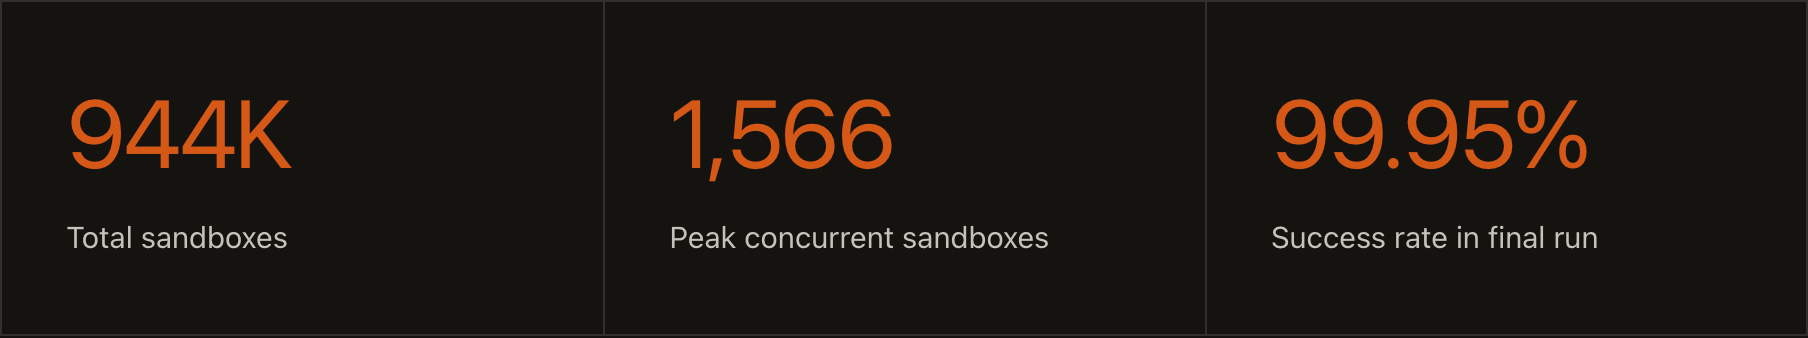
هزینه زیرساخت ابری سندباکسهای این پروژه حدود ۸۰٪ کمتر از اجرای همان سندباکسها با ارائهدهندگان رایج سندباکس ابری بود. یکی از راههای کاهش هزینه این است که تخصیص حافظه هر سندباکس با مصرف واقعی آن کم و زیاد شود تا سندباکسهای بیشتری هر ماشین را به اشتراک بگذارند.
مدل را امتحان کنید یا مدل خودتان را آموزش دهید
DaisyRose-27B را دانلود کنید، راهنمای سرویسدهی SGLang را دنبال کنید یا با Miles عاملهای خودتان را آموزش دهید.
دوست داریم بدانیم DaisyRose-27B روی وظایف شما چگونه عمل میکند، از جمله کجاها کم میآورد. تنظیمات و نتایج خود را در تب Community مدل به اشتراک بگذارید.
از Eigent AI برای همکاری نزدیک در داده آموزشی و از تیم Qwen برای ساخت Qwen3.8-27B سپاسگزاریم. همچنین از جوامع Miles و SGLang و دیگر پروژههای متنباز از جمله slime، AgentENV و Harbor قدردانی میکنیم.
برگرفته از مقاله اصلی RadixArk.
 نگار رضایی
 آرمان کریمی