 سارا نادری
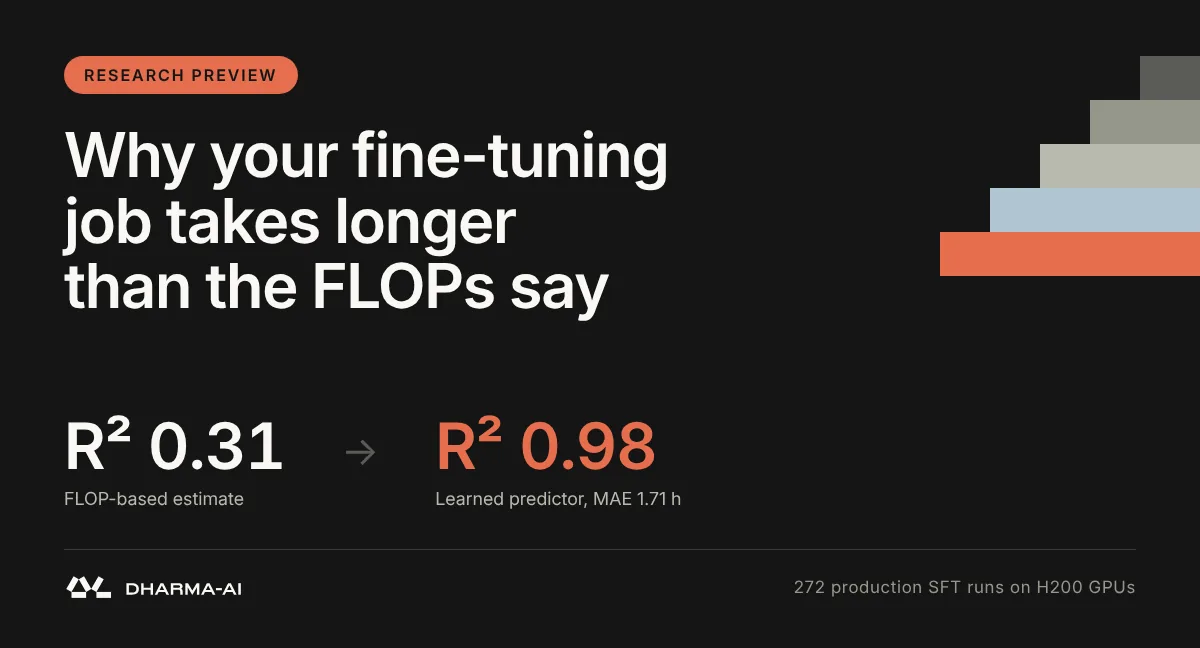
پیشبینی زمان پایانبهپایان فاینتیونینگ روی خوشههای GPU مشترک، بر پایهٔ ۲۷۲ اجرای واقعی در محیط تولید
پیشنمایشی از مقالهٔ در دست انتشار ما با عنوان «Predicting End-to-End Fine-Tuning Time for Generative Language Models». نسخهٔ کامل بهزودی در arXiv منتشر میشود.
GPUها امروز از گرانترین و کمیابترین منابع هوش مصنوعیاند. هر کسی که خوشهای مشترک را اداره میکند، هر روز باید تصمیم بگیرد کدام کار روی کدام GPU و به چه ترتیبی اجرا شود. کیفیت این برنامهریزی تنها بهاندازهٔ دقت برآورد مدتزمان هر کار است. وقتی کاری چند ساعت زودتر از پیشبینی تمام میشود، GPUها تا ارسال کار بعدی بیکار میمانند. وقتی چند ساعت دیرتر تمام میشود، همهٔ کارهای پشت سرش عقب میافتند، آزمایشها در انتظار میمانند و موعد تحویل جابهجا میشود.
برآورد دقیقتر مدتزمان، این وضعیت را از حدسوگمان به برنامهریزی تبدیل میکند: چه کاری، چه زمانی و روی چند GPU اجرا شود، با ظرفیت بیکار کمتر در فاصلهٔ میان کارها. با این حال، برآوردی که بیشتر تیمها به کار میبرند یک محاسبهٔ سرانگشتی FLOP است. این محاسبه میگوید کار نُه ساعت طول میکشد، اما کار بعدازظهر روز بعد تمام میشود.
میخواستیم بدانیم این محاسبه واقعاً چقدر خطا دارد و آیا میتوانیم پیش از ارسال کار، برآورد بهتری به دست آوریم. بنابراین ۲۷۲ کار واقعی فاینتیونینگ نظارتشده (SFT) را از استخر تولیدی خودمان از GPUهای NVIDIA H200 برداشتیم، در مجموع حدود ۷٬۳۸۲ ساعت-GPU، و برآوردهای تحلیلی را با پیشبینیکنندههای یادگیرنده مقایسه کردیم.
خلاصهٔ ماجرا: برآورد متداول مبتنی بر FLOP تنها بخش کوچکی از آنچه مشاهده کردیم را توضیح میدهد (R² = 0.31 و MAE برابر ۱۲٫۴۱ ساعت). یک مدل رگرسیون CatBoost که فقط اطلاعات در دسترس پیش از ارسال کار را میبیند، در اعتبارسنجی متقابل ۵-تایی به R² = 0.98 میرسد، با میانگین خطای مطلق ۱٫۷۱ ساعت و میانهٔ خطای ۰٫۵۱ ساعت. این فاصله از دو چیز میآید که یک برآورد فرمبسته نمیتواند انجام دهد. مدل رگرسیون نشانههای بیشتری از خود آموزش میبیند، مانند تواتر ارزیابی، سیاست ذخیرهٔ چکپوینت، بار هر GPU و شیوهٔ فاینتیونینگ، و تعاملهای غیرخطی میان آنها را از اجراهای گذشته یاد میگیرد.
برآوردی که همه به کار میبرند فقط محاسبات را در نظر میگیرد
برای یک Transformer متراکم، هزینهٔ آموزش تقریباً 6·P·D عملیات اعشاری شناور است، که در آن P تعداد پارامترها و D تعداد توکنهای آموزش است. این مقدار را بر توانی که GPUهای شما میتوانند ارائه دهند تقسیم کنید تا زمان حلقهٔ آموزش به دست آید:
T_theoretical = (6 · P · D) / (N_GPU · FLOPS_peak · MFU)در اینجا N_GPU تعداد GPUهاست، FLOPS_peak اوج توان یک GPU بر اساس مشخصات فنی آن است و MFU (بهرهوری FLOP مدل) کسری از این اوج است که آموزش در عمل به آن میرسد. کارهای واقعی هرگز با اوج توان اجرا نمیشوند، چون ترافیک حافظه، ارتباطات و ناکارآمدی هستهها مانع میشوند؛ بنابراین MFU معمولاً جایی بین ۳۰٪ و ۶۰٪ قرار میگیرد و مقدار درست برای یک کار مشخص از پیش معلوم نیست.
این توصیف خوبی از حلقهٔ بهینهسازی است. اما یک کار چیزی بیش از حلقهاش است. پیش از نخستین گام، راهاندازی محیط، دانلود و بارگذاری مدل و توکنسازی انجام میشود. در طول آموزش، ارزیابیهای دورهای و بارگذاری چکپوینتها هست. در پایان، مدل نهایی به ذخیرهسازی شیءگرا منتقل میشود. روی یک خوشهٔ چندمستأجری، همهٔ اینها بر سر شبکه و I/O ذخیرهسازی با کارهای دیگر رقابت میکنند.
این سربازها به پیکربندی بستگی دارند و با حجم کار یا تعداد GPU بهطور منظم مقیاس نمیشوند. دو کار با محاسبات اسمی یکسان میتوانند چند ساعت با هم اختلاف در زمان پایان داشته باشند.
برای اینکه مقایسه منصفانه بماند، خط پایهٔ FLOP که میآزماییم توکنهای ارزیابی زمانبندیشده را نیز علاوه بر توکنهای آموزش در نظر میگیرد و MFU را در بازهٔ گستردهای جاروب میکنیم.
آنچه ساختیم
ما زمان پایانبهپایان را یک مسئلهٔ رگرسیون نظارتشده در نظر میگیریم. با داشتن یک بردار ویژگی که از پیکربندی کار و فرادادهٔ مدل ساخته میشود، زمان واقعی سپریشده بین لحظهای که کار GPUهایش را میگیرد و لحظهای که تمام میشود پیشبینی میشود. زمان صف در این محاسبه لحاظ نمیشود.
دو انتخاب طراحی، مسیر کار را شکل داد:
همه چیز پیش از ارسال کار معلوم است. هر ورودی از پیکربندی ارسالشده میآید: ابرپارامترها، اندازهٔ مجموعهدادهها، شناسهٔ مدلها و تخصیص GPU. هیچ گزارش زمان اجرا و هیچ پیشرفت جزئیای در کار نیست. همین است که پیشبینی را برای زمانبندی قابل استفاده میکند.
ویژگیهایی که سربازها را آشکار میکنند. علاوه بر پیکربندی خام، کمیتهایی مانند num_eval_data (تعداد نمونههای پردازششده در همهٔ چرخههای ارزیابی)، num_saves و num_params_saved (حجم I/O چکپوینت) و حجم توکن بهازای هر GPU را میسازیم. خود برآورد FLOP، با MFU ثابت ۰٫۴۵، بهعنوان یک ویژگی دیگر (baseline_time) وارد میشود تا مدل از عدد محاسباتی شروع کند و تصحیحها را یاد بگیرد.
ما رگرسیون خطی، Ridge، XGBoost و CatBoost را مقایسه کردیم. انتخاب ویژگی ترکیبی از فیلترکردن بر اساس همبستگی، اطلاعات متقابل و اهمیت جایگشتی را در ۱۸ مجموعهٔ ویژگی نامزد به کار گرفت و پس از آن جستوجوی شبکهای با معیار MAE انجام شد. مدل نهایی CatBoost از ۲۴ ویژگی استفاده میکند.
دادهها
۲۷۲ اجرای SFT از گزارشهای عملیاتی یک محیط تولیدی سازمانی، شامل چند خانوادهٔ مدل تا ۱۵ میلیارد پارامتر، هر دو روش LoRA و فاینتیونینگ کامل، و طیف گستردهای از اندازههای مجموعهداده و ابرپارامترها.
زیرساخت مشترک. کارها روی ۱، ۲ یا ۴ GPU از استخری با ۸ تا ۳۲ NVIDIA H200 در ۱ تا ۴ گره اجرا شدند، در کنار دیگر بارهای آموزش و استنتاج. زمانهای اندازهگیریشده شامل رقابت واقعی بر سر منابع است.
مدتها از ۱٫۶ تا ۱۷۲٫۴ ساعت، با میانگین ۲۳٫۴۳ ساعت و میانهٔ ۱۵٫۲۹ ساعت.
پشتهٔ نرمافزاری: Hugging Face Transformers و Unsloth. ما پشته را یک ویژگی مقولهای در نظر میگیریم و هیچ فرضی دربارهٔ سرعتبخشی ثابت میان این دو نمیکنیم.
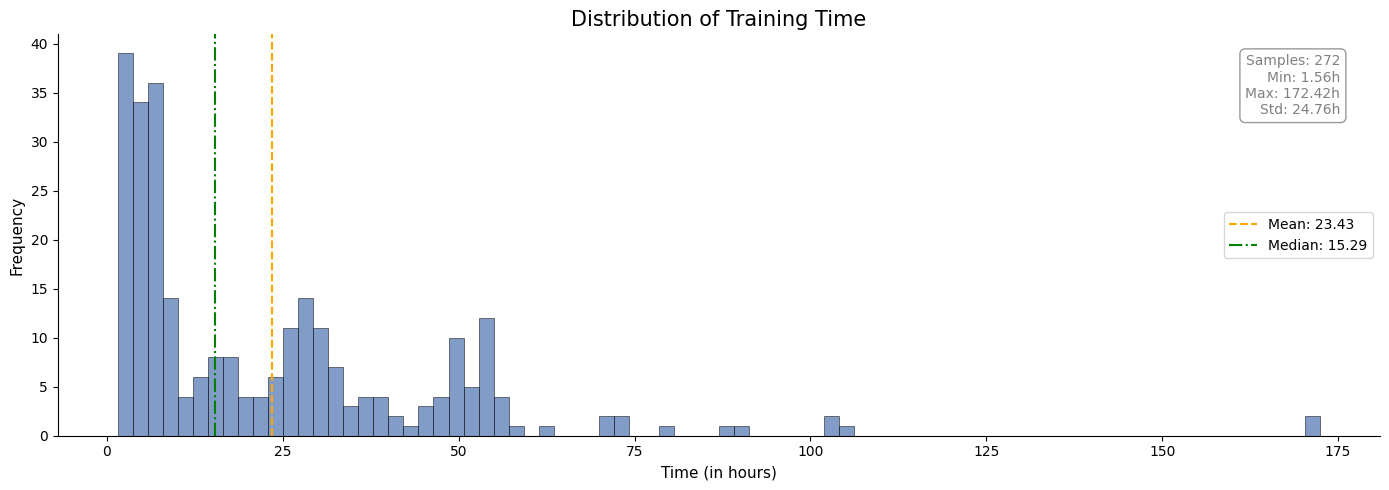
توزیع زمان پایانبهپایان در ۲۷۲ اجرا. میانگین ۲۳٫۴۳ ساعت، میانهٔ ۱۵٫۲۹ ساعت.
نتایج
همهٔ اعداد از اعتبارسنجی متقابل ۵-تایی لایهبندیشده به دست آمدهاند. چهار سطر اول تحلیلیاند و هیچ برازشی در آنها انجام نشده است.
مدل | R² | RMSE (ساعت) | MAE (ساعت)
خط پایهٔ FLOP (MFU ۳۰٪) | 0.31 | 20.45 | 12.41
خط پایهٔ FLOP (MFU ۴۵٪) | 0.18 | 22.38 | 13.01
خط پایهٔ FLOP (MFU ۶۰٪) | 0.01 | 24.56 | 14.62
Calculon | −0.51 | 30.40 | 20.36
رگرسیون خطی | 0.69 ± 0.14 | 13.52 ± 4.23 | 7.52 ± 0.49
Ridge | 0.73 ± 0.09 | 12.72 ± 3.70 | 7.23 ± 0.68
XGBoost | 0.97 ± 0.01 | 4.18 ± 1.17 | 1.95 ± 0.32
CatBoost | 0.98 ± 0.01 | 3.52 ± 0.78 | 1.71 ± 0.33
چند نکته برجسته است.
هیچ مقدار واحدی از MFU خط پایه FLOP را درست نمیکند. MFU را از ۰٫۲۵ تا ۰٫۶۵ جاروب کردیم. بهترین تنظیم، ۳۰٪، هنوز میانگین خطایی بالای ۱۲ ساعت روی کارهایی بر جای میگذارد که بهطور میانگین ۲۳ ساعت طول میکشند.
یک مدل تحلیلی دقیقتر هم این فاصله را پر نمیکند. بهعنوان خط پایه دوم، Calculon را برگرفتیم (Isaev et al., SC '23)، یک مدل عملکرد تحلیلی برای آموزش LLM از کار پیشین. این مدل یک گراف صریح از لایهها میسازد و محاسبات، ترافیک حافظه و ارتباطات میان دستگاهها را در نظر میگیرد. ما پیادهسازی عمومی آن را گسترش دادیم تا LoRA، توجه پرسوجوگروهی، توجه ادغامشده، bfloat16 و SwiGLU را پوشش دهد. با این حال، تخمینهای آن تنها با میانه ۱۱٪ از زمان واقعی سپریشده مطابقت دارد. این نکته چیزی علیه Calculon بهعنوان ابزاری برای تحلیل گامبهگام نمیگوید، چون برای همین کار طراحی شده است. نشان میدهد چه بخش بزرگی از یک کار تولیدی بیرون از گام بهینهسازی رخ میدهد.
مدلهای خطی کمک میکنند و بعد متوقف میشوند. Ridge خطای MAE را به ۷٫۲۳ ساعت میرساند. رابطه میان پیکربندی و مدتزمان با یک مدل کاملاً خطی بهخوبی توصیف نمیشود.
بوستینگ گرادیانی بخش اصلی کار را انجام میدهد. CatBoost و XGBoost در هر معیار در فاصله یک انحراف معیار از هم قرار میگیرند. CatBoost را جلو میبریم چون در همه معیارها کمترین میانگین خطا را دارد.
پیشبینیکننده به چه چیزهایی تکیه میکند
اهمیت ویژگی در CatBoost روی چند ویژگی متمرکز است. متغیرهای مدل و حجم کار همانطور که انتظار میرود حضور دارند، اما متغیرهای ارزیابی و چکپوینت هم هستند. num_eval_data، یعنی تعداد کل نمونههای پردازششده در ارزیابی در طول عمر کار، رتبه اول را دارد و پس از آن num_trainable_params، batch_eval_size_percent، num_all_params و num_gpus*batch_train_percent قرار میگیرند و num_params_saved کمی بعدتر است. مقادیر SHAP هم همین داستان را میگویند: حجم بالای ارزیابی بهطور پیوسته زمان پیشبینیشده را بالا میبرد، در حالی که تعداد پارامترهای قابل آموزش اثری غیرخطی دارد که تنها برای بزرگترین مدلها بزرگ میشود.
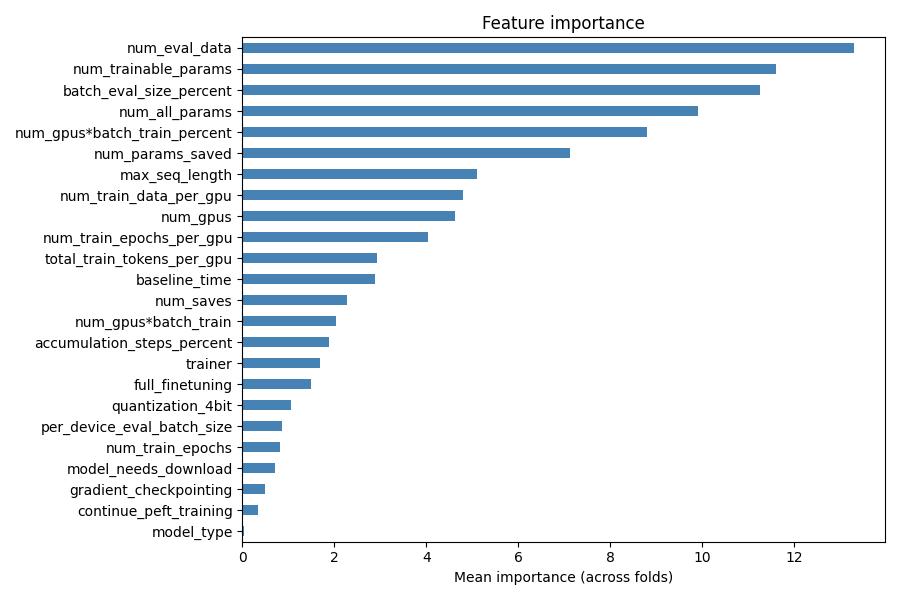
میانگین اهمیت ویژگی مدل CatBoost در تاشوها (PredictionValuesChange).
اهمیت ویژگی ادعای علیت نیست. با این حال، این الگو با نحوه صرف زمان یک کار همخوانی دارد. اینکه هر چند وقت یکبار ارزیابی میکنید، مجموعه ارزیابی چقدر بزرگ است و چند چکپوینت نگه میدارید، همه در کنار مقیاس مدل و مجموعهداده، زمان واقعی سپریشده را شکل میدهند. اینها انتخابهایی هستند که افراد هنگام نوشتن پیکربندی آموزش اغلب از روی عادت انجام میدهند.
یک هشدار درباره خواندن نمودارها: تخصیصهای بزرگتر GPU سهم مثبتی در زمان پیشبینیشده نشان میدهند. در دادههای ما، تخصیصهای بزرگتر با کارهای بزرگتر همراهاند، بنابراین num_gpus تا حدی نقش پروکسی مقیاس کار را دارد. این به معنای آن نیست که افزودن GPU کار را کندتر میکند.
چقدر خطا دارد و کجا
با نگاه به همه ۲۷۲ پیشبینی خارج از تاشو، میانه خطای مطلق ۰٫۵۱ ساعت است. ۸۰٪ پیشبینیها در محدوده ۲٫۲۰ ساعت و ۹۰٪ در محدوده ۴٫۳۱ ساعت قرار دارند. به تفکیک مدتزمان کار:
مدتزمان کار (ساعت) | تعداد اجرا | میانه خطای مطلق (ساعت) | P90 (ساعت)
۱٫۵۶ تا ۵ | ۶۰ | 0.30 | 1.55
۵ تا ۱۰ | ۶۳ | 0.18 | 1.27
۱۰ تا ۳۰ | ۶۹ | 0.73 | 4.17
۳۰ تا ۶۰ | ۶۷ | 1.06 | 5.50
۶۰ تا ۱۷۵ | ۱۳ | 5.19 | 18.51
تا ۶۰ ساعت، میانه خطا حدود یک ساعت یا کمتر میماند. مدل در دنباله بلند دچار مشکل میشود و با تنها ۱۳ اجرای بالای ۶۰ ساعت، این را محدودیت داده میدانیم.
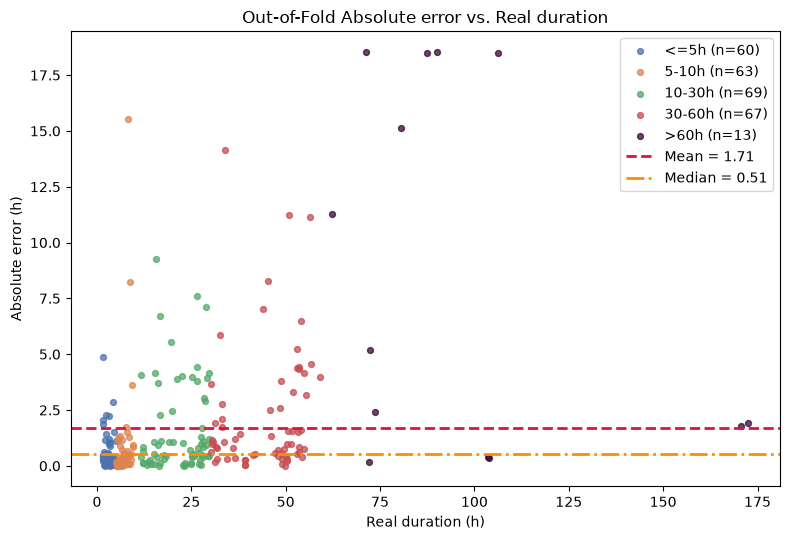
خطای مطلق خارج از تاشو در برابر مدتزمان واقعی، با رنگبندی بر اساس بازه مدتزمان. خطاها تا ۶۰ ساعت پایین میمانند و در دنباله کمتراکم بیشتر میشوند.
داده بیشتر باید همچنان کمک کند. روی یک مجموعه نگهداشته ثابت ۲۰٪، وقتی از ۸۵٪ به ۱۰۰٪ بخش آموزش میرویم، MAE از ۱٫۶۳ ساعت به ۱٫۵۰ ساعت کاهش مییابد، بدون آنکه فلات مشخصی دیده شود.
به چه کاری میآید
در عمل، این پیشبینیکننده به زمانبند یک مدتزمان میدهد که میتواند پیش از شروع کار روی آن برنامهریزی کند: کدام کارها با هم اجرا شوند، چه زمانی GPUها آزاد میشوند و آیا یک اجرا بهموقع به موعد تحویلش میرسد یا نه.
محدودیتها
فقط SFT. ما دیگر راهبردهای آموزش و همترازی مانند RLHF، DPO یا RLVR را در نظر نگرفتیم.
فقط یک نوع GPU. همهٔ اجراها از NVIDIA H200 استفاده کردند. مدل برازششده برای همین زیرساخت کالیبره شده است و نباید انتظار داشت بدون بازآموزی، اعداد آن به نسلهای دیگر GPU منتقل شود. یک پیشبینیکننده برای استخرهای ترکیبی به توصیفگرهای سختافزاری مانند توان محاسباتی، ظرفیت حافظه، پهنای باند و توپولوژی اتصال میانوصل هم نیاز خواهد داشت.
اجراهای بسیار طولانی کم هستند. خطاها بالای ۶۰ ساعت بیشتر میشوند.
آنچه منتقل میشود روش کار است: ویژگیهای آگاه از سرباز، انتخاب ویژگی با در نظر گرفتن همخطی چندگانه و پروتکل مقایسه. مقاله کامل، فرمولهای ویژگی، رویه انتخاب، فضاهای جستوجو و ابرپارامترهای نهایی را بهطور کامل گزارش خواهد کرد تا این خط لوله روی هر مجموعه داده گزارش اجرا با ساختار مشابه قابل بازسازی باشد.
قدم بعدی فهرست ما: توصیفگرهای مخصوص سختافزار و اعتبارسنجی روی انواع دیگر GPU، یادگیری انتقالی برای پیکربندیهایی که مشاهدات کمی دارند، اهداف آموزشی دیگر و داده بیشتر درباره اجراهای طولانی.
قدم بعدی
مقاله کامل بهزودی در arXiv منتشر میشود. سازمان Dharma-AI را در Hugging Face دنبال کنید تا از انتشار آن باخبر شوید و پرسشهایتان را در بخش نظرات پایین بگذارید. دوست داریم بشنویم شما مدتزمان کار را روی خوشههای خودتان چگونه برآورد میکنید.
بیشتر بخوانید
مدیریت GPU: چرا GPUهای بیکار هواپیمای زمینگیرشده جدیدند
همان خوشه، ۳۳ واحد درصد بهرهوری بیشتر: آنچه تغییر کرد ترتیب بود
چگونه تخصصیکردن واژگان مدلهای زبانی کوچک میتواند هزینه استنتاج را در کاربردهای واقعی ۷۷٪ کاهش دهد
تخصص بر مقیاس پیشی میگیرد: متغیر راهبردیای که بیشتر تصمیمهای خرید هوش مصنوعی از آن غافل میمانند
چرا تخصص اجتنابناپذیر است
مدلهای جدیدتر، همان مزیت
بهینهسازی ترجیح مستقیم فراتر از چتباتها
انحطاط متن: یک حالت شکست در محیط تولید که بیشتر بنچمارکها آن را رصد نمیکنند
تحقیق و توسعه Dharma-AI · ما هوش مصنوعی را مدل شما میکنیم
 نگار رضایی
 آرمان کریمی