 نگار رضایی
امروز Rumble-2-Flash را با مجوز Apache 2.0 بهصورت متنباز منتشر میکنیم. این یک مدل تشخیص گفتار با ۰٫۵ میلیارد پارامتر برای بیش از ۴۰ زبان است که با مدلهایی ۳ تا ۶۰ برابر بزرگتر از خودش رقابت میکند.
هر جایی اجرا میشود: پشتیبانی بومی در 🤗 Transformers و vLLM، بدون نیاز به کد اختصاصی
بیش از ۴۰ زبان: تشخیص خودکار زبان
کنترل خروجی: نمایش اعداد بهصورت رقم یا واژه، پرکنندهها، تکرارهای عیناً بازتولیدشده، و زبان اجباری
بسیار سریع: یک ساعت صوت در حدود نیم ثانیه، با بیش از ۷٬۰۰۰ RTFx روی دستههای پر
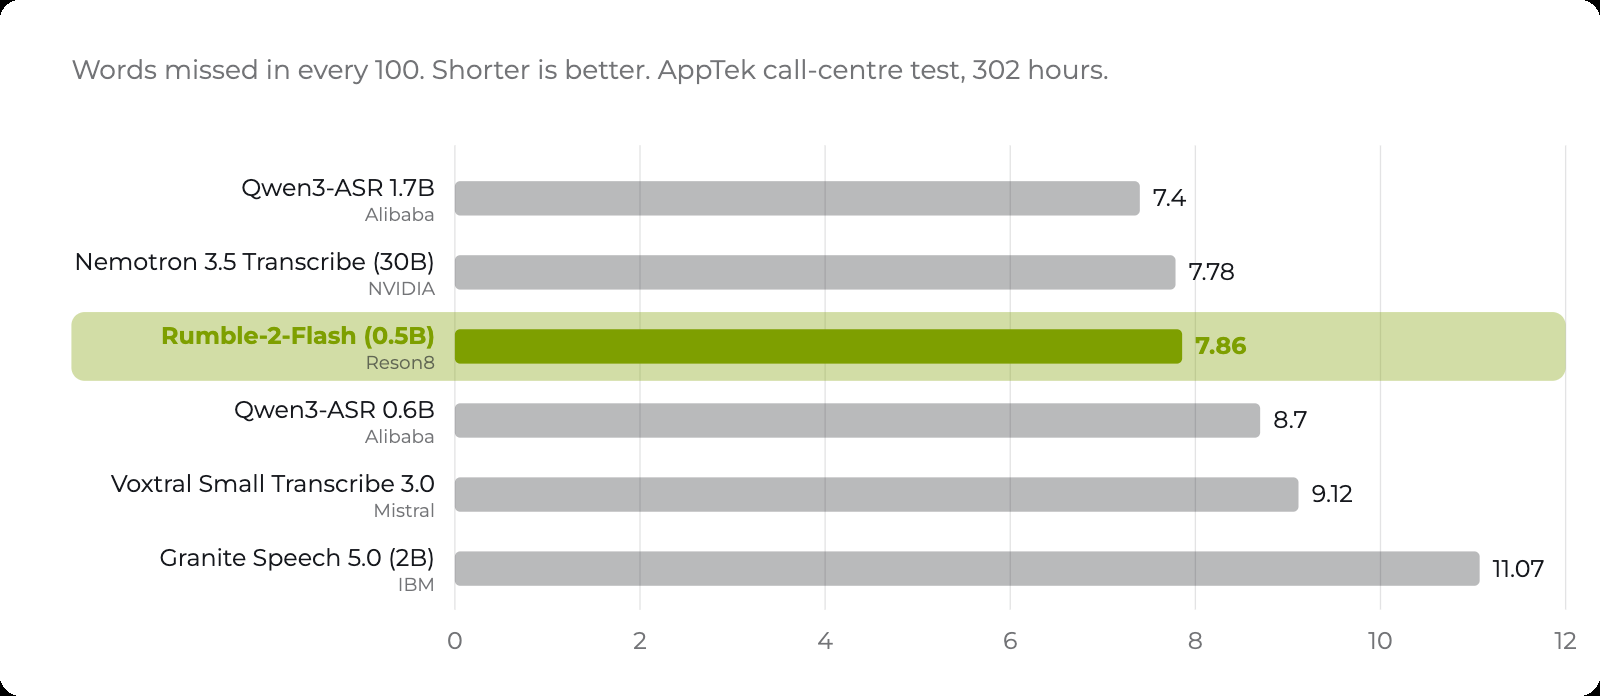
روی تماسهای واقعی تلفنی هم دوام میآورد: همسطح Nemotron 3.5 Transcribe (30B) شرکت NVIDIA روی یک بنچمارک ۳۰۲ ساعتهٔ مرکز تماس
شروع سریع
uv pip install torch transformers acceleratefrom transformers import AutoProcessor, AutoModelForMultimodalLM
model_id = "Reson8/Rumble-2-Flash"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")
inputs = processor.apply_transcription_request(
audio="https://hf.co/datasets/hf-internal-testing/dummy-audio-samples/resolve/main/bcn_weather.mp3",
language="English", # omit to detect automatically
).to(model.device, dtype=model.dtype)
output = model.generate(**inputs, max_new_tokens=512)
generated = output[:, inputs["input_ids"].shape[-1]:]
print(processor.decode(generated, return_format="transcription_only")[0]) # return_format="parsed" if detecting languageپارامتر audio یک مسیر محلی، یک URL، یک آرایهٔ NumPy یا فهرستی از اینها را میپذیرد.
نحوهٔ ساخت
Rumble-2-Flash از معماری Qwen3-ASR استفاده میکند تا از همان روز اول پشتیبانی شود. اگر زیرساخت شما Transformers یا vLLM را اجرا میکند، Rumble-2-Flash را هم اجرا میکند، بدون نیاز به رانتایم فورکشده یا trust_remote_code.
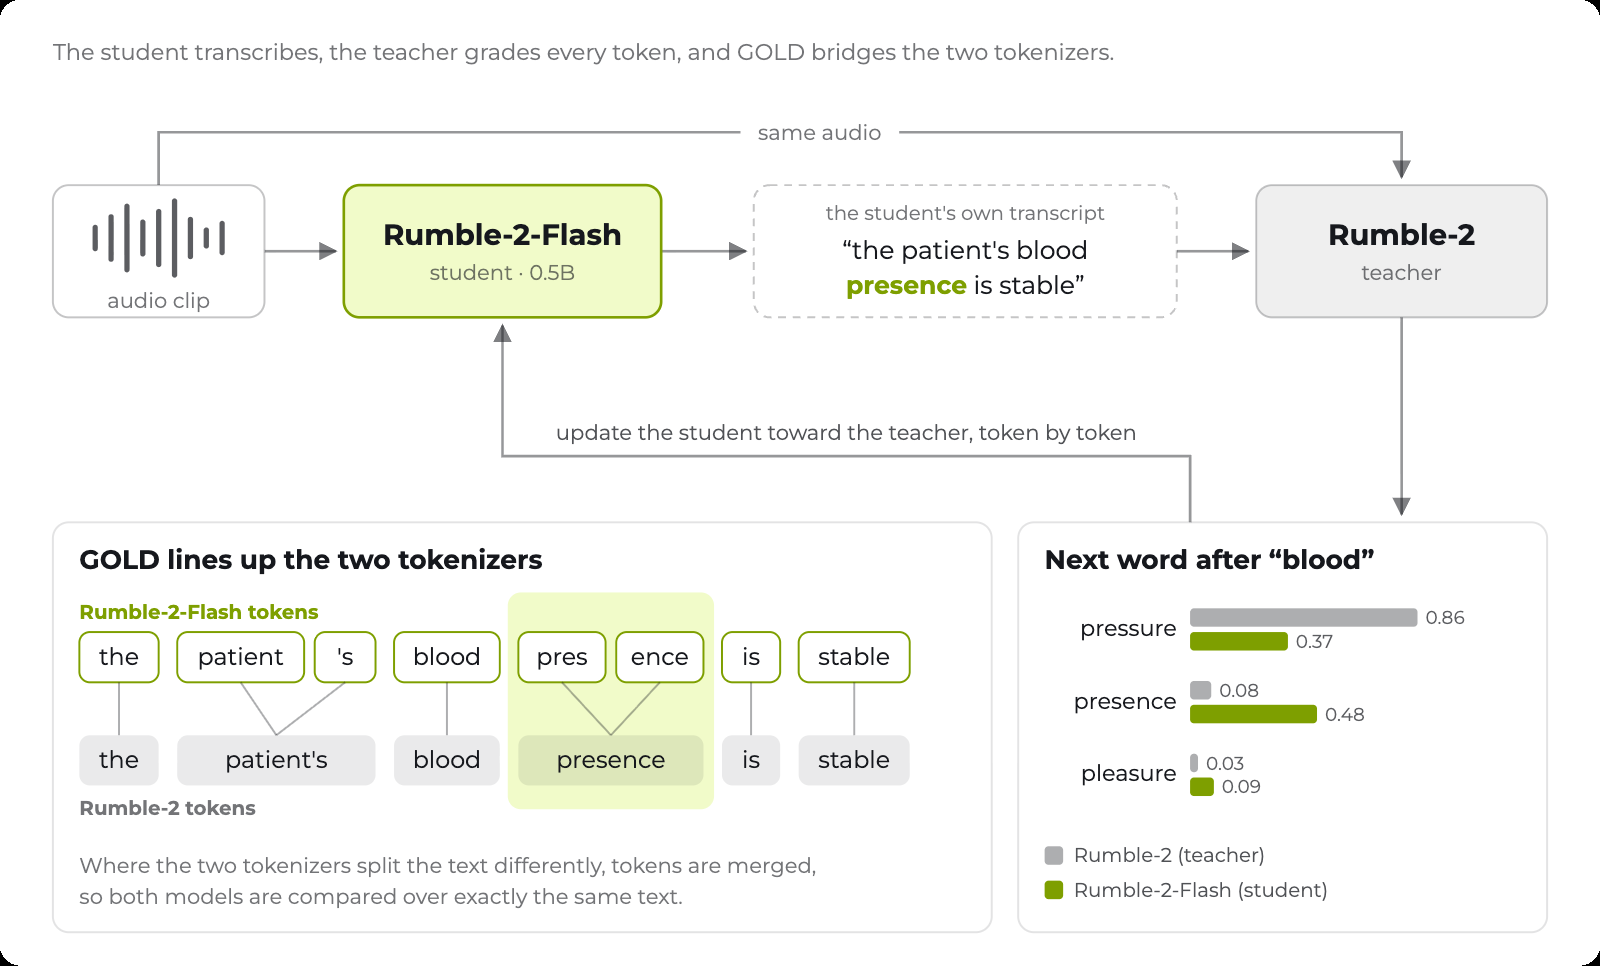
برای اینکه بفهمیم دقت مدل تا چه اندازهٔ کوچکی پایین نمیآید، Rumble-2، مدل بزرگتر تولیدیمان، را با تقطیر بر اساس سیاست خود دانشآموز به آن تقطیر کردیم. دانشآموز روی رونوشتهایی که معلم نوشته آموزش نمیبیند. خودش صوت را رونویسی میکند و معلم آن رونوشت را توکنبهتوکن نمره میدهد: در هر موقعیت، احتمال خودش را برای توکن بعدی میدهد و دانشآموز یاد میگیرد با آن همتراز شود. چون دانشآموز از خروجیهای خودش یاد میگیرد، دقیقاً روی همان اشتباهاتی که مرتکب میشود اصلاح میشود؛ بازخوردش برای هر توکن است، نه یک نمره برای هر کلیپ.
تقطیر بر اساس سیاست خود دانشآموز معمولاً نیاز دارد که معلم و دانشآموز توکنساز مشترک داشته باشند، اما توکنسازهای ما مشترک نیستند: انتخاب Qwen3-ASR یعنی واژگان آن را هم پذیرفتیم. GOLD این محدودیت را برمیدارد. توکنهایی را که دو توکنساز متن را متفاوت تقسیم میکنند ادغام میکند تا هر دو مدل روی متن یکسان مقایسه شوند. توکنهایی که در هر دو واژگان وجود دارند مستقیم مقایسه میشوند و بقیه بر اساس احتمال مرتبشدهشان.
نتایج
دقت در حد اندازهاش
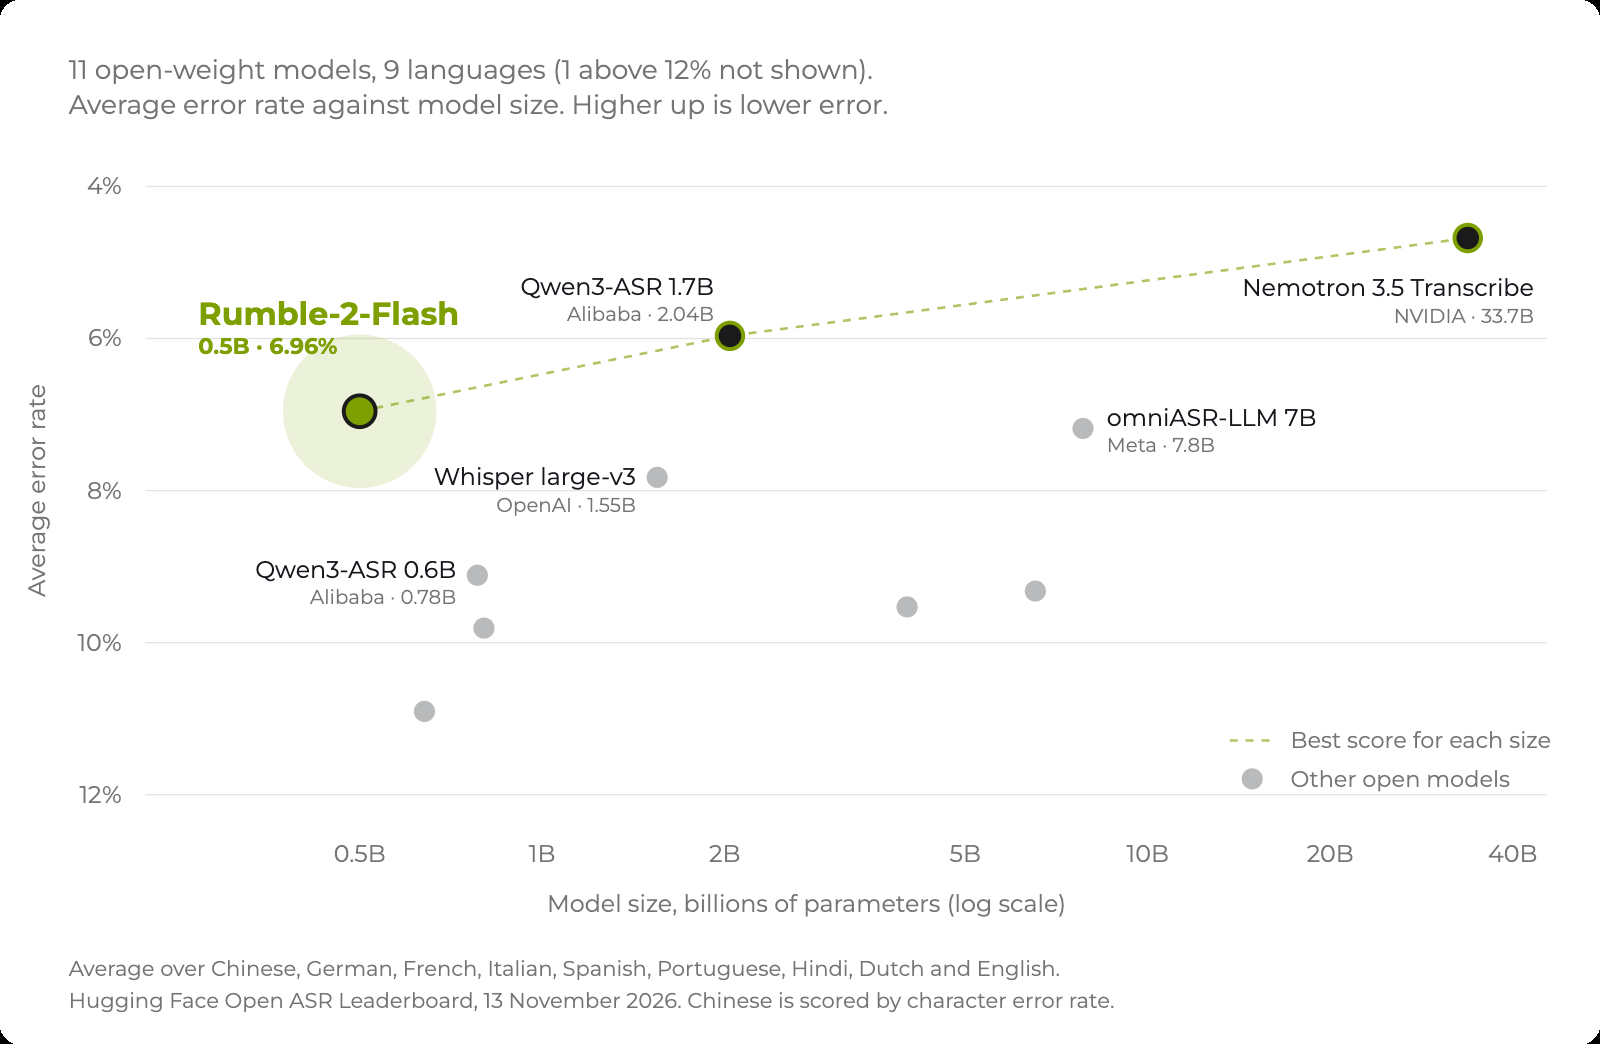
Rumble-2-Flash در مسیر چندزبانهٔ Open ASR Leaderboard بهطور میانگین نرخ خطای ۶٫۹۶٪ را در چینی، آلمانی، فرانسوی، ایتالیایی، اسپانیایی، پرتغالی، هندی، هلندی و انگلیسی ثبت میکند. این بهتر از omniASR-LLM 7B شرکت Meta، مدلی ۱۵ برابر بزرگتر، و جلوتر از Whisper large-v3 است. در مسیر انگلیسی، میانگین WER آن ۶٫۶٪ است.
سرعت
Rumble-2-Flash سریع هم هست. توان عبوری آن به میزان پر بودن دستهها بستگی دارد: روی دادههای بزرگتر در Open ASR Leaderboard شرکت HF که دستهها پر میمانند، به بیش از ۷٬۰۰۰ RTFx میرسد. یعنی یک ساعت صوت در حدود نیم ثانیه.
تماسهای واقعی تلفنی
صوت تمیز آسان است. تماسهای تلفنی فشرده و نویزیاند و اغلب گویندگانی با لهجههای بسیار متفاوت دارند. روی بنچمارک مرکز تماس AppTek (۳۰۲ ساعت تماس خط کمک، ۱۴ لهجهٔ انگلیسی، امتیازدهیشده با اسکریپت خود AppTek)، Rumble-2-Flash به WER ۷٫۸۶٪ میرسد که همسطح Nemotron 3.5 Transcribe (30B) شرکت NVIDIA با ۷٫۷۸٪ است. این نتیجه بهمراتب جلوتر از Qwen3-ASR 0.6B (۸٫۷٪) از همان خانوادهٔ مدل است و به Qwen3-ASR 1.7B (۷٫۴٪) نزدیک است؛ تنها مدلی در این مقایسه که بهتر عمل میکند.
امتحانش کنید
وزنها روی Hub در Reson8/Rumble-2-Flash قرار دارند. از طریق API ما هم در دسترس است.
خیلی کنجکاویم ببینیم با آن چه میسازید. در تب Discussions به ما بگویید چه ساختهاید، چه چیزی را دوست دارید و در نسخهٔ بعدی چه تغییری میخواهید ببینید.
 سارا نادری
 آرمان کریمی