 سارا نادری
پیشبینی، تشخیص ناهنجاری و بهینهسازی بلادرنگ، با تکیه بر مدلهای سریزمانی IBM که بیش از ۵۰ میلیون بار دانلود شدهاند. این مدلها اکنون بهصورت بومی در Confluent، هم در فضای ابری و هم درونسازمانی، و روی CPUها اجرا میشوند.
هر کسبوکار رکوردی پیوسته از تغییر تولید میکند: یک قرائت دستگاه، یک پرداخت، یک فروش، یک سفارش یا تغییری در موجودی. این مشاهدات سریهای زمانی را میسازند و نشانههایی در خود دارند که میتواند به تیمها کمک کند آنچه در ادامه رخ میدهد را پیش از موعد ببینند.
چالش اصلی، تبدیل این نشانهها به تصمیم در همان زمانی است که هنوز اهمیت دارند. پیشبینیای که پس از پایان یک نوبت تولید، پس از اتمام موجودی یا پس از تأیید یک پرداخت برسد، ممکن است دقیق باشد اما برای اثرگذاری بر نتیجه دیر شده باشد.
IBM و Confluent مدلهای بنیادی سریزمانی را به دادهها، همانطور که در جریاناند، نزدیکتر میکنند. تیمها با Apache Flink میتوانند پیشبینی، تشخیص ناهنجاری و هوش معنایی را با SQL روی دادههای جریانی اعمال کنند و خروجی مدل را در اختیار برنامهها و افرادی بگذارند که مسئول اقدام بعدیاند.
مدلهای بنیادی شیوه کار سازمانها با متن، تصویر و سند را تغییر دادهاند. مدلهای بنیادی سریزمانی ایدهای مشابه را به دادههای عددی گسترش میدهند: از دادههای تاریخی متنوع، الگوهای عمومی را میآموزند و سپس آن دانش را به سریها و وظایف تازه اعمال میکنند. این مدلها میتوانند نقطه شروعی فراهم کنند بدون آنکه تیمها مجبور باشند برای هر سری زمانی مدل جداگانهای آموزش دهند. بسته به وظیفه و نحوه استقرار، تیمها میتوانند مدل را ریزتنظیم کنند یا خروجی آن را با دادهها و منطق کسبوکار دیگری ترکیب کنند.
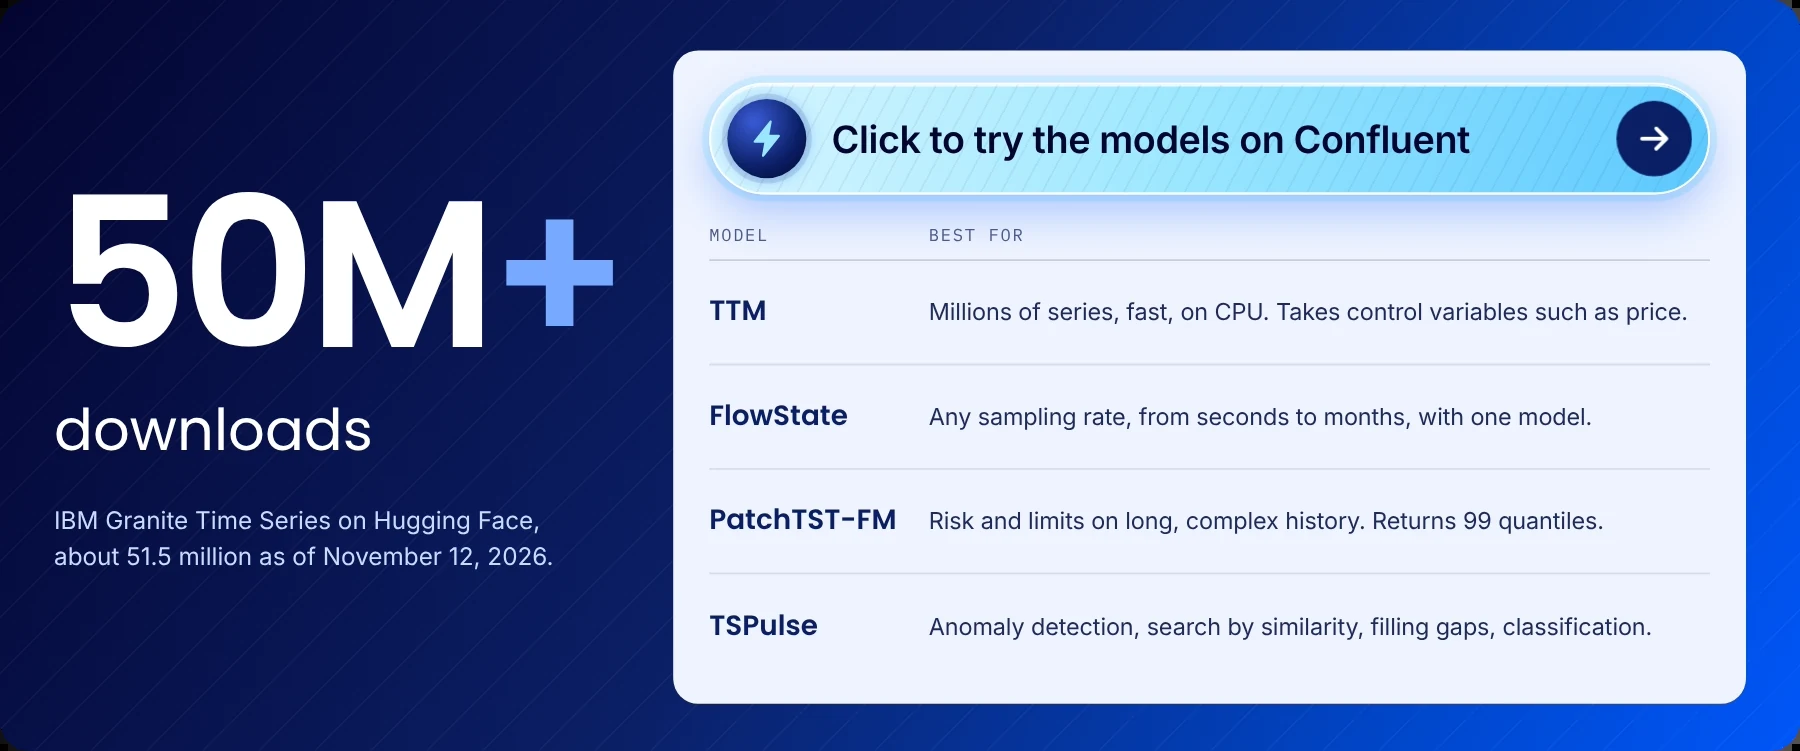
شکل ۱. بیش از ۵۰ میلیون دانلود و خانوادهای از چهار مدل که پشت آنها قرار دارد
اکنون مدلهای بنیادی سریزمانی بهصورت بومی درون Confluent و بهشکل توابع داخلی، هم در فضای ابری و هم درونسازمانی اجرا میشوند. در Confluent Cloud این مدلها کاملاً مدیریتشدهاند و چیزی برای استقرار وجود ندارد (مستندات). در محیط درونسازمانی، مدلها میتوانند با Confluent Platform for Apache Flink در زیرساخت خودتان اجرا شوند (مستندات). این مدلها روی CPU اجرا میشوند و به GPU نیاز ندارند.
این مدلها میتوانند طیفی از کاربردهای حیاتی را پشتیبانی کنند؛ از کمک به نگهداشتن خطوط تولید در محدوده مشخصات و تشخیص فعالیت غیرعادی فروشگاهها تا بهبود برنامهریزی در سطح محصول. همچنین میتوانند نشانههایی برای ارزیابی پرداختهای کارتی و پیشبینی حجم معاملات فراهم کنند تا سفارشهای بزرگ بهتر ثبت شوند. این بلوکهای سازنده را میتوان در تولید، خردهفروشی، بانکداری و خطوط هوایی به کار گرفت و بینش را به جایی که تصمیمها گرفته میشوند نزدیکتر کرد.
ببینید سریهای زمانی و زمینه بلادرنگ چگونه در کنار هم ارزش میسازند:
Streamhouse: داده و هوش بلادرنگ برای عصر عاملهای هوشمند
کسبوکارها بیوقفه کار میکنند. سفارشها بهروزرسانی میشوند، پرداختها میرسند، محمولهها با تأخیر مواجه میشوند و موجودی در طول روز تغییر میکند. با این حال، اطلاعات پشت این رویدادها اغلب در سیستمهایی پراکنده است که در زمانهای مختلف بهروزرسانی میشوند یا به فرایندهای دستهای دورهای وابستهاند. وقتی برنامهها و عاملهای هوش مصنوعی بر پایه اطلاعات قدیمی یا ناسازگار عمل میکنند، خطر تصمیمهایی را دارند که دیگر واقعیت جاری را بازتاب نمیدهند.
Streamhouse این مشکل را با ثبت، پردازش، حاکمیت و ارائه پیوسته زمینه جاری کسبوکار حل میکند. پلتفرم جریان داده Confluent پنج قابلیت را کنار هم میآورد—اتصال، جریاندهی، پردازش، حاکمیت و پرسوجو—تا این زمینه در دسترس برنامهها، تحلیلها و عاملها قرار گیرد. Apache Flink داده را همانطور که در جریان است تبدیل و غنی میکند و Lightning Tables دسترسی کمتأخیر به وضعیت جاری را فراهم میکنند.
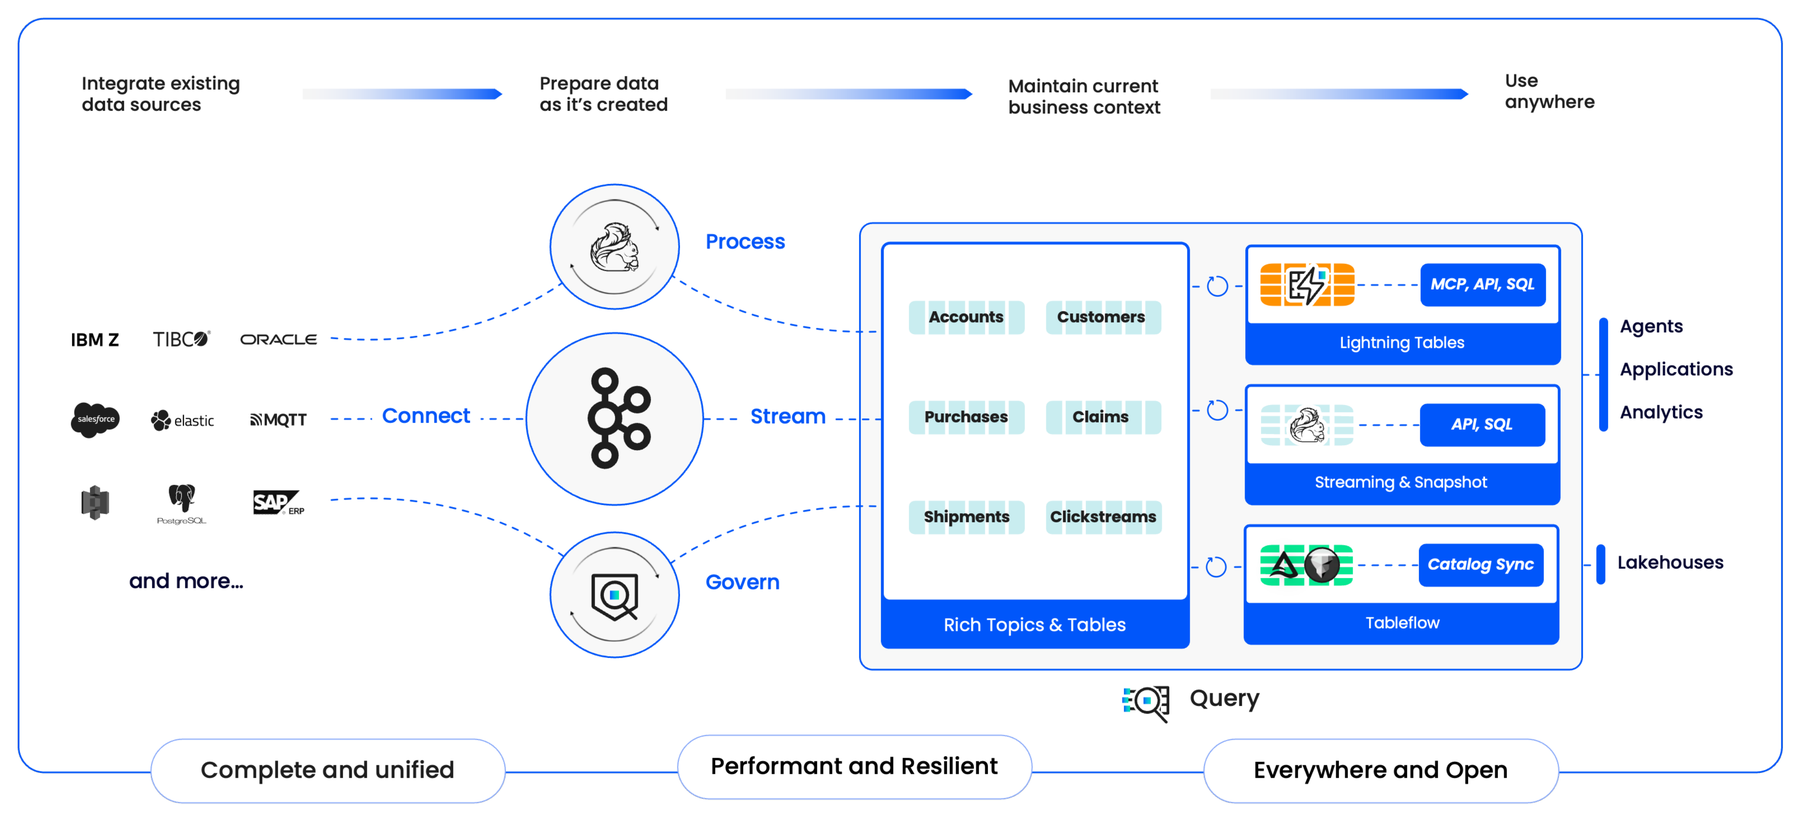
شکل ۲. Streamhouse روی Confluent: از منابع داده موجود تا زمینه جاری کسبوکار که عاملها، برنامهها، تحلیلها و دریاچههای داده در هر جا از آن استفاده میکنند.
مدلهای سریزمانی به این معماری توان پیشبینی اضافه میکنند. Flink میتواند داده را آماده کند، پیشبینی و تشخیص ناهنجاری را فراخوانی کند و نتایج را در کنار رویدادهایی که آنها را تولید کردهاند در دسترس بگذارد. مدلهای دیگر—از جمله مدلهای زبانی بزرگ، مدلهای آماری و سامانههای یادگیری ماشین تخصصی—هم میتوانند در جای مناسب سهم داشته باشند.
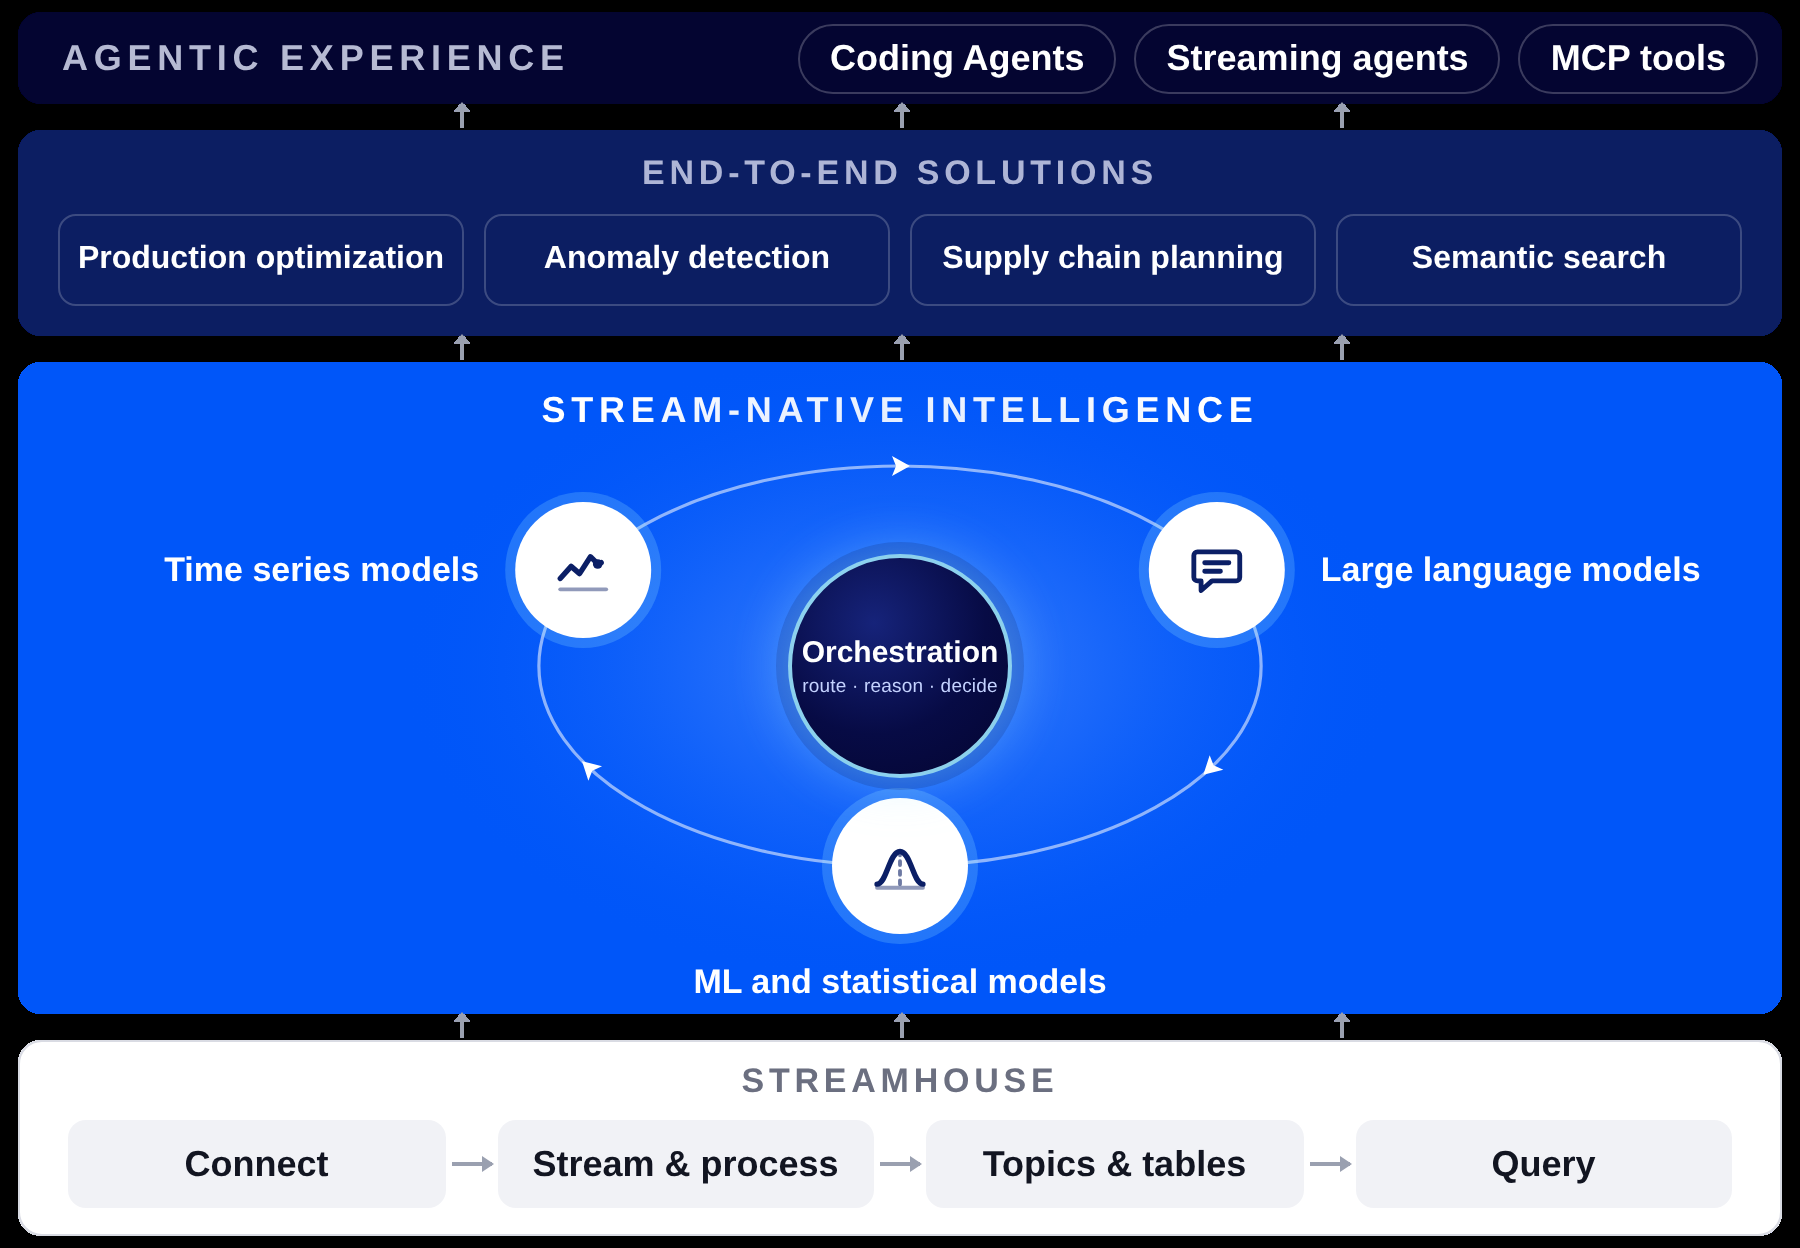
شکل ۳. لایه هوش Streamhouse: مدلهای سریزمانی، مدلهای زبانی بزرگ و مدلهای یادگیری ماشین و آماری، با هماهنگسازی میان آنها.
این رویکرد میتواند به سه شکل به تیمها کمک کند:
- مقیاسپذیری توسعه مدل. یک مدل از پیش آموزشدیده میتواند نقطه شروع مشترکی برای بسیاری از سریهای زمانی باشد و نیاز به ساخت و نگهداری مدل جداگانه برای هر سری را کاهش دهد.
- بهروزرسانی پیشبینیها همراه با تغییر دادهها. پیشبینیها میتوانند مشاهدات اخیر را بهعنوان بخشی از گردشکار جریانی در نظر بگیرند، مشروط به نیازمندیهای مدل و پیکربندی خط لوله.
- نزدیکتر کردن نشانهها به تصمیمها. پیشبینیها و ناهنجاریها میتوانند زودتر به برنامههای عملیاتی هدایت شوند تا تیمها آنها را با زمینه کسبوکار، قواعد و قضاوت انسانی ترکیب کنند.
- اجرای مدلهای سبک روی CPU. این مدلها بهاندازهای کوچکاند که میتوان آنها را در کنار خط لوله جریان، در فضای ابری یا درونسازمانی، روی CPUهای استاندارد اجرا کرد؛ کاری که میتواند نیاز به زیرساخت اختصاصی GPU را کاهش دهد و استقرار را سادهتر کند.
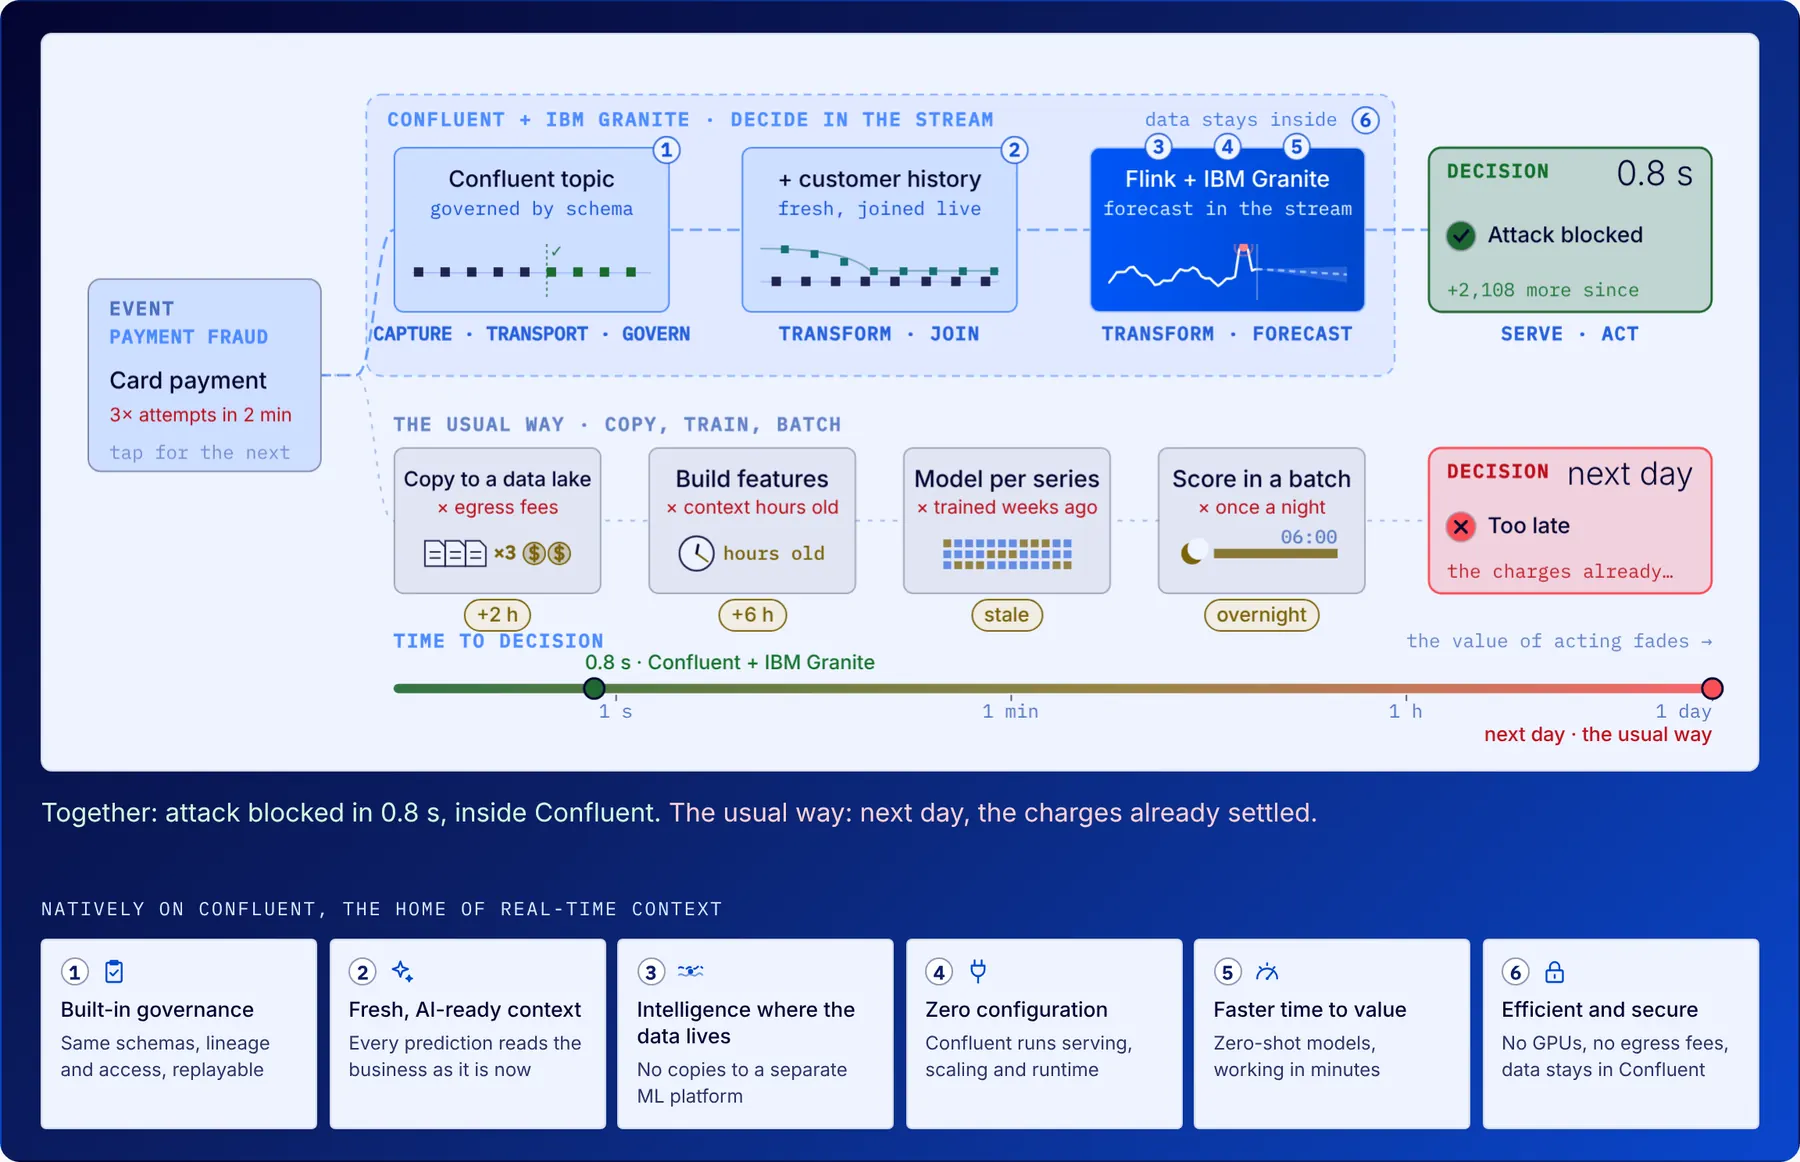
شکل ۴. هوش سریزمانی بومی جریان روی Confluent
کاربردهای حیاتی در کسبوکارهای واقعی
سناریوهای زیر نشان میدهند سازمانها چگونه میتوانند مدلهای سریزمانی، دادههای جریانی و منطق برنامه را با هم ترکیب کنند.
کاربرد ۱ | بهینهسازی تولید: هر وان در محدوده مشخصات
کیفیت یک خط تولید بستنی به هوادهی بستگی دارد—میزان هوایی که در مخلوط زده میشود. امروز مهندس فرایند و اپراتور به اندازهگیریهای آزمایشگاه تضمین کیفیت (QA) که پس از پر شدن وانها انجام میشود تکیه میکنند. اگر یک محموله خامه تازه یا یک روز گرم و مرطوب فرایند را تغییر دهد، تا زمانی که تیم نتیجه را ببیند ممکن است ساعتها تولید نیازمند دوبارهکاری شده باشد.
برای پیشدستی در برابر این مشکل، یک مدل از پیش آموزشدیده TTM هر ۱۰ دقیقه تلهمتری SCADA و اندازهگیریهای QA را میخواند. این مدل سهم وانهایی را که انتظار میرود چهار ساعت بعد در محدوده مشخصات باشند، همراه با یک بازه احتمالی پیشبینی میکند.
وقتی پیشبینی به زیر هدف کارخانه میرسد، یک فرایند بهینهسازی ترکیبهای مختلف دمای کشش فریزر و جریان هوا را ارزیابی میکند. چون مدل این متغیرهای کنترلی را بهعنوان ورودی میگیرد، میتواند هر گزینه را پیش از هر تغییری در خط امتیازدهی کند. اپراتور نقاط تنظیم پیشنهادی را تأیید میکند و تنظیمات روتین میتوانند در چارچوب حفاظهای از پیش تعیینشده خودکار شوند.
نتیجه، فرایندی پیشدستانهتر است: دوبارهکاری کمتر، مصرف انرژی کمتر به ازای هر تن و کیفیت یکدستتر. همین رویکرد را میتوان برای کورهها، خشککنها، کورههای آهک و آسیابها به کار گرفت.
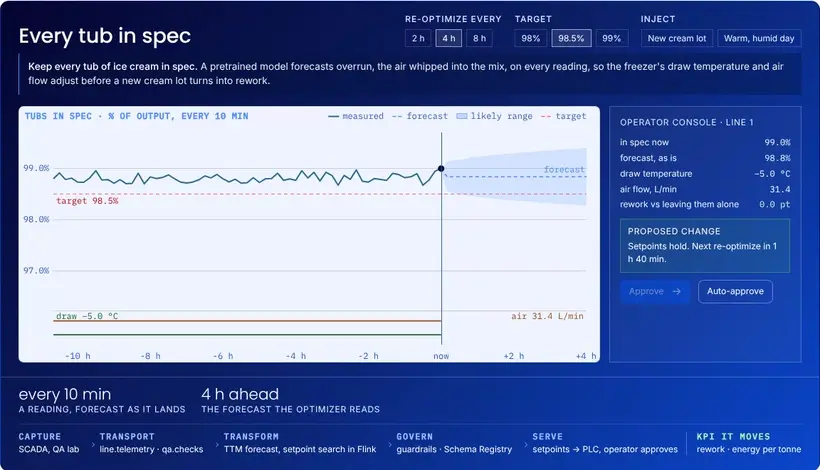
شکل ۵. پیشبینی کیفیت محصول به اپراتور کمک میکند نقاط تنظیم فریزر را پیش از اعمال تغییر ارزیابی کند.
کاربرد ۲ | تشخیص ناهنجاری: از یک هشدار تا اقدام درست
تیمی در عملیات فروشگاه، فروش هزاران محصول در صدها فروشگاه را پایش میکند. آستانههای ثابت اغلب اوجهای قابل پیشبینی آخر هفته را علامت میزنند اما تغییرات آرامتر، مانند فروش کمتر از انتظار یک محصول، را از دست میدهند. با انباشته شدن هشدارها، تشخیص اینکه تیم باید روی کجا تمرکز کند سختتر میشود.
تابع AI_DETECT_ANOMALIES به هر سری فروش، بر پایه تاریخچه اخیرش، یک بازه مورد انتظار میدهد. هر قرائت تازه در سطح اطمینانی که تیم انتخاب میکند با آن بازه مقایسه میشود، بدون آنکه برای هر محصول و هر فروشگاه مدل جداگانهای آموزش داده شود.
وقتی فروش از بازه مورد انتظار بیرون میزند، این نشانه میتواند با دادههای موجودی و فروشگاه ترکیب شود تا به شناسایی علت احتمالی و پیشنهاد اقدام بعدی کمک کند—مثلاً بررسی قفسه یا تأمین مجدد موجودی. همین رویکرد را میتوان برای حسگرهای دستگاه، تلهمتری API، قرائت کنتورها و حجم پرداختها به کار گرفت.
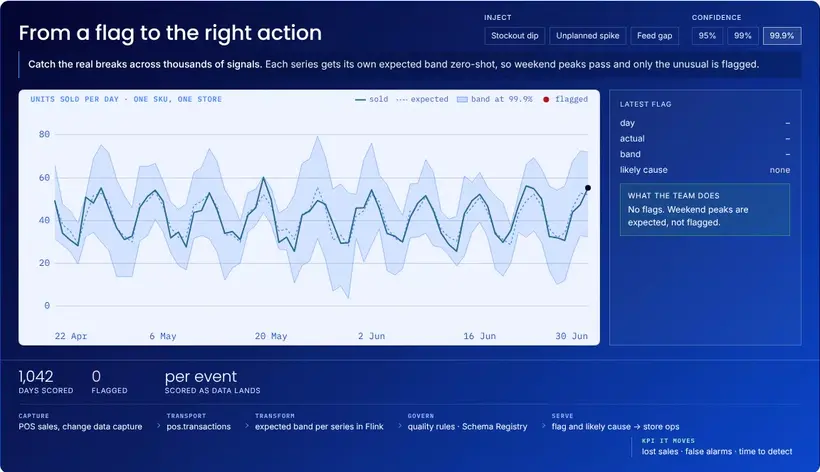
شکل ۶. فروش فروشگاه با یک بازه مورد انتظار مقایسه میشود. در نمای نشاندادهشده، اوجهای تکرارشونده درون بازه میمانند و هیچ ناهنجاری علامت نمیخورد.
کاربرد ۳ | برنامهریزی زنجیره تأمین: هر SKU، هر فروشگاه، هر ساعت
برنامهریز یک دسته محصول و تیم تأمین مجدد باید محصولات را در همه فروشگاهها موجود نگه دارند بدون آنکه موجودی اضافی حمل کنند. اما پیشبینیها ممکن است فقط هفتهای یک بار بهروزرسانی شوند و اغلب روی محصولات پرفروش تمرکز کنند، در حالی که دنباله بلند محصولات با قواعد سادهتری مدیریت میشود. وقتی الگوهای فروش میان دورههای برنامهریزی تغییر میکند، ممکن است یک فروشگاه با کمبود و فروشگاهی دیگر با موجودی اضافه روبهرو شود.
با AI_FORECAST، یک مدل از پیش آموزشدیده میتواند تقاضا را در محصولات و فروشگاهها پیشبینی کند. در این مثال، مدل پیشبینی ۲۸ روزهای با بازه P10–P90 تولید میکند که با رسیدن دادههای تازه فروش بهروزرسانی میشود. برنامه برنامهریزی، پیشبینی را با موجودی، زمان تحویل و سطح خدمتی که برنامهریز انتخاب کرده ترکیب میکند تا نقطه سفارش مجدد را محاسبه کند.
وقتی پیشبینی میشود موجودی به زیر این نقطه برسد، یک عامل میتواند پیشنویس سفارش خرید را برای بازبینی تهیه کند. همین رویکرد میتواند برنامهریزی قطعات یدکی، نیروی انسانی، نقدینگی خودپردازها و تقاضای انرژی را پشتیبانی کند.
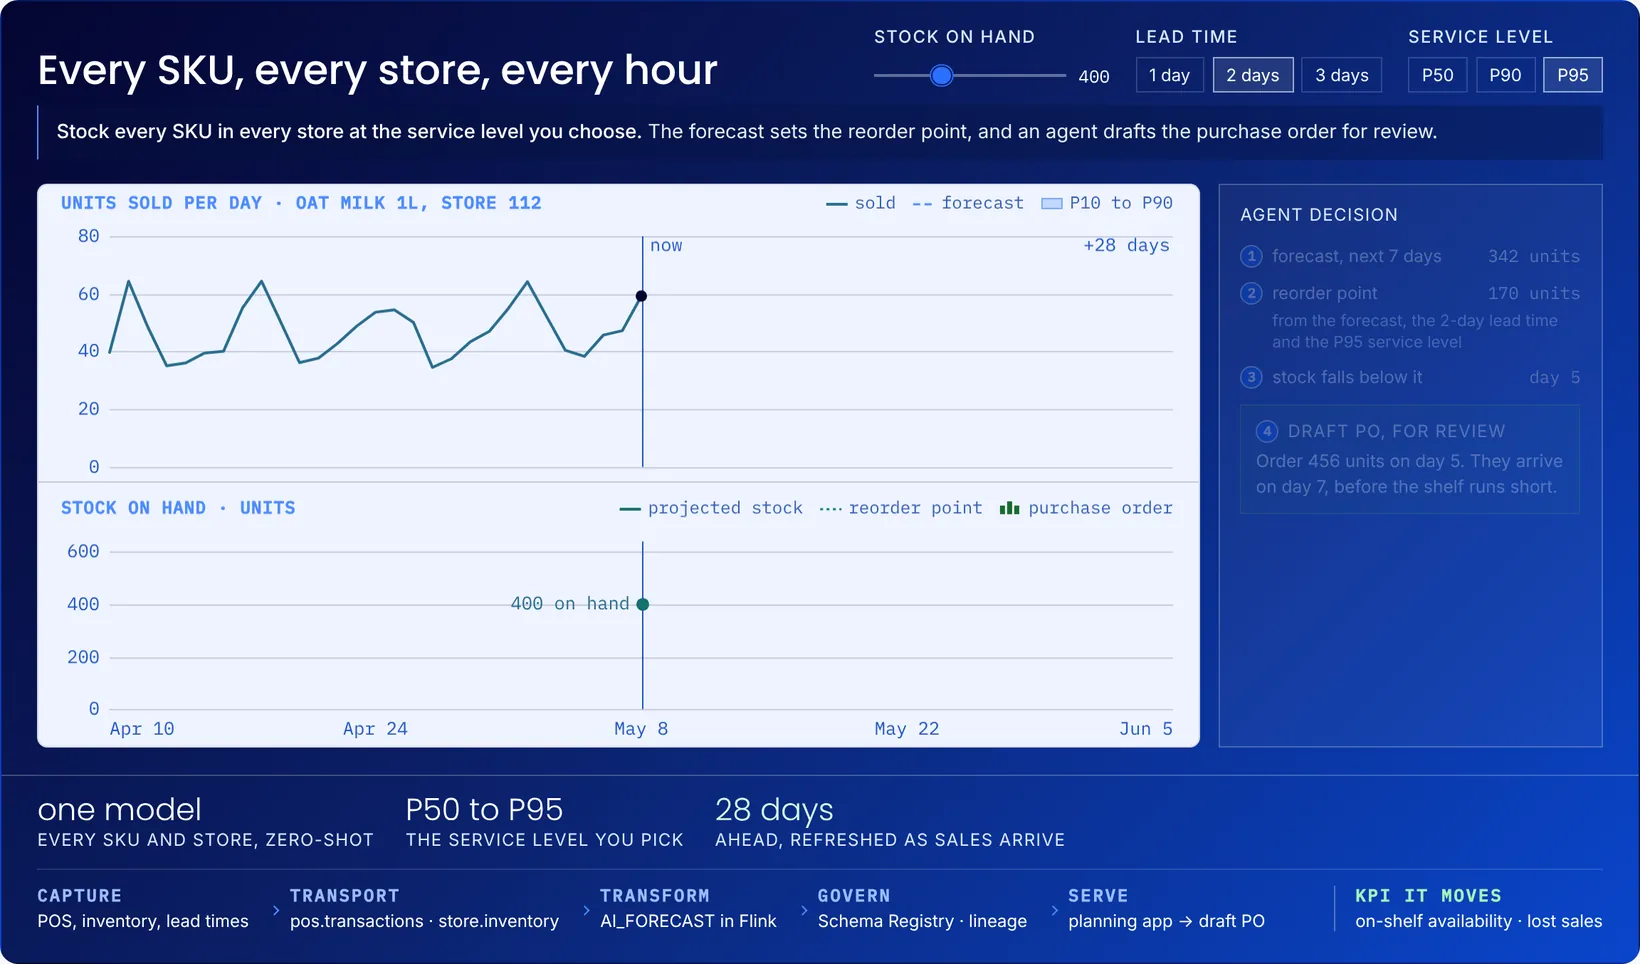
شکل ۷. پیشبینی تقاضا در سطح فروشگاه، نقطه سفارش مجدد و پیشنویس سفارش خرید شیر جو دوسر را تعیین میکند.
کاربرد ۴ | تقلب و امنیت: هر کارت، نرمال خودش را دارد
تیمهای مقابله با تقلب از پیش بر قواعد و مدلهای پیچیده برای ارزیابی تراکنشها تکیه میکنند. یک چالش همیشگی این است که آستانهای که برای همه دارندگان کارت اعمال میشود ممکن است الگوی خرجکردن عادی هر فرد را بازتاب ندهد.
یک نشانه سریزمانی میتواند این زمینه فردی را اضافه کند. در این مثال، هر پرداخت با یک بازه هزینه مورد انتظار بر پایه تاریخچه اخیر کارت مقایسه میشود. تراکنشی که بیرون از این بازه باشد، در کنار سایر نشانهها و قواعد کسبوکار، بهعنوان ورودی اضافی به سامانههای موجود مقابله با تقلب بانک فرستاده میشود.
بانک سپس میتواند تصمیم بگیرد پرداخت را تأیید کند، احراز هویت بیشتری بخواهد یا بررسی بیشتری انجام دهد. تصمیم و نشانههای پشت آن میتوانند برای بازبینی نگه داشته شوند.
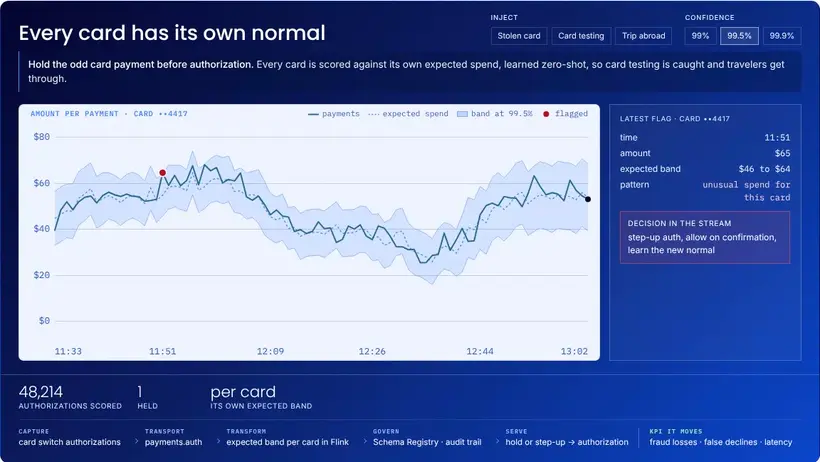
شکل ۸. پرداختی بیرون از بازه هزینه مورد انتظار کارت، در یک گردشکار نمونه مقابله با تقلب، احراز هویت تشدیدشده را طلب میکند.
کاربرد ۵ | معاملات: همگام کردن سفارش با نبض بازار
میز اجرای سفارش باید یک سفارش بزرگ را به معاملات کوچکتر تقسیم کند و در همان حال اثر آن بر بازار را مدیریت کند. منحنیهای حجم تاریخی نقطه شروعی به دست میدهند، اما فعالیت معاملاتی امروز ممکن است بسیار متفاوت از میانگین باشد.
روی هر کندل یکدقیقهای، PatchTST-FM حجم معاملات ۳۰ دقیقه بعد را با بازه P10–P90 پیشبینی میکند. الگوریتم اجرا از این پیشبینی برای همگام کردن سرعت سفارش با حد مشارکتی که میز تعیین کرده استفاده میکند.
اگر رویدادی خبری فعالیت بازار را تغییر دهد، الگوریتم میتواند متوقف شود و دوباره برنامهریزی کند. اگر معاملات آرامتر از انتظار باشد، میتواند اندازه هر برش را کاهش دهد و علامت بدهد که تکمیل سفارش ممکن است بیشتر طول بکشد. هر پیشبینی و تصمیمهای اجرایی حاصل از آن میتوانند در رد حسابرسی نگه داشته شوند.
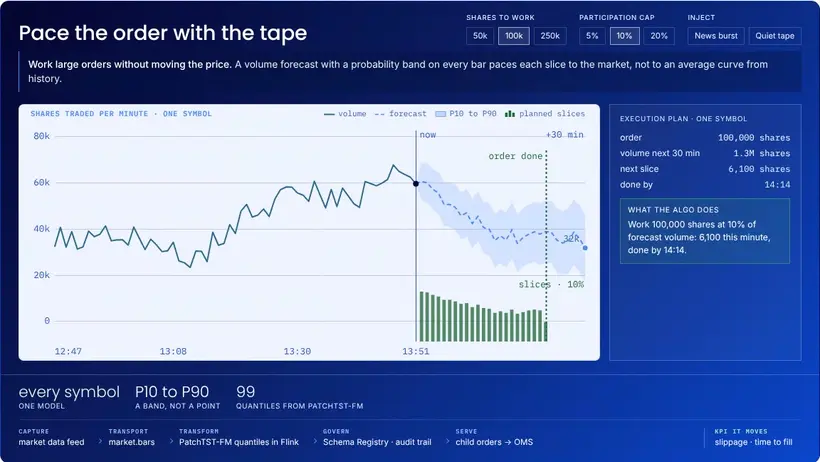
شکل ۹. پیشبینی حجم، برنامه اجرای پیشنهادی برای سفارشی ۱۰۰٬۰۰۰ سهمی را تعیین میکند.
کاربرد ۶ | جستجوی معنایی: هر نشانهای را که شبیه این است پیدا کن
مهندس قابلیت اطمینانی که در حال بررسی یک الگوی غیرعادی حسگر است، ممکن است بخواهد بداند آیا رفتار مشابهی جای دیگری در کارخانه ظاهر شده است یا نه.
TSPulse میتواند نمایشهایی از پنجرههای سریزمانی تولید کند که جستجوی شباهت را پشتیبانی میکنند. در برنامهای که جداگانه ساخته میشود، این نمایشها میتوانند نمایهسازی شوند و برای بازیابی الگوهای تاریخی در تجهیزات به کار روند. مهندس میتواند شکلهایی مانند جهش و بازگشت، افزایش تدریجی یا تغییر پلهای را جستوجو کند و سپس سوابق نگهداری و شرایط عملیاتی مرتبط را بررسی کند.
این برنامه به یک خط لوله تولید بردار، یک نمایه و دسترسی به زمینه مرتبط نیاز دارد. شباهت میتواند دامنه بررسی را محدودتر کند؛ اما بهخودیخود علت ریشهای را اثبات نمیکند.
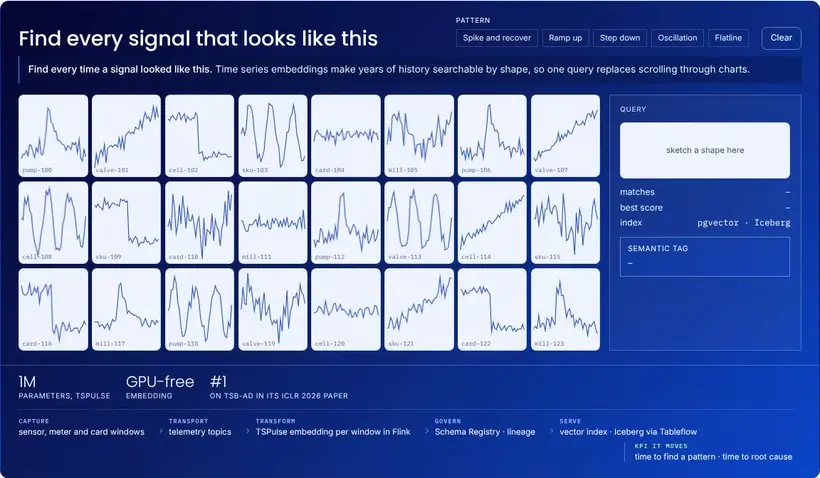
شکل ۱۰. نمایشهای برداری سریزمانی میتوانند جستوجوی الگوهای مشابه را در تجهیزات و سایر نشانهها پشتیبانی کنند.
کاربردهای صنعتمحور
همین مدلها و بلوکهای سازنده میتوانند گردشکارهای مختلف را در صنایع گوناگون پشتیبانی کنند:
هوش مصنوعی صنعتی: از حسگر تا نقطه تنظیم. مدیر کارخانه میخواهد هر دسته در محدوده مشخصات باشد و هیچ خطی بهخاطر یک غافلگیری متوقف نشود. جریانهای SCADA، آزمایشگاه QA و کنتور انرژی همانطور که میرسند پیشبینی میشوند. بهینهسازی تولید وقتی کیفیت شروع به انحراف میکند نقاط تنظیم را جابهجا میکند، تشخیص ناهنجاری قرائتی را که هیچ قاعدهای برایش نوشته نشده علامت میزند و جستجوی معنایی هر پمپی را پیدا میکند که پیش از خرابی همین الگو را نشان داده است. نقاط تنظیم، دستورهای کار و هشدارها در همان چرخه به کف کارخانه میرسند، نه در گزارش نوبت بعد.
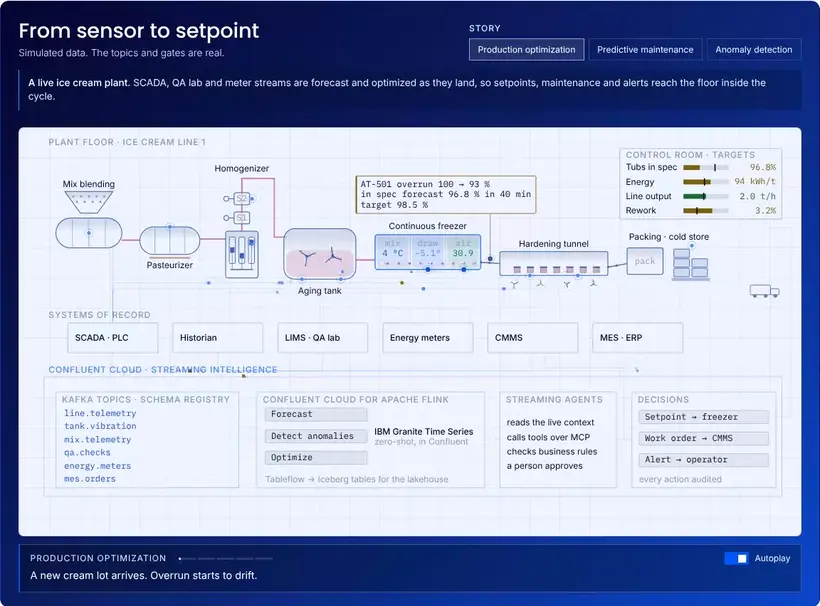
شکل ۱۱. دوقلوی دیجیتال کارخانه، از حسگر تا نقطه تنظیم. یک محموله خامه تازه هوادهی را از هدف دور میکند. پیشبینی خط را میخواند، عامل دمای کشش و جریان هوای تازه را پیشنهاد میدهد، اپراتور تأیید میکند و وانها به محدوده مشخصات بازمیگردند. داده شبیهسازیشده.
خردهفروشی: یک فروشگاه و زنجیره تأمینش. مدیر فروشگاه میخواهد شنبه قفسه پر باشد و دوشنبه موجودی اضافه نداشته باشد. جریانهای فروش، آبوهوا و تبلیغات برای هر محصول در هر فروشگاه پیشبینی میشوند. برنامهریزی زنجیره تأمین سفارش را تعیین میکند، تشخیص ناهنجاری قفسه خالی یا تحویل ازدسترفته را میگیرد و بخش تقلب و امنیت کارت مشکوک را نگه میدارد. سفارشها، وظایف فروشگاه و توقفها پیش از خالی شدن قفسه ارسال میشوند.
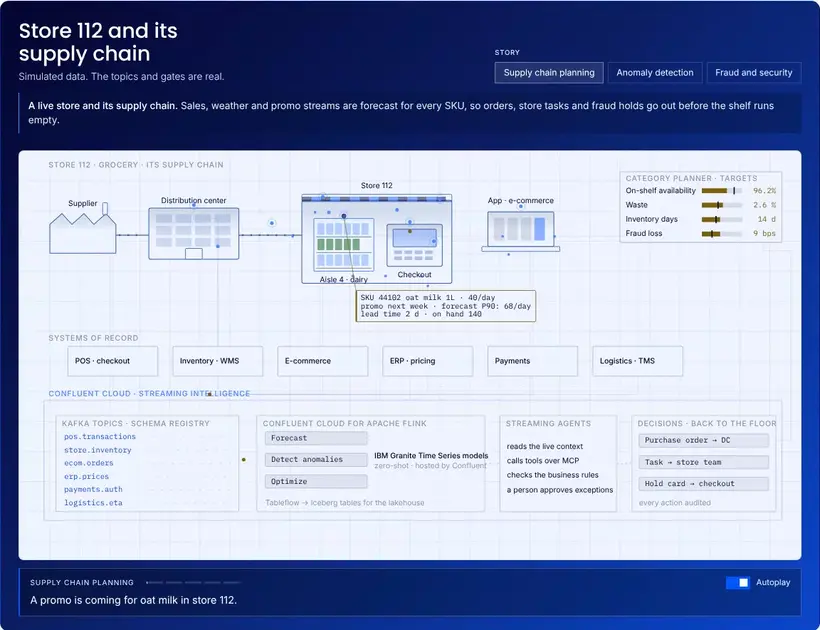
شکل ۱۲. دوقلوی دیجیتال فروشگاه، یک فروشگاه و زنجیره تأمینش. تبلیغی برای شیر جو دوسر در راه است. پیشبینی تبلیغ را در محاسبات لحاظ میکند و نقطه سفارش مجدد را تعیین میکند، عامل سفارش خرید صادر میکند، برنامهریز تأیید میکند و قفسه در روز تبلیغ پر است. داده شبیهسازیشده.
بانکداری: پرداختها و میز معاملات. مسئول مقابله با تقلب میخواهد آزمون کارت را متوقف کند بدون آنکه مشتریان خوب را مسدود کند، و معاملهگر میخواهد سفارش بزرگی را بدون جابهجا کردن قیمت انجام دهد. هر کارت و هر نماد در برابر الگوی مورد انتظار خودش، رویداد به رویداد، امتیازدهی میشود. بخش تقلب و امنیت کشیدن غیرعادی کارت را پیش از تأیید نگه میدارد، تشخیص ناهنجاری جریان غیرعادی را میبیند و بخش معاملات هر سفارش را با حجم پیشبینیشده همگام میکند.
خطوط هوایی: عملیات قطب پروازی، ناوگان و شبکه. کنترل عملیات میخواهد اختلالی را ببیند که هنوز زمان اقدام وجود دارد. جریانهای موتور، گیت و شبکه بهصورت بلادرنگ پیشبینی و بررسی میشوند. تشخیص ناهنجاری قرائت موتوری را که منحرف میشود میگیرد، بهینهسازی تولید گیتها و خدمه را دوباره متوازن میکند و برنامهریزی زنجیره تأمین قطعه یدکی را جایی میگذارد که هواپیما خواهد بود.
در هر صنعتی، Streamhouse همین کار را انجام میدهد: Flink مدلهای Granite را برای پیشبینی، تشخیص و بهینهسازی اجرا میکند، Streaming Agents بر پایه زمینه زنده عمل میکنند و افراد موارد استثنا را تأیید میکنند.
مدلها را روی Confluent کاوش کنید تا ببینید هوش سریزمانی چگونه میتواند تصمیمگیری بلادرنگ را پشتیبانی کند.
بیشتر بدانید
کد و نوتبوکها: github.com/ibm-granite/granite-tsfm
هوش بلادرنگ با مدلهای سریزمانی IBM روی Confluent
پیشبینی گروهی با مدلهای سریزمانی IBM Granite
IBM مدل SOTA Granite Time Series PatchTST-FM-r2 را با مجوز مناسب استفاده تجاری منتشر کرد
تازههای Confluent Intelligence و ابزارهای هوش مصنوعی: عاملهای بومی جریان، پشتیبانی گستردهتر از مدلها، مهارتهای تازه عامل و دستیار Confluent
تازههای سهماهه چهارم ۲۰۲۶ در پلتفرم جریان داده Confluent
تازههای Confluent Platform for Apache Flink، نوامبر ۲۰۲۶
 نگار رضایی
 آرمان کریمی