آرمان کریمی
در اکتبر، بیش از یک در چهار درخواست در روتر مدل هوش مصنوعی Vercel به مدلهای تصمیمگیری رفت، نه به مدلهای زبانی بزرگ؛ سهمی بسیار بزرگ از کار برای نوعی هوش کامپیوتری که فقط یک ماه پیش از آن اختراع شده بود.
مدلهای تصمیمگیری مدلهای زبانی بزرگی هستند که توکن خروجی تولید نمیکنند؛ در عوض طوری تنظیم شدهاند که با استفاده از هوش عمومی خود، سریع و ارزان بین گزینههای از پیش تعیینشده انتخاب کنند و سطح اطمینان خود در این انتخاب را هم ثبت کنند. این مدلها در محیطهای عملیاتی کاربرد دارند، جایی که تصمیم سریع میتواند مهمتر از استدلالی باشد که یک مدل پیشروِ کندتر و گرانتر ارائه میدهد.
TypeSafe پس از عرضهٔ خانوادهٔ مدلهای Jev به شرکتی ۷.۵ میلیارد دلاری تبدیل شد؛ خانوادهای که همچنان بیشترین استفاده را دارد (دستکم در جاهایی که معیارهایی از سرویسهایی مانند OpenRouter در دسترس است؛ OpenRouter هفتهٔ گذشته بیش از ۱.۵ میلیارد پرسوجو به مدلهای TypeSafe را پردازش کرد).
با این حال، ساختن مدل تصمیمگیری آسان است و پس از Jev دهها مدل عرضه شد. یکی از مهندسان Amazon در یک آخر هفته یکی از این مدلها را ساخت و خیلی زود هر ابرشرکتی گزینهٔ خودش را داشت. روز سهشنبه، ساتیا نادلا (Satya Nadella)، مدیرعامل مایکروسافت، گفت شرکتش مدل تصمیمگیری خود با نام Microsoft-Decision-1.1 را از همان لحظه برای استفادهٔ گسترده روی Azure عرضه میکند.
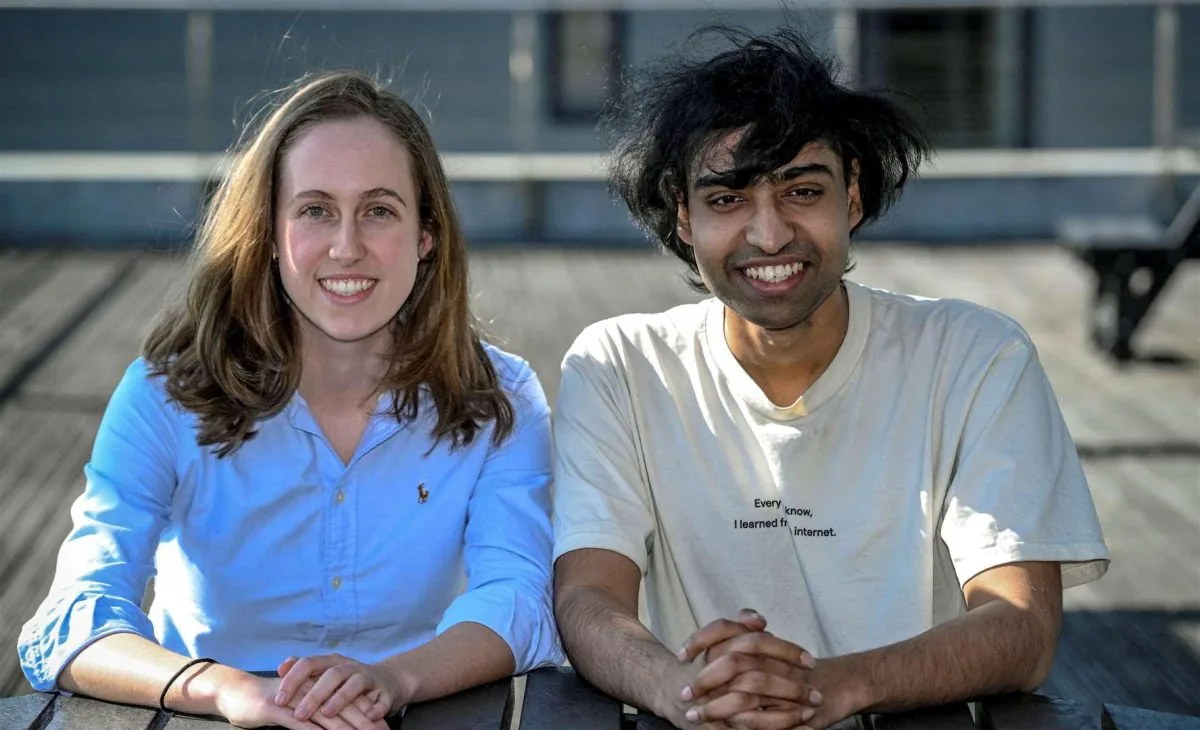
تحرک اصلی در دو سر این اکوسیستم دیده میشود: Sqwish، استارتاپ هوش مصنوعی مستقر در بریتانیا که مدل تصمیمگیری kettei fat را ساخته، امروز از جذب ۳ میلیون دلار در دور سرمایهگذاری پیشبذری خبر داد. اوشنیش سنگوپتا (Ushnish Sengupta) و فدریکا فردی (Federica Freddi)، همبنیانگذاران Sqwish که در دوران دانشجویی در کمبریج با هم آشنا شده بودند، پیش از ظهور Jev مشغول توسعهٔ مدلهای زبانی بزرگ کوچک بودند و متوجه شدند معماریهایشان را میتوان برای ساختن یک مدل تصمیمگیری قدرتمند به کار گرفت.
به نظر میرسد داده، کلید موفقیت در این دسته است؛ دیوگو آلمدیا (Diogo Almedia)، مدیرعامل TypeSafe، به TechCrunch گفت سختترین بخش ساخت Jev، کالیبرهکردن دقیق قضاوت آن با دادهٔ مصنوعیِ تنظیمشده بهلحاظ آماری بود. Sqwish هم با دادهٔ مصنوعی کار کرده است، اما پیشنهاد متمایز آن ابزارهای پسآموزش داخلی است که از دادهٔ خود مشتری برای بهبود قضاوت مدل استفاده میکنند.
اوشنیش سنگوپتا، مدیرعامل Sqwish، به TechCrunch گفت: «به نظر من چیزی که ما را کالایی عمومی نمیکند این است که همان توان را به مشتریانمان میدهیم… آنها میتوانند دادهٔ عملیاتی خود را مدام بارگذاری کنند و درست همانطور که ما مدلهایمان را آموزش دادیم، مدلهای آنها هم میتوانند در وظایفی که برایشان مهم است مدام بهتر شوند.»
رتبهبندی مدلهای تصمیمگیری دشوار است؛ مدل kettei fat از Sqwish در برخی معیارهای سنجش عملکرد خوبی داشته، اما بیشتر سازندگان این فناوری میگویند آزمون واقعی، عمل است: معمولاً برای توسعهدهندگان ساده است که یک مدل را جای مدل دیگری بگذارند و ببینند در یک بافت مشخص چگونه عمل میکند.
سنگوپتا میگوید: «معیار سنجش بیشتر دعوتی است برای امتحانکردن مدل، و بعد از آن، تنظیم مستمر دلیل ماندن آنها با ماست.»
مدل Microsoft-Decision-1.1 هم حاصل موازنهٔ دقیق شرکت میان هزینه، تأخیر، هوشمندی و کالیبراسیون است. آچینت سریواستاوا (Achint Srivastava)، معاون مهندسی که رهبری این پروژه را بر عهده داشت، هم موافق است که تمرکز بیش از حد بر معیارهای سنجش اشتباه است.
سریواستاوا در ایمیلی نوشت: «آنچه میبینیم این است که مدلهای بهینهشده صرفاً برای معیارها، خیلی زود در استفادهٔ واقعی سازمانی از کار میافتند. آزمونهای ما نشان میدهد ارائهٔ دقت، قابلیت اتکا، سرعت و بهرهوری هزینه در یک مدل واحد چقدر دشوار است. Microsoft-Decision-1.1 و Jev از معدود مدلهایی هستند که در هر چهار بُعد عملکرد قوی دارند، حتی وقتی با معیارهای نگهداشتهشده (دادهٔ آزمون دیدهنشده) یا معیارهایی که موارد واقعی استفاده را بازتاب میدهند ارزیابی شوند.»
برای استارتاپهایی مانند Sqwish، رقابت با ابرشرکتها و آزمایشگاههای پیشرو یک فرصت است. فردی پیشبینی میکند سیستمهای آینده شاهد همکاری هوش سیستم یک (System One)، مانند مدلهای تصمیمگیری، با هوش سیستم دو (System Two)، مانند مدلهای زبانی بزرگ پیشرو، خواهند بود.
فردی به TechCrunch گفت: «حتی در آن آینده، سیستم یک شاید فرصتی ۱۰ تا ۵۰ میلیارد دلاری باشد، در حالی که OpenAI این عرضهٔ عمومی اولیه را با ارزش بازار ۱ تا ۲ تریلیون دلاری در ذهن انجام میدهد. تمام دغدغهٔ ما همین است؛ در حالی که برای آنها این فقط یک پروژهٔ جانبی است.»
 سارا نادری
 نگار رضایی