TorchNeuron بکاند بومی جدیدی برای PyTorch روی AWS Trainium فراهم میکند. Transformers، Diffusers و Kernels بهصورت بومی از آن پشتیبانی میکنند و همین اجرای مدلها روی Trainium و اشتراکگذاری آنها در Hub را سادهتر از همیشه کرده است.
TorchNeuron
TorchNeuron یک پلاگین PyTorch است که بکاند جدیدی برای Trainium ارائه میدهد و از حالت eager، torch.compile و APIهای توزیعشدهٔ بومی مانند FSDP و TP پشتیبانی میکند. برای آشنایی بیشتر با TorchNeuron، بلاگ PyTorch را بخوانید.
TorchNeuron از ۲۰ اکتبر ۲۰۲۶ بهصورت بتای عمومی در دسترس خواهد بود. پژوهشگران و توسعهدهندگان میتوانند آن را با دستور pip install torch-neuronx نصب کنند.
بکاند جدید، رابط بومی در کتابخانههای Hugging Face
تا امروز، تجربهٔ استفاده از Hugging Face روی AWS Trainium و Inferentia — تراشههای هوش مصنوعی که بهترتیب برای آموزش مقرونبهصرفه و استنتاج در مقیاس طراحی شدهاند — از طریق optimum-neuron ارائه میشد. این کتابخانه به بستهٔ torch-neuronx وابسته است که خود بر PyTorch XLA بنا شده است. در آن زمان انتخاب طبیعی بود، اما به این معنا بود که باید مثل یک کامپایلر فکر کنید: تانسورهای تنبل بهجای اجرای eager، فقط شکلهای ایستا، و بازکامپایل بهازای هر شکست گراف. Optimum Neuron برای پنهانکردن همین پیچیدگی وجود داشت و برای این کار کد سفارشی (کلاسهای مدلسازی، آموزشدهندهها و غیره) را نگهداری میکرد.
TorchNeuron این وضعیت را تغییر میدهد. این پلاگین مستقیماً در PyTorch ادغام میشود و neuron را بهعنوان یک دستگاه بومی در دسترس قرار میدهد، همراه با اجرای eager، ابتداییهای توزیعشدهٔ خود PyTorch (DTensor، FSDP2) و torch.compile.
برای کتابخانههای Hugging Face، Trainium به دستگاهی مثل هر دستگاه دیگری تبدیل میشود: Transformers، Diffusers، Accelerate، PEFT و TRL مستقیماً روی آن اجرا میشوند، با همان کلاسها و اسکریپتهایی که روی هر شتابدهندهٔ دیگری به کار میبرید. از این پس توصیه میکنیم کاربران Neuron بهجای عبور از Optimum Neuron، مستقیماً از همین کتابخانهها استفاده کنند.
Transformers
استنتاج
تولید متن اکنون در Transformers بهصورت بومی برای طیف گستردهای از مدلها پشتیبانی میشود. با TorchNeuron، ۸۹٪ از ۱۰۰ معماری پرکاربرد تولید متن بهصورت خارج از جعبه پشتیبانی میشوند، در حالی که این رقم با Optimum Neuron v0.4.5 برابر ۴۶٪ است. کافی است آرگومان device_map=neuron را در کد خود بدهید تا مدلتان به دستگاههای Neuron منتقل شود.
نمونهٔ زیر تولید متن با موازیسازی تانسوری (TP) را نشان میدهد که به شما امکان میدهد از نمونهٔ Neuron خود بهطور کامل بهره ببرید. توجه کنید که در این نمونه برای تولید از کش ایستا استفاده شده است، چون در Neuron قویاً توصیه میشود تا از بازکامپایلهای مکرر جلوگیری شود.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
آموزش
حالا که Neuron یک دستگاه بومی PyTorch است، آموزش روی Trainium از همان کتابخانههای Hugging Face استفاده میکند که روی هر شتابدهندهٔ دیگری به کار میرود: Transformers، Accelerate، PEFT و TRL. دیگر نیازی به آموزشدهندهٔ اختصاصی یا نسخهٔ فورکشدهٔ مخصوص Neuron از کد مدل ندارید. یک اسکریپت استاندارد تنظیم دقیق TRL با تنها چند تنظیم مخصوص Neuron روی یک نمونهٔ Trainium اجرا میشود.
در ادامه یک اسکریپت تنظیم دقیق نظارتشده بر پایهٔ SFTTrainer از TRL آمده است. اگر پیشتر مدلی را با TRL روی GPU تنظیم دقیق کرده باشید، این اسکریپت برایتان آشنا خواهد بود.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
main(script_args, training_args, model_args)موازیسازی بهصورت بومی توسط Transformers مدیریت میشود. یک DistributedConfig با اندازههای موازیسازی تانسوری (TP) و FSDP در model_init_kwargs قرار میدهید، SFTTrainer آن را به from_pretrained میدهد و مدل هنگام بارگذاری وزنها تکهتکه میشود. Trainer تشخیص میدهد که مدل از قبل توزیعشده است و دوباره آن را نمیپیچد. به پرچم --fsdp یا پیکربندی FSDP در Accelerate نیازی ندارید.
هیچ بخشی از اسکریپت به Trainium گره نخورده است: همان کد روی هر سختافزاری اجرا میشود. هنگام اجرا روی Trainium چند نکته را باید بدانید:
شکلهای ایستا. اسکریپت شکلهای پویای خودکار را در torch.compile غیرفعال میکند و با بستهبندی پیچیده (wrapped) توالیهایی تا ۲۰۴۸ توکن تولید میکند. با TRL نسخهٔ ۱.۱۶ و بالاتر، دستهها روی Neuron تا مضربی از ۱۲۸ توکن پد میشوند و همین تعداد شکلهای ورودی را محدود میکند. گرافهای کامپایلشده برای گامهای بعدی با همان شکلها دوباره استفاده میشوند.
torch.compile روشن. کافی است --torch_compile true را بدهید: روی یک نمونهٔ Trainium، torch.compile دستگاه را تشخیص میدهد و بهطور خودکار بکاند Neuron را انتخاب میکند، بدون نیاز به تنظیم دیگری.
بارگذاری ناهمگام وزنها خاموش. بارگذاری ناهمگام وزنها که در Transformers تعبیه شده است روی Neuron پشتیبانی نمیشود، بنابراین فعلاً آن را با HF_DEACTIVATE_ASYNC_LOAD=1 غیرفعال میکنیم.
دستور زیر آموزش را با torchrun آغاز میکند که برای هر NeuronCore یک فرایند راه میاندازد. TP_SIZE و FSDP_SIZE چیدمان موازیسازی را تعیین میکنند و حاصلضرب آنها تعداد فرایندهاست: در اینجا ۴ × ۸ = ۳۲ که با --nproc_per_node مطابقت دارد. این ۳۲ فرایند یک شبکهٔ ۴ × ۸ میسازند. موازیسازی تانسوری هر لایه را میان ۴ هستهٔ یک گروه TP تقسیم میکند و FSDP پارامترها، گرادیانها و وضعیت بهینهساز را میان ۸ گروه TP تکهتکه میکند.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
ما آن را روی ۸ تراشهٔ Trainium2 (۳۲ NeuronCore) اجرا کردیم که نیمی از یک نمونهٔ trn2.48xlarge است.
آموزش تا پایان اجرا میشود و trainer.save_model یک چکپوینت استاندارد Transformers مینویسد. هیچ بخشی از آن به Neuron گره نخورده است: میتوانید آن را همانطور که هست به Hugging Face Hub بفرستید و روی هر سختافزار دیگری بارگذاری کنید.
Diffusers
استنتاج
بسیاری از خط لولههای کتابخانهٔ Diffusers با TorchNeuron در حالت eager و حالت کامپایلشده سازگارند. مدلهای FLUX.1-dev، FLUX.2، Qwen-Image، Qwen-Image-2.1 و H3 نیز با موازیسازی تانسوری سازگارند تا از دستگاههای Neuron خود بیشترین بهره را ببرید. نمونهٔ زیر نشان میدهد چگونه میتوانید از TP استفاده کنید:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
image.save("out.png")میتوانید این قطعه کد را با دستور NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py اجرا کنید.
خط لولههای بیشتری با TP سازگار خواهند شد. اگر خط لولهٔ موردعلاقهٔ شما سازگار نیست، میتوانید با دنبالکردن این راهنما پشتیبانی از آن را اضافه کنید.
Kernels
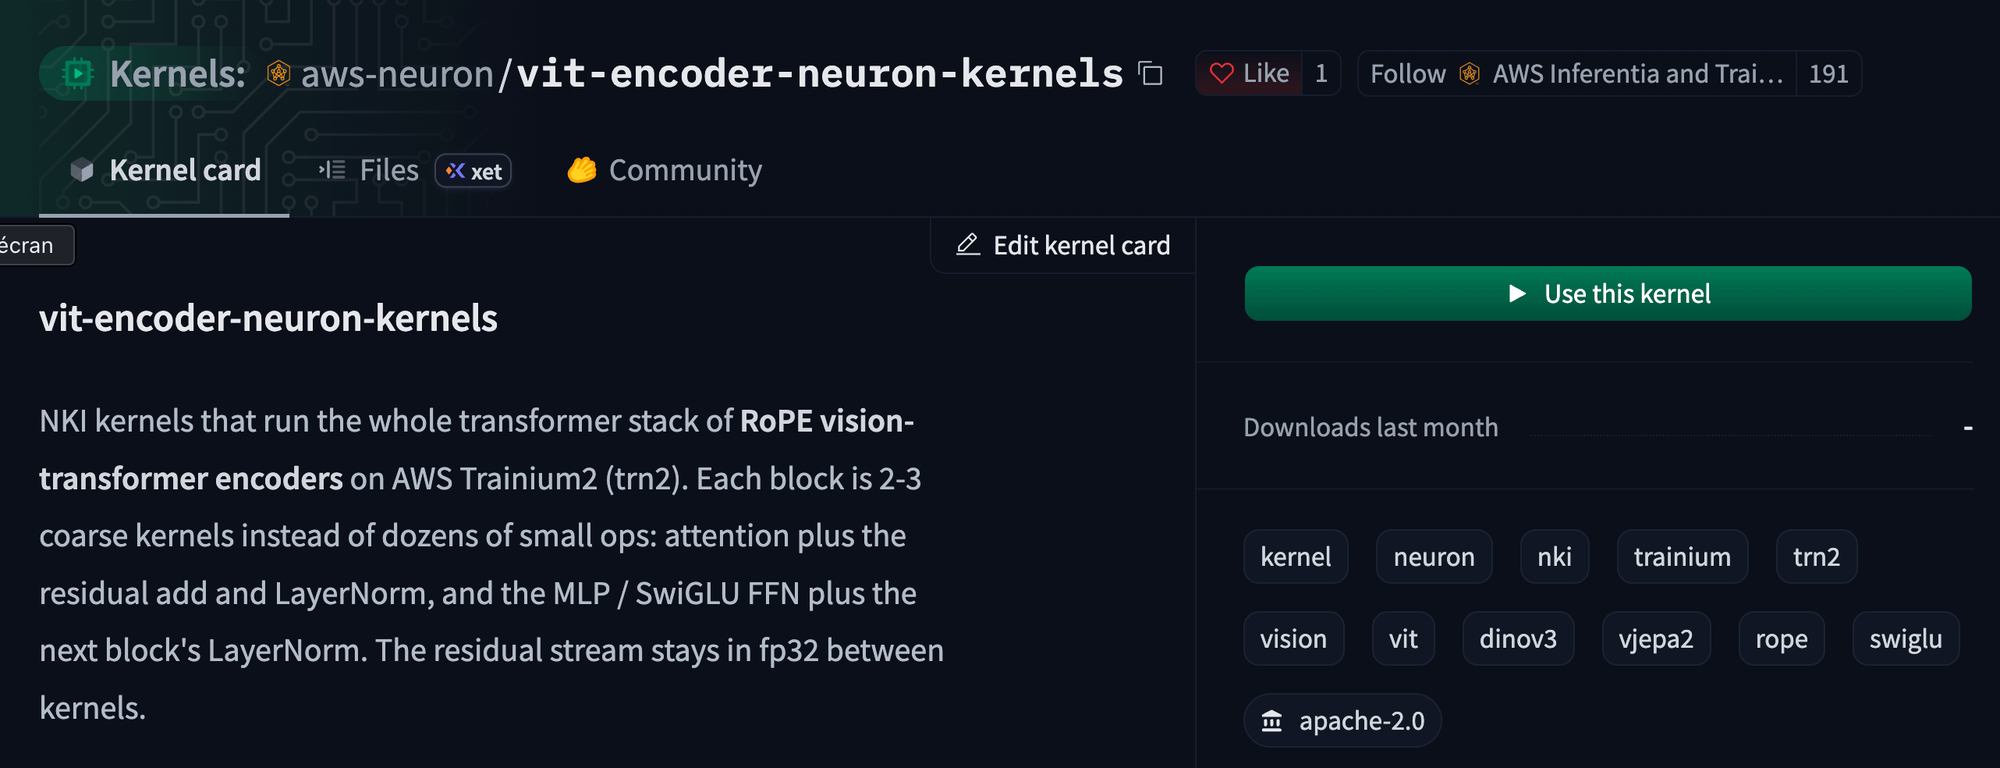
حتماً کرنلهای تیم Neuron را ببینید، چون کرنلهای Neuron بیشتری روی Hub در دسترس قرار میگیرند تا مدلهایتان را سریعتر کنند. کرنلهای Neuron را میتوان با Neuron Kernel Interface (NKI) نوشت که کنترل بیشتری برای بهینهسازی عملیات میدهد. به این ترتیب، کاربران میتوانند عملیات سفارشی خود را اجرا کنند و آنها را در Hub به اشتراک بگذارند.
برای نمونه میتوانید از این کرنل برای سرعتدادن به ترانسفورمرهای بینایی خود با سرعتی تا ۲.۴ برابر روی Trainium استفاده کنید!
 برای مشاهدهٔ جزئیات، تصویر را باز کنید
قدردانی
تشکر ویژه از تیم AWS برای کارشان روی TorchNeuron و برای واکنش سریعشان به بازخوردهای ما، تا ادغام با Hugging Face تا حد امکان بهتر شود.