Mistral Large 4 (با نام مستعار Le Chonk) مدلی چندوجهی، چندزبانه و مبتنی بر معماری ترکیب خبرگان (Mixture-of-Experts یا MoE) از Mistral است. این مدل متن و تصویر را بهعنوان ورودی میگیرد و متن تولید میکند. حدود ۱ تریلیون پارامتر کل و ۴۹ میلیارد پارامتر فعال دارد و پنجرهٔ زمینهٔ آن ۱ میلیون توکن است.
این مدل در دو گونهٔ رسمی منتشر شده است:
FP8
NVFP4
همچنین نسخههای GGUF ساختهشده توسط Unsloth و تیم llama.cpp هم وجود دارد. این مدل تحت مجوز Mistral Ecosystem Open-Weight License توزیع میشود؛ مجوزی مشتق از MIT که محدودیتهایی برای ارائهٔ مدل بهصورت سرویس (model-as-a-service) تعیین میکند.
Mistral Large 4 بهویژه در امنیت سایبری، عاملهای کدنویسی و چندوجهیبودن عملکرد قوی دارد. در این پست بررسی میکنیم که این مدل چگونه کار میکند، چه قابلیتهایی دارد، معماریاش چیست و موارد دیگر!
فهرست مطالب
«خوش آمدید Le Chonk: Mistral Large 4 در Hugging Face» فهرست مطالب Mistral Large 4 چه چیز تازهای دارد قابلیتهای امنیت سایبری معماری رمزگذار بینایی نتایج بنچمارک پشتیبانی از استنتاج Transformers vLLM Llama.cpp تنظیم دقیق با TRL Inference Endpoints Dell Enterprise Hub آن را امتحان کنید
Mistral Large 4 چه چیز تازهای دارد
Mistral Large 4 مجموعهٔ بزرگی از خبرگان را با توجه پراکنده و رمزگذار بینایی Pixtral ترکیب میکند. مدل زبانی برای هر توکن گروه کوچکی از خبرگان را انتخاب میکند و شاخص توجه آن تعیین میکند که به کدام موقعیتهای پیشین توکن توجه شود. اینها دو شکل متفاوت از پراکندگیاند: یکی شبکههای پیشخور را انتخاب میکند و دیگری موقعیتهای زمینه را.
همهٔ چکپوینتها را میتوانید در مجموعهٔ Mistral Large 4 پیدا کنید.
قابلیتهای امنیت سایبری
Mistral Large 4 در آزمون Artificial Analysis Cyber Index امتیاز ۸۲٪ کسب میکند؛ آزمونی که از مدل میخواهد یک آسیبپذیری واقعی در نرمافزار متنباز را بازتولید کند و سپس نرمافزار را وصله بزند. Mistral گزارش میدهد که چند مدل بستهٔ پیشرو در همین آزمون امتیازی نزدیک به صفر گرفتهاند، چون از تلاش برای انجام کار سر باز میزنند. این موضوع برای مدافعان بسیار مهم است، چون رفع یک آسیبپذیری معمولاً مستلزم بازتولید آن است. در تستهای داخلی Mistral، Mistral Large 4 در تحلیل بدافزار، اولویتبندی آسیبپذیریها و نوشتن قواعد تشخیص هم مفید بوده است؛ کارهایی که مدل بهطور صریح برایشان آموزش ندیده بود.
Mistral عمدتاً این مدل را برای کارهای دفاعی امنیتی جایگاهیابی میکند. پژوهش آسیبپذیری و واکنش به حادثه اغلب در ورودی مدل شبیه حمله به نظر میرسند، بنابراین فیلترهای مدلهای بسته میتوانند آنها را مسدود کنند. تیمی که به یک API وابسته است هم ممکن است در میانهٔ یک حادثه دسترسیاش را از دست بدهد. نکتهٔ مهم این است که مدلهای با وزن باز، هم سیاست استفاده و هم استقرار را در اختیار کاربر میگذارند. با این حال، مدل همچنان درخواستهای مضر را رد میکند: در پرامپتهای سایبری از JailbreakBench، StrongREJECT و AgentHarm، میانگین نرخ رد آن از هر مدل دیگر با وزن باز بالاتر است.
برای سازندگان جامعهٔ کاربری، مدلی با وزن باز مانند Mistral Large 4 طیف گستردهای از کاربردهای پاییندستی را ممکن میکند. میتوانید سیستم سایبری خودتان را حول پایگاه کد، لاگهای خرابی و نمونههای بدافزار خودتان بسازید. برای نمونه، با TRL میتوانید مدلهای کوچکتر را بر اساس ردپاهای Mistral Large 4 در وصلهزدن پایگاه کدتان تنظیم دقیق کنید. در واقع، وظایف «بازتولید و سپس وصلهزدن» از پاداش قابلراستیآزمایی استفاده میکنند، بنابراین با محیطهای یادگیری تقویتی سازگارند و میتوان از آنها برای یادگیری تقویتی بیشتر روی مدلهای امنیتی کوچکتر بهره گرفت. وزنهای باز همچنین به پژوهشگران اجازه میدهد رفتار رد درخواست مدل را مستقیماً اندازه بگیرند، نه اینکه به توصیف ارائهدهنده تکیه کنند.
خلاصه اینکه، در دسترس بودن قابلیتهای سایبری در سطح ML4 برای جامعهٔ کاربری یک تقویت بزرگ است.
با Pierre Stock دربارهٔ قابلیتهای سایبری این مدل مصاحبه کردهایم؛ میتوانید آن را اینجا تماشا کنید.
معماری
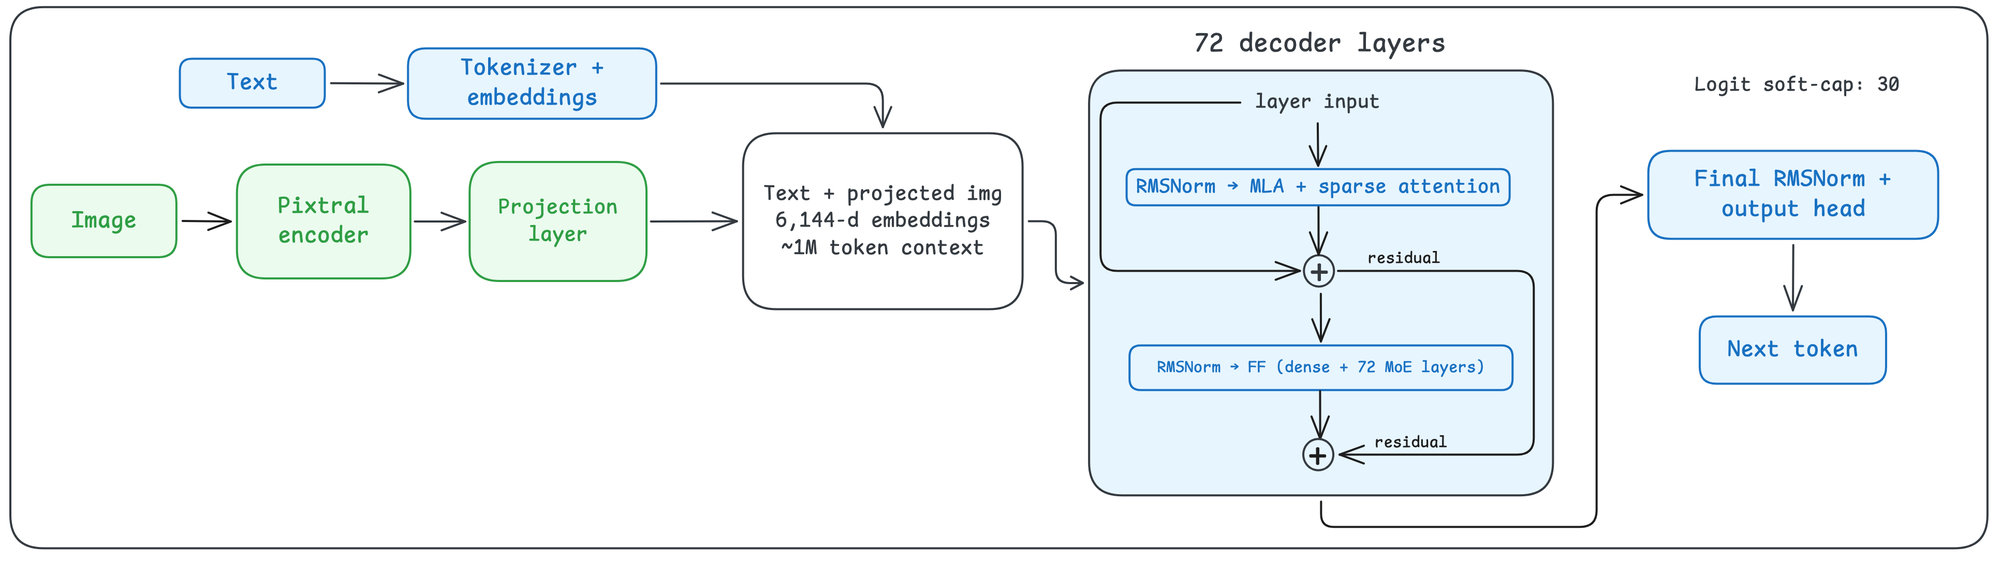
رمزگشای متنی Mistral Large 4 دارای ۷۲ لایه، بُعد پنهان ۶٬۱۴۴ و ۶۴ سر توجه است. بلوکهای توجه آن، Multi-head Latent Attention (MLA) را با شاخص DeepSeek Sparse Attention (DSA) ترکیب میکنند (جهتی که در مدلهای دیگری مانند GLM 5.3 هم دیده میشود). MLA یک نمایش فشردهٔ کلید-مقدار نگه میدارد و DSA برای هر پرسوجو حداکثر ۲٬۰۴۸ موقعیت کلید را انتخاب میکند.
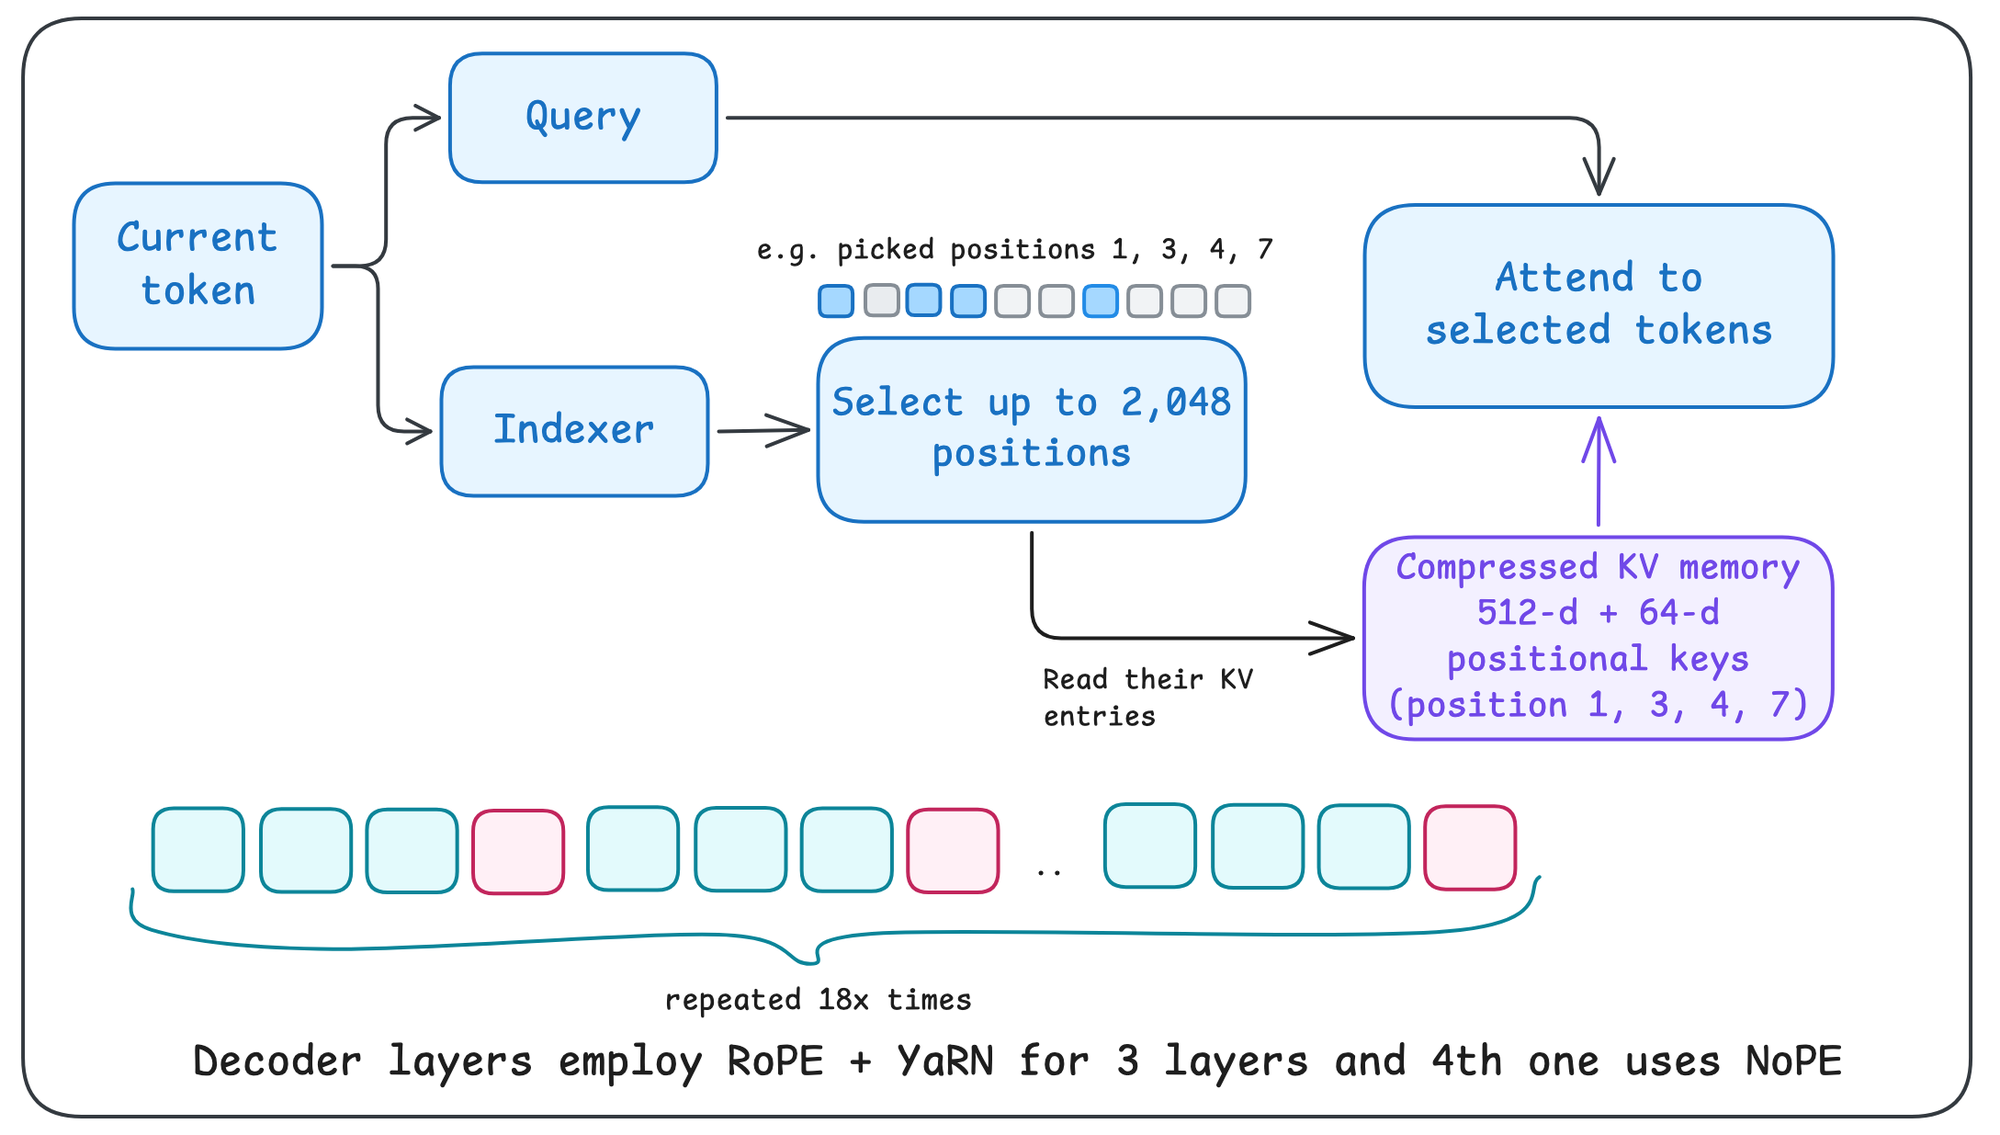
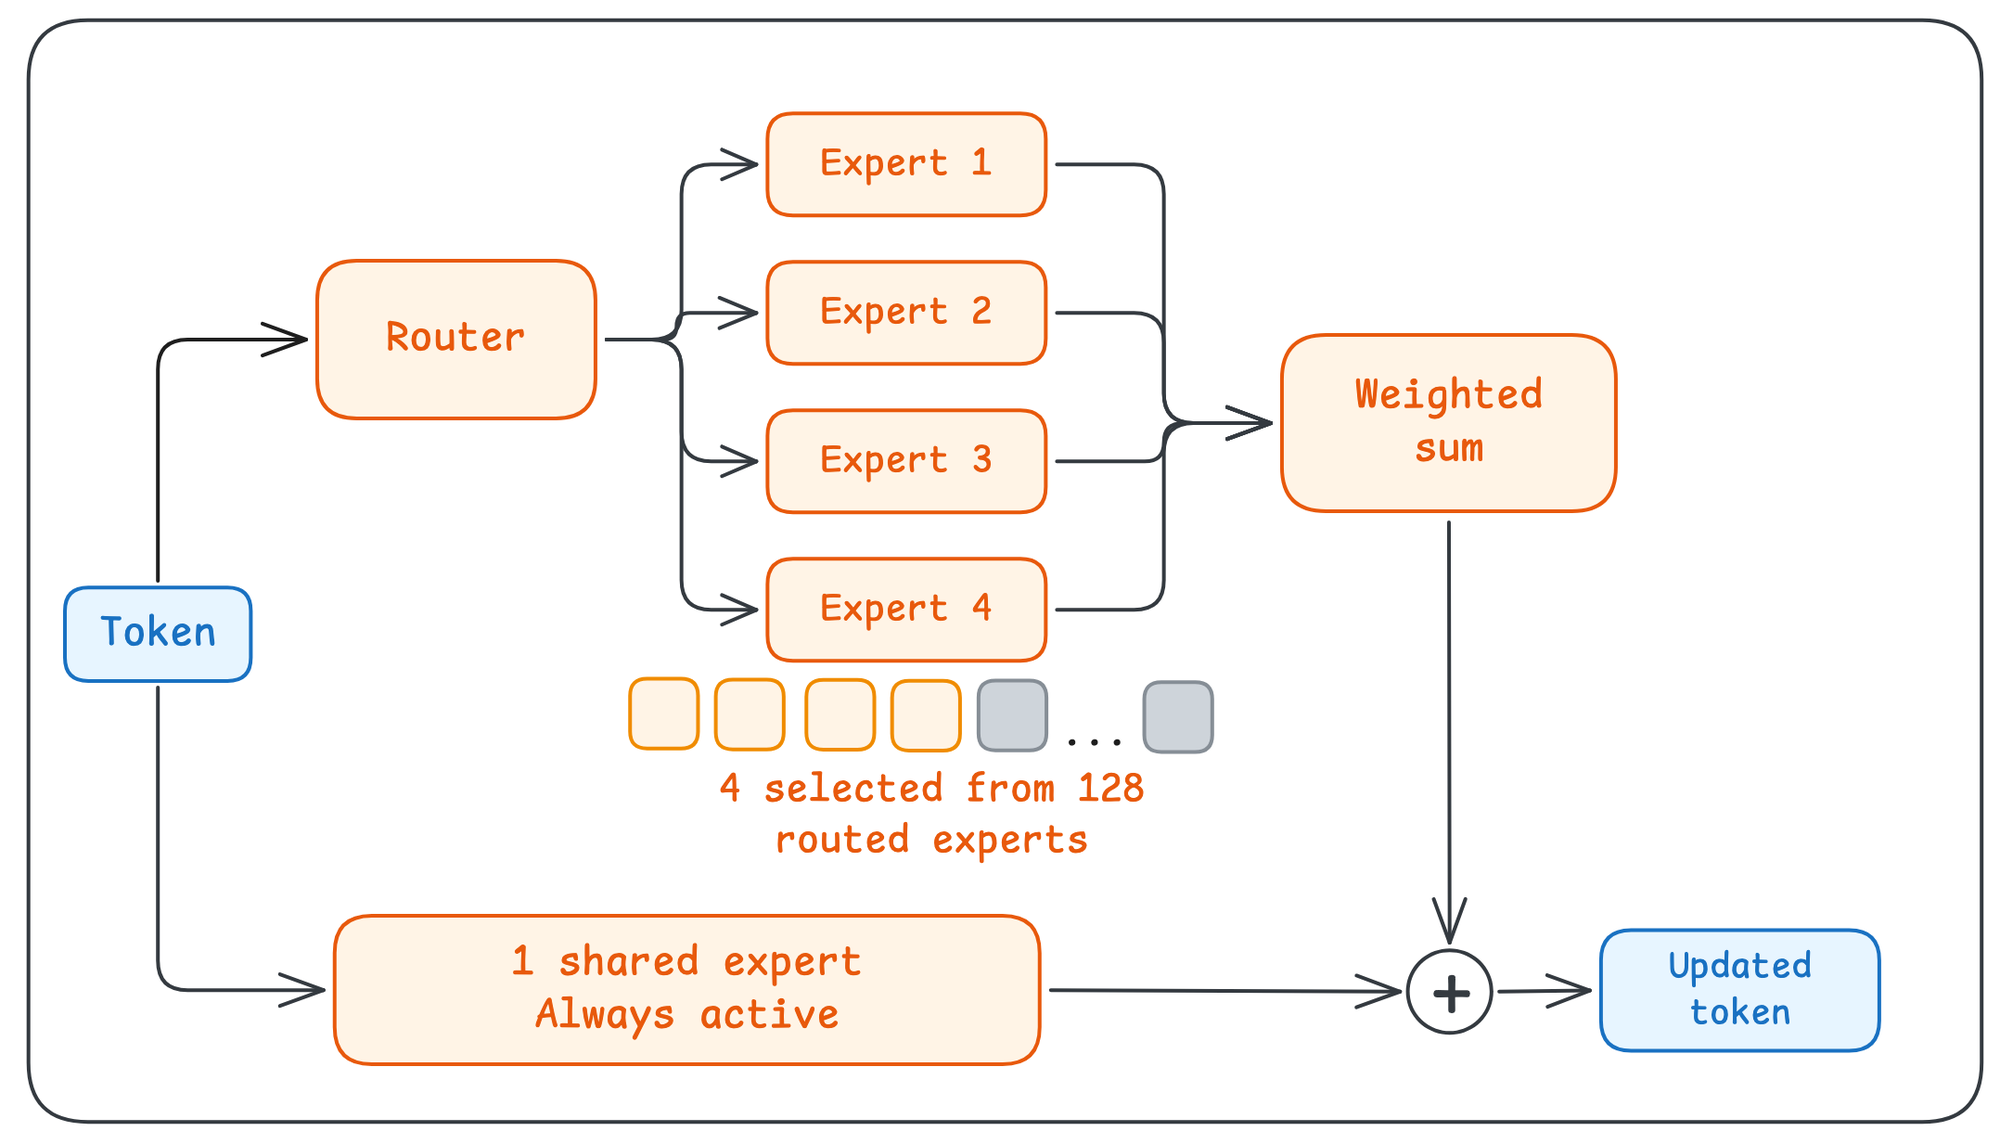
در هر بلوک رمزگشا الگویی ۳ به ۱ از RoPE به NoPE وجود دارد؛ یعنی ۳ لایهٔ رمزگشا از RoPE استفاده میکنند و هر لایهٔ چهارم از NoPE. مدل وضعیت کلید-مقدار را میان لایهها هم به اشتراک میگذارد. نخستین لایهٔ رمزگشا از یک شبکهٔ پیشخور متراکم استفاده میکند. ۷۱ لایهٔ دیگر از بلوکهای MoE استفاده میکنند که در آنها یک مسیریاب softmax برای هر توکن چهار خبره از ۱۲۸ خبره را انتخاب میکند. یک خبرهٔ مشترک همیشه در کنار خبرگان انتخابشده اجرا میشود، بنابراین در مجموع ۵ خبرهٔ فعال برای هر توکن داریم.
دربارهٔ RoPE، Mistral از LeRope استفاده میکند؛ نوعی RoPE با مقیاسبندی YaRN و یک ضریب یادگرفتهشده برای هر فرکانس.
رمزگذار بینایی
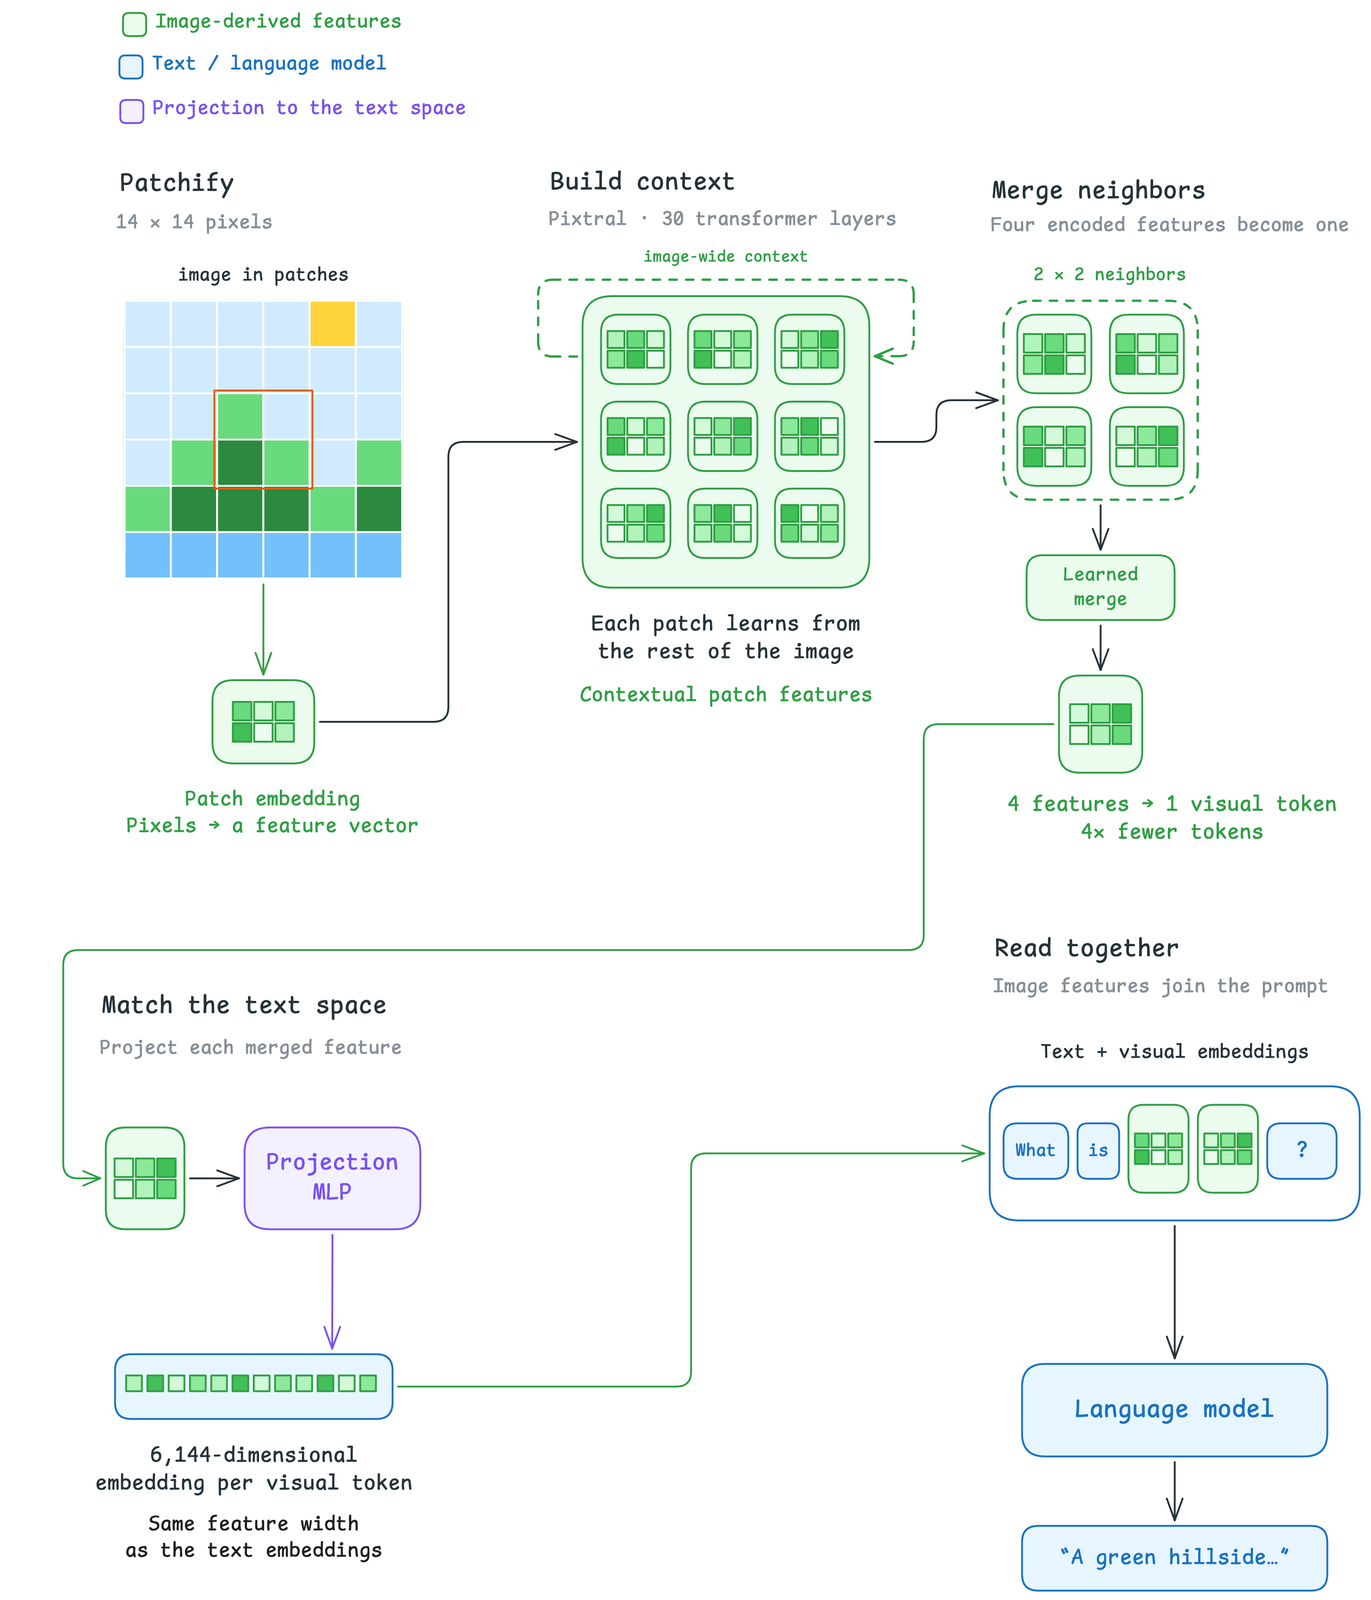
Mistral Large 4 از یک رمزگذار Pixtral با ۱٫۶ میلیارد پارامتر استفاده میکند. Pixtral دارای ۳۰ لایه، بُعد پنهان ۲٬۰۴۸ و ۱۶ سر توجه است. از وصلههای ۱۴×۱۴ و یک پروجکشن ادغام وصله با اندازهٔ ادغام مکانی ۲ استفاده میکند. خط لولهٔ رمزگذار را در پایین میبینید.
نتایج بنچمارک
Mistral Large 4 در کدنویسی، امنیت سایبری، درک چندوجهی و گردشکارهای عاملی عملکرد قوی در بنچمارکها ارائه میدهد و آن را به افزودهای رقابتی به اکوسیستم مدلهای با وزن باز تبدیل میکند. تا تاریخ ۲۹ اکتبر ۲۰۲۶، این مدل پنجمین مدل برتر با وزن باز در شاخص هوش Artificial Analysis است.
در کدنویسی، ML4 به ۶۱٫۷٪ در DeepSWE v1.1، ۵۹٫۴٪ در SWE-Atlas-QnA و ۲۸٫۳٪ در Terminal-Bench 4 میرسد. امتیاز ترکیبی ۴۹٫۸٪ آن در شاخص عامل کدنویسی، آن را جلوتر از DeepSeek V4 Pro 0813 و Qwen3.8 Max قرار میدهد.
قابلیتهای کدنویسی ML4 به کارهای دانشی هم گسترش مییابد، با ۵۹٫۹٪ در AutomationBench و ۱٬۳۹۳ امتیاز Elo در AA-Briefcase که گردشکارهای تجاری و وظایف حرفهای بلندمدت را ارزیابی میکنند.
امنیت سایبری یکی از قابلیتهای شاخص Mistral Large 4 است و این مدل در ارزیابی آسیبپذیری در دنیای واقعی و وظایف مسابقات امنیتی نتایج قوی گرفته است. سه بنچمارک عملکرد سایبری این مدل را برجسته میکنند:
Artificial Analysis Cyber Index: ML4 در این ارزیابی مستقل از توانایی مدلها در یافتن و رفع آسیبپذیریهای نرمافزاری، در میان پنج مدل برتر جهان قرار میگیرد.
بازتولید و وصلهزدن آسیبپذیری: این مدل به ۸۲٪ میرسد که بالاترین امتیاز گزارششده در این آزمون در این شاخص است. این وظیفه مستلزم بازتولید یک آسیبپذیری واقعی در نرمافزار متنباز و سپس وصلهزدن آن است و هم بررسی و هم رفع را میآزماید.
Cybench: ML4 ۹۳٪ از مجموعهای شامل ۴۰ چالش برگرفته از مسابقات امنیتی را حل میکند و عملکرد قوی در مسائل عملی امنیتی نشان میدهد.
Mistral Large 4 همچنین ۹۳٫۳٪ مقاومت در برابر حمله در Lakera’s B3 benchmark نشان میدهد که شاهدی بر استحکام در برابر حملات تزریق پرامپت است. فراتر از بنچمارکها، تستهای داخلی نتایج امیدوارکنندهای در تحلیل بدافزار، اولویتبندی آسیبپذیری و تولید قواعد تشخیص نشان داد.
پشتیبانی از استنتاج
Mistral Large 4 با پشتیبانی روز-صفر برای transformers، vLLM و llama.cpp عرضه شده است. کوانتهای GGUF از GGUF و تیم llama.cpp در دسترساند. گزینههایی برای استقرار از راه دور با Inference Endpoints و استفاده از استنتاج بدون سرور از طریق Inference Providers فراهم کردهایم.
Transformers
پیادهسازی Transformers کلاس AutoModelForMultimodalLM را ارائه میدهد و AutoProcessor گفتگو و ورودیهای تصویری را آماده میکند. Mistral Large 4 میتواند low، medium و high را بهعنوان میزان تلاش استدلال بپذیرد. مقدار پیشفرض high است و توجه داشته باشید که استدلال را نمیتوان غیرفعال کرد؛ بنابراین استفاده از reasoning_effort: none همچنان high را به کار میبرد.
برای اجرای مدل، بستهٔ transformers را ارتقا دهید
pip install --upgrade transformersimport os
from transformers import AutoProcessor, AutoModelForMultimodalLM, DistributedConfig
distributed_config = DistributedConfig(
tp_size=int(os.environ["WORLD_SIZE"]),
ep_size=int(os.environ["WORLD_SIZE"]),
)
model_id = "mistralai/Mistral-Large-4-1T-A52B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
model_id,
distributed_config=distributed_config,
)
# only text
text_messages = [
{
"role": "user",
"content": "Who are you?"
}
]
# text + image
multimodal_messages = [
{
"role": "user",
"content": [
{
"type": "image",
"image": "https://huggingface.co/datasets/huggingface/cats-image/resolve/main/cats_image.jpeg",
},
{
"type": "text",
"text": "How many cats are in the image?",
},
],
},
]
for messages in [text_messages, multimodal_messages]:
inputs = processor.apply_chat_template(
messages,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
reasoning_effort="medium",
).to(model.device).to(model.dtype)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=100)
if int(os.environ["RANK"]) == 0:
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))میتوانید اسکریپت بالا را در یک فایل پایتون به نام script.py ذخیره کنید و سپس اجرا کنید
torchrun --nproc-per-node 8 script.pyvLLM
vLLM از چکپوینت NVFP4 باکیفیت Mistral Large 4 پشتیبانی میکند که ردپای حافظهٔ کمتری دارد و به پردازندههای گرافیکی NVIDIA Blackwell نیاز دارد. این مدل همچنین یک پیشنویسکنندهٔ DSpark برای سرعتبخشی بیشتر در vLLM همراه دارد. سرور را اینگونه راهاندازی کنید:
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --config-format mistral \
  --load-format mistral \
  --tensor-parallel-size 8 \
  --decode-context-parallel-size 8 \
  --enable-expert-parallel \
  --dtype bfloat16 \
  --max-model-len 131072 \
  --max-num-seqs 16 \
  --max-num-batched-tokens 2048 \
  --gpu-memory-utilization 0.85 \
  --enable-prefix-caching \
  --enforce-eager \
  --mm_processor_cache_gb 0.0
پس از بالا آمدن و آماده بودن سرور، میتوانید موارد زیر را اجرا کنید.
curl -s http://127.0.0.1:8000/v1/chat/completions -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"What is 17*23?"}],"max_tokens":512}'
Llama.cpp
Llama.cpp و Llama App از قبل از Mistral Large 4 پشتیبانی میکنند.
میتوانید Llama App را با فرمان زیر نصب کنید:
curl -LsSf https://llama.app/install.sh | shسپس میتوانید سرور را بهصورت زیر راهاندازی کنید و پسوند کوانت را بعد از شناسهٔ مدل بنویسید:
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_Kاین مخزن شامل کوانتهای مشتق از چکپوینت FP8 است و این یکی نسخهٔ NVFP4 است که از مخزن رسمی NVFP4 تبدیل شده است.
پس از راهاندازی سرور، میتوانید به localhost:9931 بروید و با WebUI داخلی گفتگو کنید. از رابط وب میتوانید تصویر برای استنتاج اضافه کنید و اهرم استدلال را تنظیم کنید. همچنین میتوانید بهصورت زیر از سرور پرسوجو کنید. میتوانید مرجع API را برای چندوجهیبودن، فراخوانی ابزار و موارد دیگر ببینید.
curl http://localhost:8080/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "messages": [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "Write a limerick about python exceptions"}
        ]
}'میتوانید استنتاج تصویر-متن را بهصورت زیر اجرا کنید.
curl -s http://127.0.0.1:8080/v1/chat/completions \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer <your-key>" \
    -d '{
        "model": "muse-spark-open",
        "messages": [
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": "What is in this image?"
                    },
                    {
                        "type": "image_url",
                        "image_url": {
                            "url": "data:image/png;base64,..."
                        }
                    }
                ]
            }
        ],
        "temperature": 0
    }'
تیم llama.cpp کوانتهای زیر را عرضه میکند: IQ2_XXS، Q2_K، Q4_K_M، NVFP4، Q8_0 و BF16 برای تبدیلهای بیشتر. کوانتهای ۲ بیتی روی یک کامپیوتر Apple Silicon Ultra با ۵۱۲ گیگابایت حافظهٔ یکپارچه اجرا میشوند. بقیه به استنتاج توزیعشده نیاز دارند. میتوانید روی چند کارت NVIDIA یا AMD هم اجرا کنید.
با اجرای Q2_K روی یک M3 Ultra، توان عملیاتی پیشپرکردن حدود ۹۰ توکن بر ثانیه و سرعت تولید ۱۵ توکن بر ثانیه به دست آوردیم. روی ۴ کارت RTX6000 Pro نتایج زیر را مشاهده کردیم:
NVFP4: اندازهٔ زمینه ۳۲K، پیشپرکردن ۱۳۰ تا ۵۹۰ توکن بر ثانیه، سرعت تولید حدود ۱۰ توکن بر ثانیه
IQ2_XXS: اندازهٔ زمینه ۸۰۰K. در اندازههای زمینهٔ کوتاه، پیشپرکردن ۵۰۰ توکن بر ثانیه و تولید ۳۰ توکن بر ثانیه است. اما در زمینههای بلند، عملکرد به ۱۲۹ توکن بر ثانیه (پیشپرکردن) و ۳ توکن بر ثانیه (تولید) کاهش مییابد.
تنظیم دقیق با TRL
ما پشتیبانی روز-صفر از تنظیم دقیق Mistral Large 4 با TRL را هم ارائه میدهیم. فقط کافی است به آخرین نسخهٔ transformers، trl و peft ارتقا دهید.
pip install --upgrade transformers trl peftدر مثال زیر مدل را آموزش میدهیم تا به چند زبان فکر کند. مدل تنظیمدقیقشده میتواند به زبانی که پرامپت سیستم میخواهد استدلال کند!
این اسکریپت روی گونهٔ FP8 و روی یک گرهٔ ۸xB300 اجرا میشود. مثال کامل، همراه با یک لانچر Slurm، در نمونههای TRL موجود است.
# torchrun --nproc-per-node 8 sft.py
import os

from datasets import load_dataset
from peft import LoraConfig
from transformers import AutoModelForImageTextToText, DistributedConfig
from trl import SFTConfig, SFTTrainer

world_size = int(os.environ["WORLD_SIZE"])
model_id = "mistralai/Mistral-Large-4-1T-A52B"
model = AutoModelForImageTextToText.from_pretrained(
    model_id,
    distributed_config=DistributedConfig(fsdp_size=world_size, ep_size=world_size),
    dtype="auto",
)

dataset = load_dataset("HuggingFaceH4/Multilingual-Thinking", split="train")
# the assistant turns carry reasoning, so render them in reasoning mode
dataset = dataset.map(lambda x: {"chat_template_kwargs": {"reasoning_effort": "high"}})

trainer = SFTTrainer(
    model=model,
    args=SFTConfig(
        packing=True,
        max_length=4096,
        assistant_only_loss=True,
        learning_rate=1e-4,
        lr_scheduler_type="cosine",
        warmup_steps=10,
    ),
    train_dataset=dataset,
    peft_config=LoraConfig(
        r=16,
        lora_alpha=32,
        target_modules=r".*language_model.*\.(q_proj|kv_a_proj_with_mqa|kv_b_proj|o_proj|gate_proj|up_proj|down_proj)",
    ),
)
trainer.train()
Inference Endpoints
Mistral Large 4 روی Inference Endpoints هم در دسترس است، با یک دستورالعمل آمادهٔ استقرار روی ۸ پردازندهٔ گرافیکی NVIDIA H200. این دستورالعمل vLLM را با وزنهای FP8 که با موازیسازی تانسور و خبره روی هر هشت پردازندهٔ گرافیکی تقسیم شدهاند اجرا میکند و از سر پیشنویس داخلی DSpark مدل برای تولید سریعتر از طریق رمزگشایی گمانهزنانه بهره میگیرد. تا ۱۳۱ هزار توکن زمینه ارائه میدهد و همزمان تا ۱۶ درخواست را پردازش میکند و نتایج زیر را مشاهده کردیم:
درخواست تکی: زمان تا اولین توکن حدود ۰٫۶ ثانیه برای پرامپت ۱ هزار توکنی، و سرعت تولید حدود ۶۵ توکن بر ثانیه که در پرامپتهای گفتگو که پیشنویسهای DSpark پذیرفته میشوند به ۱۲۰ تا ۱۳۸ توکن بر ثانیه میرسد.
پرامپتهای بلند: پرامپتهای ۱۶ هزار توکنی، چهار تا همزمان، با سرعت مجموع حدود ۴٬۳۰۰ توکن بر ثانیه پیشپر میشوند و زمان تا اولین توکن ۸ تا ۹ ثانیه است.
تحت بار: حدود ۴۸۰ توکن بر ثانیه تولید کل در ۱٬۰۰۰ گفتگوی ShareGPT.
میتوانید آن را با CLI مربوط به hf بهصورت زیر مستقر کنید:
hf endpoints catalog deploy --repo mistralai/Mistral-Large-4-1T-A52B --name mistral-large-4پس از اجرای endpoint، میتوانید API سازگار با OpenAI آن را با استفاده از نشانی endpoint و توکن Hugging Face خود پرسوجو کنید. فیلد reasoning_effort کنترل میکند مدل پیش از پاسخ چقدر استدلال کند و میتوان آن را روی low، medium یا high (پیشفرض) تنظیم کرد.
curl "$(hf endpoints describe mistral-large-4 --json | jq -r .status.url)/v1/chat/completions" \
    -H "Authorization: Bearer $(hf auth token 2>/dev/null)" \
    -H "Content-Type: application/json" \
    -d '{
        "model": "mistralai/Mistral-Large-4-1T-A52B",
        "messages": [
            {"role": "user", "content": "Write a limerick about python exceptions"}
        ],
        "reasoning_effort": "medium"
    }'
پاسخ در choices[0].message.content و استدلال در choices[0].message.reasoning برمیگردد. این endpoint از فراخوانی ابزار، خروجیهای ساختاریافته، ورودی تصویر و جریاندهی از طریق فیلدهای استاندارد Chat Completions هم پشتیبانی میکند.
Dell Enterprise Hub
سادهترین راه برای راهاندازی سرورهای Dell AI (NVIDIA H200، B200، GB200 یا GB300) نصب CLI مربوط به dell-ai است:
pip install dell-ai && dell-ai loginو از آن برای اجرای یک دستورالعمل بهینهشده برای Mistral Large 4 مثلاً روی یک گرهٔ NVIDIA B300 استفاده کنید.
dell-ai models deploy --model-id mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
    --engine docker \
    --platform-id xe9780-nvidia-b300 \
--gpus 4میتوانید اطلاعات بیشتر دربارهٔ این انتشار را در Dell Enterprise Hub (DEH) پیدا کنید.
آن را امتحان کنید
وزنها را از مجموعهٔ Mistral Large 4 بردارید، آنها را بهصورت محلی با GGUFها اجرا کنید یا با Inference Endpoints مستقر کنید. بیصبرانه منتظریم ببینیم با Le Chonk چه میسازید. تنظیمهای دقیق، کوانتها و سایر خروجیهای خود را در Hub به اشتراک بگذارید!