مدلهای تعبیه چندبرداری به هر توکن پرسوجو این امکان را میدهند که جداگانه در سند به دنبال تطبیق بگردد. همین ویژگی، این مدلها را برای جستوجو بسیار توانمند میکند، اما بردارهای اسناد بهسرعت انباشته میشوند. یک پیکره با میلیونها سند میتواند صدها میلیون بردار داشته باشد!
تجمیع توکن با ادغام بردارهای مشابه توکنها، این نمایشها را کوچکتر میکند. اما هرچه فشردهسازی را تهاجمیتر کنیم، احتمال از دست رفتن اطلاعات مفید بیشتر میشود. آموزش آگاه از تجمیع به کدگذار میآموزد هنگام ادغام بردارها اطلاعات مهم را حفظ کند و به این ترتیب، با همان بودجه ذخیرهسازی، بازیابی بهتری به دست میآید.
در این مطلب توضیح میدهم تجمیع چگونه کار میکند، با Sentence Transformers مدلی برای بازیابی فشرده آموزش میدهم و تعادل میان کیفیت و ذخیرهسازی را بررسی میکنم. با pool_factor=4، مدلی که به روش معمول آموزش دیده است ۹۴.۶٪ از nDCG@10 بدون تجمیع خود روی NanoBEIR را حفظ میکند، در حالی که تعداد بردارهای سند ۴ برابر کاهش یافته است. آموزش آگاه از تجمیع توکن، این نرخ حفظ را با همان بودجه ذخیرهسازی به ۹۷.۸٪ میرساند! ببینیم چطور.
این مطلب بر آموزش آگاه از تجمیع توکن بنا شده است که در مطالعه «Learn to Pool» اثر Stefan Josef (استفان یوزف) و مطالعه منظمسازی تجمیع در LightOn بررسی شدهاند؛ این مطالعات آموزش هدفمند و بودجههای تطبیقی را هم پوشش میدهند. در اینجا بر درک روش و بهکارگیری آن با یک مثال کوتاه و بازتولیدپذیر در Sentence Transformers تمرکز میکنم.
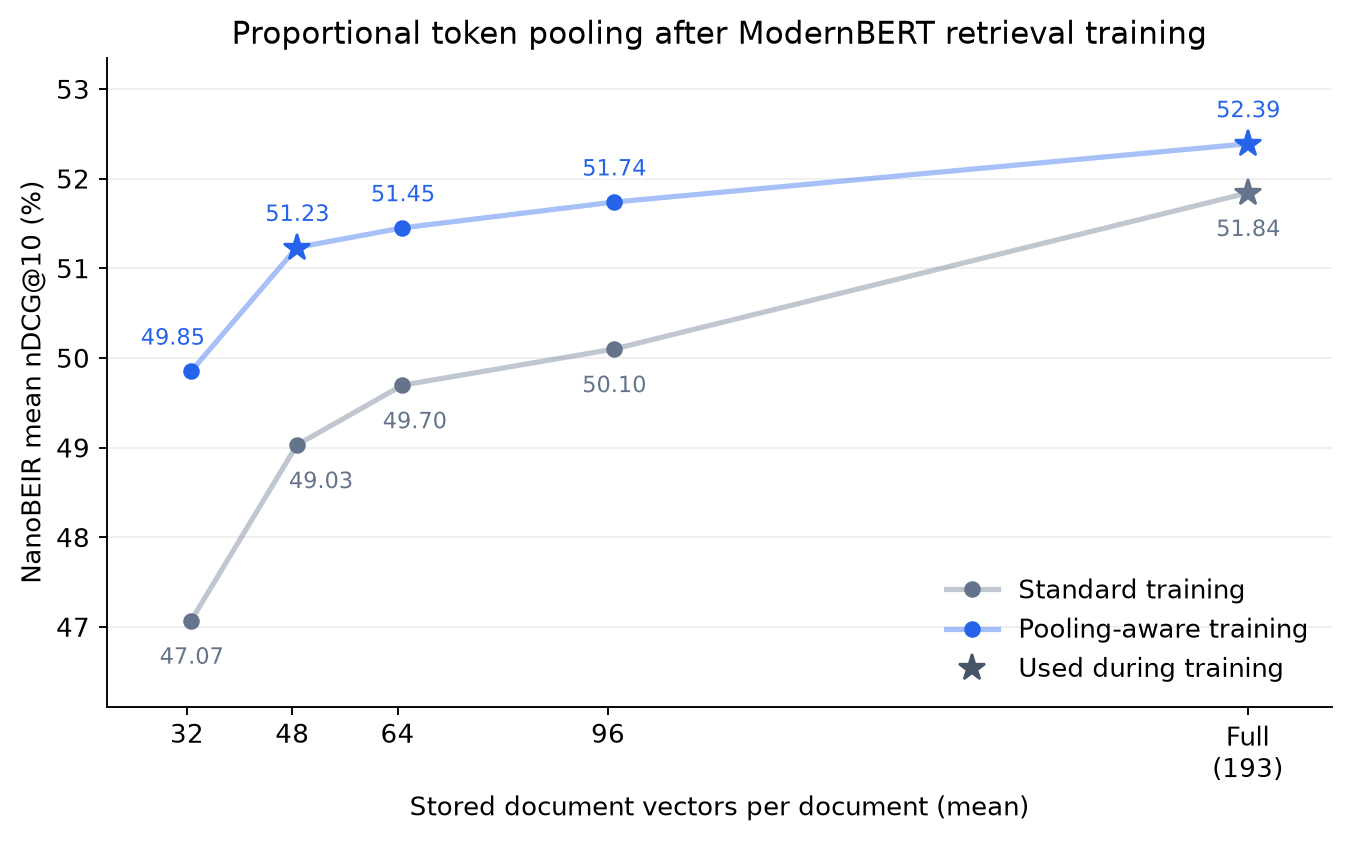
آموزش آگاه از تجمیع کیفیت بازیابی را با همان بودجه بردار بهبود میدهد. جزئیات در ادامه آمده است.
فهرست مطالب
چرا بازیابی چندبرداری به این تعداد بردار نیاز دارد
تجمیع توکن انتخاب بودجه تجمیع کالیبراسیون تجمیع تطبیقی
آموزش آگاه از تجمیع توکن یک پوشش زیان در Sentence Transformers شتابدهی اختیاری با کرنل
استفاده از مدل آموزشدیده
نتایج ارزیابی
ترکیب روشهای فشردهسازی
منابع
کد و مدلها
چرا بازیابی چندبرداری به این تعداد بردار نیاز دارد
یک مدل تعبیه تکبرداری کل سند را در یک بردار فشرده میکند. در مقابل، مدلهای چندبرداری مانند ColBERT مجموعهای از بردارهای توکن زمینهای را نگه میدارند تا بخشهای مختلف پرسوجو بتوانند با بخشهای مختلف سند تطبیق پیدا کنند.
برای نمونه، پرسوجویی درباره لپتاپی با عمر باتری طولانی میتواند شواهد مربوط به لپتاپ را در بخشی از سند و دوام باتری را در بخشی دیگر پیدا کند. در امتیازدهی MaxSim، هر بردار پرسوجو بهترین بردار سند منطبق با خود را انتخاب میکند و این امتیازها با هم جمع میشوند:
MaxSim ( Q , D ) = ∑ q ∈ Q max d ∈ D q ⊤ d \operatorname{MaxSim}(Q, D) = \sum_{q \in Q} \max_{d \in D} q^\top d MaxSim ( Q , D ) = q ∈ Q ∑ d ∈ D max q ⊤ d
حتی با کوانتیزهسازی باقیمانده ۲ بیتی یا ۴ بیتی که Fast-PLAID پشتیبانی میکند، ذخیره صدها بردار برای هر سند رقم قابل توجهی میشود. با ۴ بیت برای هر مختصات باقیمانده، ۲۰۰ بردار ۱۲۸ بُعدی به ۱۲.۸ کیلوبایت باقیمانده کوانتیزهشده برای هر سند نیاز دارند، یعنی ۱۲.۸ گیگابایت برای یک میلیون سند. تجمیع هر سند به ۵۰ بردار، با همان ابعاد و دقت، این مقدار را به ۳.۲ گیگابایت کاهش میدهد.
نکته مفید این است که بسیاری از بردارهای سند میتوانند به هم شبیه باشند. ممکن است چند توکن مفاهیم نزدیک به هم را توصیف کنند و فرصتی برای نمایش آنها در کنار هم فراهم شود.
تجمیع توکن
HierarchicalTokenPooling با استفاده از خوشهبندی سلسلهمراتبی Ward، تعبیههای مشابه توکن را گروهبندی میکند. این روش با یک گروه برای هر بردار توکن شروع میکند و پیوسته دو گروهی را ادغام میکند که کمترین افزایش را در پراکندگی بردارها درون گروههایشان ایجاد میکنند. این پراکندگی با مجموع مجذور فاصله هر بردار تا میانگین گروهش سنجیده میشود؛ بنابراین روش Ward گروههای فشردهای از بردارهای مشابه را ترجیح میدهد.
این ادغامها سلسلهمراتبی از گروههای بهتدریج بزرگتر میسازند تا بتوانیم سطحی از فشردهسازی را متناسب با بودجه خود انتخاب کنیم. سپس هر گروه را با میانگینش نمایش میدهیم و بردارهای حاصل را دوباره نرمال میکنیم تا برای امتیازدهی MaxSim آماده باشند.
میتوانید فشردهسازی را متناسب با طول سند تنظیم کنید:
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
با pool_factor=4، اسناد تقریباً یکچهارم بردارهای اولیه خود را نگه میدارند، بنابراین اسناد بلندتر میتوانند بهتناسب ظرفیت بیشتری حفظ کنند. بهطور پیشفرض، توکن اول از ادغام محافظت میشود و تجمیع فقط روی تعبیههای سند اعمال میشود و تعبیههای پرسوجو بدون تغییر میمانند.
انتخاب بودجه تجمیع
HierarchicalTokenPooling سه کنترل جایگزین ارائه میدهد:
تنظیم | چه چیزی را بیان میکند
max_tokens=16 | حداکثر ۱۶ بردار برای هر سند، شامل توکنهای محافظتشده.
pool_factor=4 | تقریباً یکچهارم بردارهای اولیه هر سند.
distance_threshold=... | یک آستانه مشترک فاصله ادغام Ward که اجازه میدهد تعداد بردارها متناسب با هندسه تعبیه تغییر کند.
این تفاوت وقتی طول اسناد متفاوت است اهمیت پیدا میکند. با pool_factor=4، یک سند بلندتر میتواند تقریباً یکچهارم بردارهایش را نگه دارد و نمایشش همراه با محتوایش رشد کند. با distance_threshold، تعداد بردارها میتواند وقتی تعبیههای متمایز بیشتری باید حفظ شوند افزایش یابد.
کالیبراسیون تجمیع تطبیقی
تجمیع تطبیقی از یک آستانه فاصله مشترک استفاده میکند تا تعبیههای مشابه را تهاجمیتر ادغام کند و در عین حال برای اسناد با محتوای متمایز بردارهای بیشتری حفظ کند. این روش با هر مدل چندبرداری قابل استفاده است، از جمله مدلی که با هدف آگاه از تجمیع آموزش ندیده است.
بهجای انتخاب دستی آستانه، میتوانید آن را برای یک میانگین هدف تعداد بردار کالیبره کنید. با داشتن یک نمونه نماینده از پیکره خود در calibration_documents:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("lightonai/LateOn")
calibration_embeddings = model.encode_document(calibration_documents)
threshold = HierarchicalTokenPooling.calibrate_distance_threshold(calibration_embeddings, target_tokens=16)
pooling = HierarchicalTokenPooling(distance_threshold=threshold)

# Apply pooling, targeting an average of 16 vectors per document
document_embeddings = model.encode_document(documents_to_index, token_pooling=pooling)
کالیبراسیون فقط به تعبیههای سند نیاز دارد و آستانهای برمیگرداند که میتوانید هنگام ایندکسسازی دوباره استفاده کنید. هدف یک میانگین است، بنابراین اسناد منفرد میتوانند بیشتر یا کمتر از ۱۶ بردار بگیرند. میانگین بهدستآمده ممکن است روی پیکرهای دیگر تغییر کند.
آموزش آگاه از تجمیع توکن
تجمیع میتواند روی یک مدل چندبرداری معمولی هم مفید باشد. دشواری زمانی ظاهر میشود که سند تمایزی داشته باشد که برای بازیابی مهم است، اما ادغام بردارهایش بازیابی آن تمایز را سختتر کند. هدف آموزش اولیه هرگز از مدل نمیخواست با این نمایشهای فشرده کار کند. اما میتوانید دقیقاً همین را به آن بیاموزید.
اگر با تعبیههای ماتریوشکا (Matryoshka embeddings) کار کردهاید، اصل آموزش برایتان آشنا خواهد بود. ماتریوشکا یک هدف بازیابی را در چند عرض تعبیه اعمال میکند و به پیشوندهای کوچکتر میآموزد که همچنان مفید بمانند. آموزش آگاه از تجمیع همین هدف را روی نمایشهایی با تعداد کمتر بردار توکن اعمال میکند.
در مثال من، هر دسته آموزشی دو زیان را مشارکت میدهد:
بازیابی با استفاده از تعبیههای اولیه سند.
بازیابی پس از فشردهسازی اسناد به تقریباً یکچهارم بردارهای اولیهشان.
میانگین آنها را میگیرم:
L = 1 2 L u n p o o l e d + 1 2 L p o o l e d \mathcal{L} = \tfrac{1}{2}\mathcal{L}_{\mathrm{unpooled}} + \tfrac{1}{2}\mathcal{L}_{\mathrm{pooled}} L = 2 1 L unpooled + 2 1 L pooled
جمله اول به مدل میآموزد با نمایشهای کامل خود بازیابی کند. جمله دوم به آن میآموزد تعبیههای توکنش را طوری بچیند که تطبیقهای مفید پس از تجمیع باقی بمانند. هر دو هدف همان کدگذار را بهروزرسانی میکنند و به آن درباره بازیابی پیش و پس از فشردهسازی بازخورد میدهند.
خوشهبندی Ward تصمیمهای گسستهای درباره این میگیرد که کدام توکنها به هم تعلق دارند. در طول آموزش، HierarchicalTokenPooling از برآوردگر مستقیم (straight-through estimator) استفاده میکند تا گرادیانها را از بردارهای تجمیعشده به توکنهای عضو آنها برگرداند، بدون آنکه تخصیصهای خوشه را مشتقگیری کند. سپس کدگذار میتواند از خطاهای بازیابی که با نمایشهای تجمیعشدهاش رخ داده بیاموزد.
یک پوشش زیان در Sentence Transformers
MultiVectorTokenPoolingLoss یک زیان بازیابی چندبرداری موجود را میپوشاند و آن را با تجمیعکنندههای انتخابی شما اعمال میکند:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import (
    CachedMultiVectorMultipleNegativesRankingLoss,
    MultiVectorTokenPoolingLoss,
)
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("answerdotai/ModernBERT-base", similarity_fn_name="maxsim")
pooling = HierarchicalTokenPooling(pool_factor=4)

base_loss = CachedMultiVectorMultipleNegativesRankingLoss(model, mini_batch_size=64)
loss = MultiVectorTokenPoolingLoss(
    model,
    base_loss,
    token_poolings=[None, pooling],
    weights=[0.5, 0.5],
)
CachedMultiVectorMultipleNegativesRankingLoss هدف بازیابی را فراهم میکند. این زیان به هر پرسوجو میآموزد سند مرتبطش را بالاتر از اسناد منفی در دسته امتیاز دهد. بهطور پیشفرض از model.similarity استفاده میکند، یعنی تنظیم شباهت مدل (در این مثال MaxSim) و تنظیمات کرنل. مدلی که با similarity_fn_name="meanmaxsim" پیکربندی شده باشد نیز در طول آموزش از MeanMaxSim استفاده میکند.
کش گرادیان به کدگذار اجازه میدهد دستههای کوچک را پردازش کند و در همان حال مجموعه بزرگتری از منفیهای دروندستهای را نگه دارد. اسکریپت آموزش من از دستههای کوچک ۶۴تایی با اندازه دسته آموزشی ۲۵۶ استفاده میکند.
MultiVectorTokenPoolingLoss هدف فشردهسازی را اضافه میکند. در اینجا None یعنی یک گونه از تعبیههای اولیه استفاده میکند، در حالی که pooling گونه pool_factor=4 را فراهم میکند. دو وزن، زیانهایشان را میانگین میگیرند. گونههای تجمیع از تعبیههای توکن محاسبهشده دوباره استفاده میکنند، بنابراین هر تجمیعکننده اضافی کار خوشهبندی و امتیازدهی را اضافه میکند بدون آنکه برای آن گونه به یک گذر جداگانه کدگذار نیاز باشد.
تجمیعکنندهها میتوانند پیادهسازیهای سفارشی BaseTokenPooling باشند که گرادیانها را از طریق تعبیههای ورودیشان حفظ میکنند. میتوانید هدف آموزش را با نمایشی که میخواهید مستقر کنید سازگار کنید.
تجمیعکننده pool_factor=4 را با پیکربندی استقرار انتخابی خود جایگزین کنید، یا چند تجمیعکننده را بگنجانید و برای زیانهایشان وزن انتخاب کنید.
اسکریپت کامل آموزش شامل مجموعه داده، آموزشدهنده، زیان اعتبارسنجی و ارزیابیهای کوچک بازیابی در طول آموزش است. از یک نسخه محلی مخزن، هر دو گونه را بهصورت محلی با uv اجرا کنید:
uv run examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py --baseline
uv run examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py
اسکریپت وابستگیهای آموزش و کرنل خود را اعلام میکند، بنابراین uv آنها را برایتان نصب میکند. کرنلهای سازگار بهطور خودکار فعال میشوند.
همچنین میتوانید با Hugging Face Jobs روی GPU ابری آموزش دهید. CLI را نصب کنید و با توکنی وارد شوید که بتواند Jobs را اجرا کند و مدلها را بارگذاری کند:
pip install -U huggingface_hub
hf auth login

hf jobs uv run \
    --flavor a10g-small \
    --timeout 4h \
    --secrets HF_TOKEN \
    -- https://raw.githubusercontent.com/huggingface/sentence-transformers/main/examples/multi_vector_encoder/training/token_pooling/training_cached_contrastive.py
این دستور گونه آگاه از تجمیع را روی یک GPU از نوع A10G با محدودیت زمانی چهار ساعت اجرا میکند. ارسال HF_TOKEN بهعنوان یک راز به اسکریپت اجازه میدهد پس از پایان آموزش مدل آموزشدیده را در حساب Hub شما بارگذاری کند. برای اجرای خط پایه با زیان معمولی هم، دستور را با --baseline پس از نشانی اسکریپت تکرار کنید.
شتابدهی اختیاری با کرنل
میتوانید امتیازدهی MaxSim، خوشهبندی Ward و عملیات پشتیبانیشده ستون فقرات را با کرنلها شتاب دهید. وابستگیهای آموزش و کرنل را نصب کنید:
pip install -U "sentence-transformers[train,kernels]"در مثال آموزش بالا، مقداردهی اولیه مدل و تجمیعکننده را پیش از ساخت زیان جایگزین کنید:
model = MultiVectorEncoder(
    "answerdotai/ModernBERT-base",
    device="cuda",
    similarity_fn_name="maxsim",
    use_kernels=True,
)
pooling = HierarchicalTokenPooling(pool_factor=4)تجمیعکنندههای سلسلهمراتبی بهطور پیشفرض تنظیمات کرنل مدل را به ارث میبرند، بنابراین فقط باید کرنلها را روی مدل فعال کنید.
Sentence Transformers کرنلهای سازگار با تنظیمات شما را انتخاب میکند و هرجا جایگزینی موجود نباشد از پیادهسازی موجود استفاده میکند. برای نمونه، کرنل پیشفرض MaxSim پرسوجوها را در برابر اسناد امتیاز میدهد بدون آنکه ماتریس کامل شباهت توکن را در حافظه بسازد، اما به CUDA و Triton نیاز دارد.
کرنل پیشفرض خوشهبندی Ward با اجرا روی CUDA بهجای CPU، خوشهبندی سلسلهمراتبی را بهطور قابل توجهی سریعتر میکند. بسته به تنظیمات، ۳۰ تا ۱۵۰ برابر سریعتر از SciPy است.
استفاده از مدل آموزشدیده
بیایید مدل آگاه از تجمیع را بارگذاری کنیم و با تعبیههای فشردهٔ سند بازیابی کنیم. تنظیمات کرنل همراه مدل ذخیره نمیشوند، بنابراین اگر میخواهید برای استنتاج هم از آنها استفاده کنید، هنگام بارگذاری use_kernels=True را اضافه کنید:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

model = MultiVectorEncoder("tomaarsen/mve-ModernBERT-base-token-pooling")
pooling = HierarchicalTokenPooling(pool_factor=4)

queries = ["Which planet is known as the Red Planet?"]
documents = [
    "Venus is often called Earth's twin because of its similar size and proximity.",
    "Mars, known for its reddish appearance, is often referred to as the Red Planet.",
    "Jupiter, the largest planet in our solar system, has a prominent red spot.",
]

query_embeddings = model.encode_query(queries)
document_embeddings = model.encode_document(documents, token_pooling=pooling)

print([len(embedding) for embedding in document_embeddings])
# [5, 6, 5]
print(model.similarity(query_embeddings, document_embeddings))
# tensor([[16.0037, 25.9879, 22.8159]], device='cuda:0')

# For comparison, the same model without token pooling:
# [18, 21, 19]
# tensor([[16.6115, 27.6060, 24.1766]], device='cuda:0')تجمیعکننده تعبیههای سند را پس از خط لولهٔ پیشرو کدگذار فشرده میکند و مجموع را از ۵۸ بردار به ۱۶ کاهش میدهد، در حالی که تعبیههای پرسوجو بدون تغییر میمانند. Mars همچنان بالاترین امتیاز شباهت را میگیرد و پس از آن Jupiter و Venus قرار دارند، بنابراین رتبهبندی با وجود ذخیرهٔ بردارهای بسیار کمتر سند حفظ میشود.
میتوانید pool_factor را هنگام استنتاج تغییر دهید تا با همان مدل آموزشدیده بودجهٔ ذخیرهسازی دیگری را بررسی کنید. برای استفادهٔ مکرر، میتوانید هنگام مقداردهی اولیهٔ MultiVectorEncoder مقدار token_pooling=pooling را هم بدهید تا به پیشفرض زمان اجرا تبدیل شود. وظایف تجمیعکننده همچنان تعیین میکنند کدام ورودیها فشرده شوند (مثلاً فقط اسناد).
نتایج ارزیابی
برای بررسی، دو مدل را از answerdotai/ModernBERT-base آموزش دادم، هرکدام با یک لایهٔ تصویربرداری توکن ۱۲۸ بُعدی تازه:
tomaarsen/mve-ModernBERT-base-token-pooling-baseline، که فقط از زیان متضاد کششده استفاده میکند.
tomaarsen/mve-ModernBERT-base-token-pooling، که از زیان متضاد کششده استفاده میکند که با اهداف بدون تجمیع و pool_factor=4 بالا پوشش داده شده است.
هر دو اجرا یک دوره روی همان ۱۲۰٬۰۰۰ سهگانهٔ MS MARCO، با seed 42 و تنظیمات یکسان مقداردهی اولیه و بهینهسازی انجام شدهاند. سقف توکن آموزش ۳۰۰ است و پرسوجوهای کوتاه به حداقل ۳۲ موقعیت توکن گسترش مییابند تا بردارهای زمینهای پرسوجوی بیشتری فراهم شود. تنها تفاوت دو آزمایش زیان است و جستوجوی فراپارامتر انجام ندادم.
هر دو مدل را روی NanoBEIR@13 ارزیابی کردم و میانگین nDCG@10 (٪) را گزارش میکنم. نمودار آموزش معمول و آموزش آگاه از تجمیع را با pool_factorهای ۲، ۳، ۴ و ۶ و در کنار بازیابی بدون تجمیع مقایسه میکند. جدول سقفهای ثابت و آستانههای تطبیقی را هم دربر دارد و نشان میدهد منافع آموزش چگونه به تنظیمات تجمیع دیگر منتقل میشود.
تجمیع هنگام استنتاج | میانگین بردارها | مدل معمول | مدل آگاه از تجمیع | بهبود (واحد)
بدون تجمیع | 193.22 | 51.84 | 52.39 | +0.55
pool_factor=2 | 96.86 | 50.10 | 51.74 | +1.64
pool_factor=3 | 64.74 | 49.70 | 51.45 | +1.76
pool_factor=4 | 48.68 | 49.03 | 51.23 | +2.20
pool_factor=5 | 39.04 | 48.13 | 50.28 | +2.15
pool_factor=6 | 32.62 | 47.07 | 49.85 | +2.78
max_tokens=64 | 54.76 | 49.27 | 50.89 | +1.63
max_tokens=32 | 29.58 | 48.25 | 50.12 | +1.87
max_tokens=16 | 15.60 | 46.61 | 49.26 | +2.65
max_tokens=8 | 7.99 | 43.12 | 46.61 | +3.48
max_tokens=4 | 4.00 | 37.22 | 43.00 | +5.78
distance_threshold (کالیبرهشده) | 54.76 | 50.10 | 51.24 | +1.14
distance_threshold (کالیبرهشده) | 29.58 | 48.38 | 50.96 | +2.58
distance_threshold (کالیبرهشده) | 15.60 | 47.23 | 49.63 | +2.41
برای تجمیع تطبیقی، آستانهای جداگانه برای هر کدگذار و پیکرهٔ NanoBEIR کالیبره کردم و از تعبیههای سند بدون تجمیع آن برای تطبیق با میانگین تعداد بردارها تحت سقفهای ۶۴، ۳۲ و ۱۶ استفاده کردم. اسناد کوتاه این میانگینها را به زیر سقفهای مربوط میآورند.
در pool_factor=4 آموزشدیده، nDCG@10 از 49.03 به 51.23 بهبود مییابد، در حالی که ۷۴.۸٪ بردارهای سند کمتر از بازیابی بدون تجمیع ذخیره میشود. این نرخ حفظ امتیاز را از ۹۴.۶٪ به ۹۷.۸٪ میرساند؛ نرخ حفظ یعنی میانگین nDCG@10 تجمیعشده تقسیم بر میانگین بدون تجمیع همان مدل. بازیابی بدون تجمیع هم از 51.84 به 52.39 بهبود مییابد.
این بهبودها به سقفهای ثابت و تجمیع تطبیقی هم گسترش مییابد، هرچند آموزش فقط با نمایش کامل و تجمیع نسبی انجام شده بود. با میانگین ۲۹.۵۸ بردار برای هر سند، تجمیع تطبیقی ۹۷.۳٪ از امتیاز بدون تجمیع مدل آگاه از تجمیع را حفظ میکند و در همان حال ۸۴.۷٪ بردارهای سند کمتر ذخیره میشود. مدل آموزشدیده به روش معمول با همان بودجه ۹۳.۳٪ را حفظ میکند.
ترکیب روشهای فشردهسازی
اگر اندازهٔ ایندکس دغدغهٔ اصلی شماست، این گزینهها را به این ترتیب در نظر میگیرم:
کوانتیزهسازی تعبیه به ۴، ۲ یا ۱ بیت، برای نمونه با Fast-PLAID، برای کاهش ذخیرهسازی هر مختصات.
تجمیع توکن برای کاهش تعداد بردارهای سند، بهصورت اختیاری همراه با تنظیم دقیق آگاه از تجمیع که در این مطلب نشان داده شد.
تعبیههای توکن ماتریوشکا برای کاهش ابعاد هر بردار توکن، بهصورت اختیاری همراه با تنظیم دقیق برای حفظ کیفیت بازیابی در عرضهای کوچکتر.
اگر ابعاد پیشفرض مدل بزرگتر از ۱۲۸ است، برش ماتریوشکا و تنظیم دقیق را هم زودتر در نظر میگیرم. این رویکردها را میتوان ترکیب کرد، بنابراین اندازه ایندکس و کیفیت بازیابی حاصل را با موتور جستوجو و پیکره خود ارزیابی کنید.
MultiVectorMatryoshkaLoss تعبیههای توکن را طوری آموزش میدهد که پس از برش همچنان مفید بمانند. میتوانید آن را با MultiVectorTokenPoolingLoss بپوشانید تا هم برای ابعاد کوچکتر و هم برای بردارهای سند کمتر آموزش دهید و در همان حال از تعبیههای کدگذار در تنظیمات مختلف فشردهسازی دوباره استفاده کنید.
مثال کامل آموزش را امتحان کنید، بودجهای را انتخاب کنید که برای کاربرد شما اهمیت دارد و آن را با یک اجرای همتراز با زیان معمولی مقایسه کنید. اسکریپت ارزیابی همراه، بازیابی بدون تجمیع، سقفهای ۶۴، ۳۲، ۱۶، ۸ و ۴ بردار و pool_factorهای ۲ تا ۶ را میسنجد تا بتوانید تعادل کیفیت و ذخیرهسازی را برای مدل خودتان ترسیم کنید.
با چند خط اضافه در هدف آموزش، نمایش کوچکتر سند به چیزی تبدیل میشود که مدل فعالانه یاد میگیرد از آن استفاده کند. این کار فضای قابل توجهی برای عملیتر کردن بازیابی چندبرداری باز میکند!
منابع
Stefan Josef. Learn to Pool: Lightweight Fine-Tuning for Flexible Multi-Vector Compression .
Benjamin Clavié، Antoine Chaffin و Griffin Adams. Reducing the Footprint of Multi-Vector Retrieval with Minimal Performance Impact via Token Pooling .
Antoine Chaffin. After the party comes the free lunch: regularizing ColBERT models to enhance pooling capabilities and reduce index footprint .
Luyu Gao، Yunyi Zhang، Jiawei Han و Jamie Callan. Scaling Deep Contrastive Learning Batch Size under Memory Limited Setup .
Introduction to Matryoshka Embedding Models .
کد و مدلها
مثال آموزش آگاه از تجمیع توکن و README
اسکریپت کامل آموزش
اسکریپت ارزیابی NanoBEIR
نقاط بررسی نمونه: tomaarsen/mve-ModernBERT-base-token-pooling tomaarsen/mve-ModernBERT-base-token-pooling-baseline
مدلهای چندبرداری از پیش آموزشدیده سازگار با Sentence Transformers
آموزش آگاه از ماتریوشکا برای مدلهای چندبرداری
Fast-PLAID