اگر مدلها را روی مک خود اجرا میکنید یا از MPS بهعنوان ابزار اصلی شتابدهی محاسبات استفاده میکنید، در PyTorch 2.15 چیزهای زیادی برای انتظار دارید! FP8 به MPS میآید، رمزگشایی مدلهای زبانی مسیرهای سریعتری از میان لایههای خطی و softmax پیدا میکند و کرنلهای تازهٔ Metal به بخشهایی از بارهای کاری صدا، ویدیو و آموزش میپردازند که بهطور غافلگیرکنندهای پرهزینهاند.
چند کلمه دربارهٔ اینکه ما کی هستیم: ما تیم PyTorch در Hugging Face هستیم. در سراسر PyTorch مشارکت میکنیم و یکی از حوزههای تمرکزمان بکاند MPS است؛ هدف این است که مک شما به محیطی درجهیک برای اجرا و آموزش مدلهای PyTorch تبدیل شود. در آغاز سال ۲۰۲۶، اجرای حتی مدلهای کوچک روی MPS اغلب به معنای دور زدن عملیات پشتیبانینشده، افتهای شدید کارایی و رشد غیرمنتظرهٔ حافظه بود. بنابراین ما مدلهای واقعی را از Hugging Face Hub در حوزههای زبان، تصویر و ویدیو اجرا میکنیم، نقاط ضعف MPS را پیدا میکنیم و آنها را در بالادست PyTorch برطرف میکنیم؛ روزبهروز بیشتر هم با جایگزینکردن MPSGraph با کرنلهای اختصاصی Metal. بخش زیادی از این مطلب حاصل همین کار است که همراه با نگهدارندگان PyTorch و مشارکتکنندگان جامعه انجام شده.
خلاصهٔ مطلب
FP8 به مک میآید: مقادیر float8_e4m3fn را در نصف فضای BF16 ذخیره کنید و از ضرب ماتریسی مقیاسشده و همهٔ عملیات دیگری که روی CUDA/CPU پشتیبانی میشوند استفاده کنید!
مدلهای MoE ۵ تا ۶٫۵ برابر سریعتر از 2.14 رمزگشایی میشوند: Qwen3.6-35B-A3B روی یک M3 Ultra از ۹٫۴ به ۶۱٫۳ توکن بر ثانیه میرسد؛ به لطف یک ضرب ماتریسی گروهبندیشدهٔ بومی با مسیر رمزگشایی اختصاصی، همگامسازیهای کمتر میان GPU و CPU و مسیریابی top-k سریعتر.
زمان کمتر برای هر توکن در همهٔ مدلهای زبانی: لایههای خطی تکردیفی از کرنلهای تخصصی ضرب ماتریس-بردار استفاده میکنند و softmax روی واژگان حدود ۸ برابر سریعتر شده است.
جبر خطی بیشتر روی GPU: تجزیهٔ LU و حل مثلثی برای اعداد مختلط، معکوسگیری سریعتر ماتریسهای کوچک و تجزیهٔ QR سریعتر.
صدا، ویدیو و آموزش هم سهم خود را میگیرند: مسیرهای سریعتر برای کانولوشنها، padding، dropout، پسانتشار درونیابی و کاهشها. اوج حافظهٔ رمزگشایی VAE ویدیویی Wan2.2 اکنون ۸ گیبیبایت است، نه ۲۷۰ گیبیبایت.
کنترل بیشتر از پایتون: استریمهای عمومی MPS و زمانبندی رویداد قابلاتکاتر.
پیشنیازهای بهروزشده: MPS اکنون به macOS 15 یا جدیدتر نیاز دارد؛ PyTorch 2.15 به پایتون 3.11 یا جدیدتر نیاز دارد.
نگاهی به 2.16: توجه کاملاً روی Metal، انتقالهای بیشتر از MPSGraph به Metal و رمزگشایی سریعتر مدلهای زبانی.
این تغییرات برای شما چه معنایی دارد
اگر مدلها را روی مک با transformers، diffusers یا ابزارهایی مثل ComfyUI اجرا میکنید، 2.15 در عمل این تغییرات را به همراه دارد:
مدلهای زبانی محلی بسیار سریعتر. مدلهای ترکیب خبرگان ۵ تا ۶٫۵ برابر سریعتر از 2.14 رمزگشایی میشوند: روی یک M3 Ultra با torch.compile، مدل Qwen3.6-35B-A3B از ۹٫۴ به ۶۱٫۳ توکن بر ثانیه و LFM2.5-8B-A1B از ۲۳٫۶ به ۱۲۳٫۶ توکن بر ثانیه میرسد. مدلهای متراکم هم از لایههای خطی سریعتر و softmax حدود ۸ برابر سریعتر برای نمونهگیری سود میبرند. (بیشتر)
تولید ویدیویی که در حافظه جا میشود. رمزگشایی یک ویدیو با VAE کاشیای Wan2.2 پیشتر حافظهٔ درایور را تا ۲۷۰ گیبیبایت بالا میبرد؛ اکنون اوج آن حدود ۸ گیبیبایت است. (بیشتر)
ویرایش درست تصویر با Qwen-Image-2.1. در 2.14، رمزگذار VAE مدل Qwen-Image-2.1 روی MPS بیسروصدا تصاویر را خراب میکرد و جریانهای کاری ویرایش تصویر را از کار میانداخت (این مشکل در ComfyUI گزارش شده بود). همان تغییر padding آن را برطرف میکند: تطابق رفتوبرگشت رمزگذاری-رمزگشایی اکنون با PSNR برابر ۲۹٫۹۵ دسیبل با CPU مطابقت دارد، در حالی که پیشتر ۱۰٫۰۶ دسیبل بود.
وزنهای FP8 روی مک شما. تانسورهای FP8 نصف حافظهٔ BF16 را میگیرند و F.scaled_mm آنها را مستقیماً روی GPU ضرب میکند. (بیشتر)
فهرست مطالب
شروع کار
FP8 به MPS میآید
رمزگشایی سریعتر مدلهای زبانی
جبر خطی تقویت میشود
کانولوشنها، padding و آموزش
softmax و کاهشها
ردپای حافظهٔ بسیار کوچکتر برای رمزگشایی ویدیو
کنترل بیشتر با استریمهای MPS
عملیات بیشتری روی MPS کار میکنند
نگاهی اجمالی به PyTorch 2.16
جمعبندی
شروع کار
به یک مک با تراشهٔ Apple silicon، macOS 15 یا جدیدتر و پایتون 3.11 یا جدیدتر نیاز دارید (ماتریس سازگاری 2.15 را ببینید). اگر سیستمعامل شما قدیمیتر باشد یا GPU سازگار با Metal در دسترس نباشد، بررسی دسترسپذیری MPS اکنون دلیل آن را به شما میگوید.
برای آزمودن نسخهٔ کاندید انتشار در یک محیط جداگانه:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpuFP8 به MPS میآید
FP8 راه دیگری برای صرفهجویی در حافظه روی مک شما فراهم میکند. PyTorch 2.15 تانسورهای torch.float8_e4m3fn را روی MPS اضافه میکند: هر مقدار یک بایت، یعنی نصف فضای FP16 یا BF16.
میتوانید این تانسورها را با F.scaled_mm ضرب کنید که هم مقیاسبندی تانسیوری و هم ردیفی را پشتیبانی میکند. این یک مثال کوچک با یک مقیاس برای هر تانسور است:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
رمزگشایی سریعتر مدلهای زبانی
هر مدل زبانی یک فاز پیشپرکردن و یک فاز رمزگشایی دارد. در رمزگشایی، هر توکن تازه بهصورت یک ردیف واحد از مدل عبور میکند، بنابراین ضربهای ماتریسی بزرگ به ضرب ماتریس-بردار تبدیل میشوند. PyTorch 2.15 هر دو نوع لایهای را که بر این مرحله غالباند سریعتر میکند: لایههای خطی متراکم و لایههای ترکیب خبرگان.
لایههای خطی
MPS از نسخهٔ 2.14 کرنلهای GEMV را برای torch.mm داشته است، اما F.linear همچنان از MPSGraph عبور میکرد. PyTorch 2.15 آنها را به F.linear متصل میکند، بنابراین ورودی رایج رمزگشایی با شکل [1, 1, hidden_size] مستقیماً از آنها استفاده میکند و جمعهای بایاس واجد شرایط هم در آن ادغام میشوند. در ۹۶ شکل لایهٔ BF16 از مدلهای واقعی، این به میانگین هندسی ۱٫۲۳ برابر سرعت بیشتر میانجامد. بزرگترین بردها به تصویرهای کوچک میرسد، مانند گیتها در مدلهای MoE، جایی که مسیر قدیمی بیشتر پهنای باند حافظه را بیاستفاده میگذاشت. لایههای بزرگ و سرهای LM از قبل نزدیک به محدودیت پهنای باند بودند، بنابراین نزدیک به ۱ برابر میمانند.
لایههای ترکیب خبرگان
یک لایهٔ ترکیب خبرگان تعداد متفاوتی توکن به هر خبره میفرستد. ضرب ماتریسی گروهبندیشده این گروههای نابرابر را در یک عملیات واحد مدیریت میکند و 2.15 پیادهسازی بومی آن را به MPS میدهد.
در 2.14، ضرب ماتریسی گروهبندیشده آفستهای گروه را به CPU کپی میکرد و روی گروهها حلقه میزد. کرنلهای تازهٔ Metal آفستها را مستقیماً روی GPU میخوانند و در جایی که در دسترس باشد از Metal Performance Primitives و در جاهای دیگر از یک مسیر جداگانهٔ Metal استفاده میکنند. گروههای کوچک، که حالت رایج در رمزگشاییاند، کرنل اختصاصی خود را هم دارند.
برای نمونه، ۶۴ توکن میتواند به گروههای ۱۶، ۳۲ و ۱۶ تقسیم شود:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
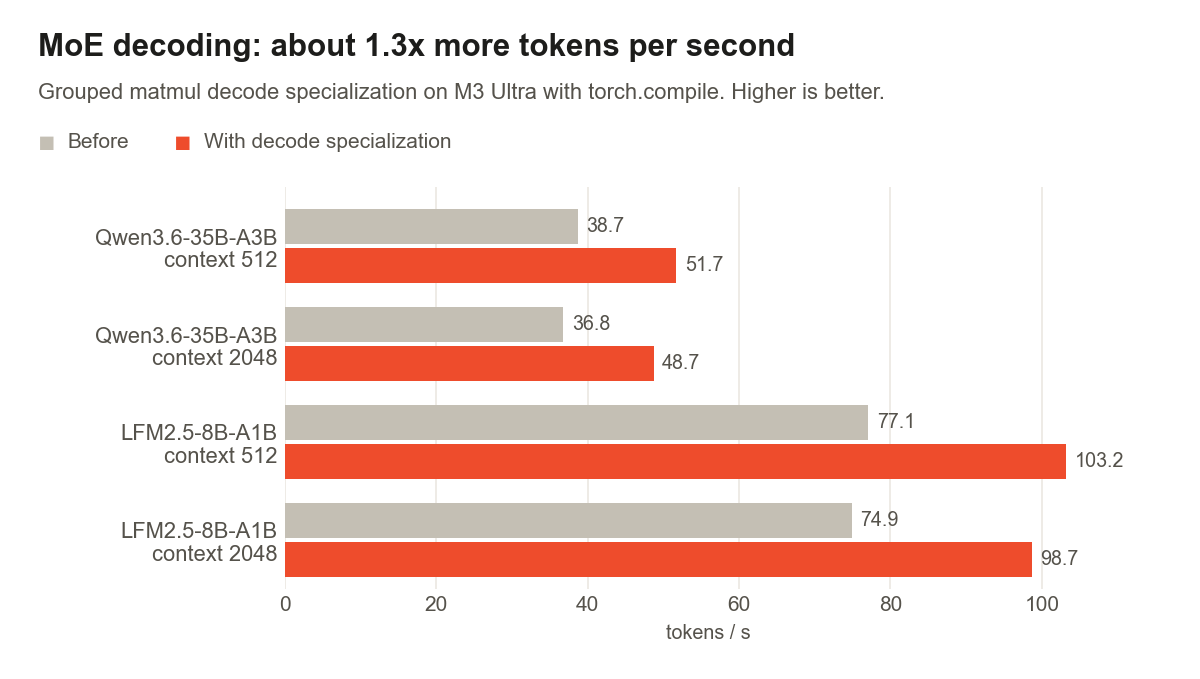
کرنل رمزگشایی مستقیماً در توان عملیاتی توکن دیده میشود. روی یک M3 Ultra با torch.compile، مدلهای MoE حدود ۱٫۳ برابر توکن بیشتری در ثانیه تولید میکنند:
جبر خطی تقویت میشود
محاسبات با اعداد مختلط
کار با تانسورهای مختلط آسانتر میشود. تجزیهٔ LU، حل LU و حل مثلثی برای complex64 اکنون روی MPS اجرا میشوند و این عملیات و گرادیانهای ساختهشده بر پایهٔ آنها، مانند دترمینانهای مختلط، را هم فعال میکند. این یک دستگاه کوچک است که مستقیماً روی GPU حل میشود:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())ماتریسهای کوچک و حلهای بزرگتر
ماتریسهای کوچک هم کرنلهای سریع میگیرند. برای هندسهٔ دوربین و تبدیلهای تصویر، دستههایی از ماتریسهای FP32 تا ابعاد ۴×۴ در یک کرنل واحد Metal معکوس میشوند که تجزیه و حل را با هم ترکیب میکند. مسائل بزرگتر هم سهم خود را میگیرند: QR از بهروزرسانی بلوکی استفاده میکند و حلهای مثلثی بخش زیادی از کار خود را به ضرب ماتریسی کارآمد تبدیل میکنند.
بارهای کاری Gated DeltaNet یک مسیر سریع اختصاصی برای دستههایی از دستگاههای مثلثی FP32 با ابعاد ۱۶×۱۶، ۳۲×۳۲ و ۶۴×۶۴ و دستکم هشت طرف راست میگیرند.
SVD هم در مقادیر عددی حدی پایدارتر شده است. اکنون مقادیر تکین بسیار کوچک، بزرگی ورودی بسیار بزرگ یا بسیار کوچک و تکمیل پایه با full_matrices=True را بهدرستی مدیریت میکند و در نتیجه شبهمعکوس و نتایج کمترین مربعات را قابلاتکاتر میکند.
کانولوشنها، padding و آموزش
مدلهای صوتی، رمزگشاهای ویدیویی و حلقههای آموزش عملیات پرهزینهٔ خود را دارند. این انتشار چند مورد از آنها را مسیرهای تازهای از طریق Metal میدهد:
عملیات | تغییر در 2.15
پیشروی conv1d | کرنلهای تخصصی جای MPSGraph را میگیرند، بههمراه یک مسیر im2col بههمراه ضرب ماتریسی برای خروجیهای کوتاه. برای شکلهای صوتی و مدلهای استریم مفید است.
padding ثابت | به کرنلهای Metal منتقل میشود و رشد مهارنشدنی حافظهٔ درایور را در رمزگشایی VAE ویدیویی کاشیای برطرف میکند (بیشتر در ادامه).
padding بازتابی و تکرار | پیادهسازیهای تازهٔ Metal که سریعترند و درستی پسانتشار را برطرف میکنند.
dropout خارج از جا | nn.Dropout و F.dropout اکنون از کرنل ادغامشدهٔ موجود استفاده میکنند.
پسانتشار بالابردن نمونه | یک کرنل gather در Metal جای مسیر گرادیان تغییر اندازهٔ MPSGraph را میگیرد.
پسانتشار conv2d با channels-last | روی یک مسیر کارآمد channels-last میماند، نه یک گراف NCHW با دسترسی پرهزینهٔ strided.
softmax و کاهشها
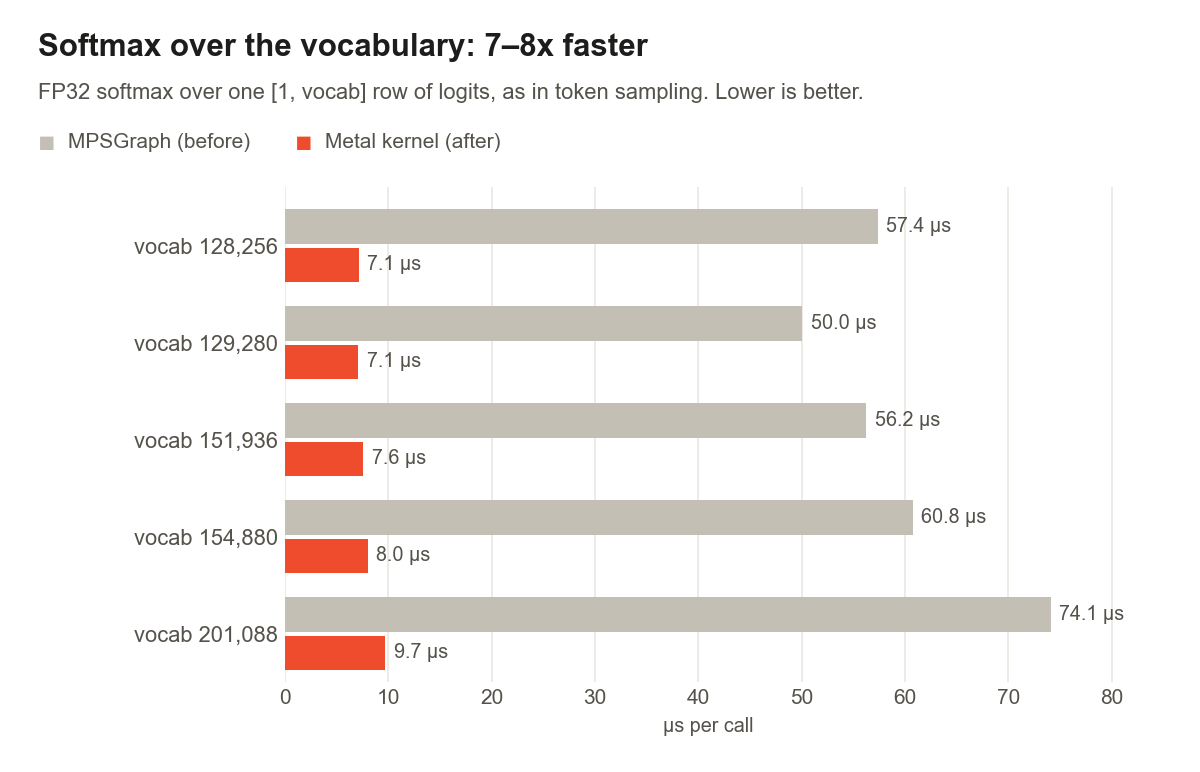
نمونهگیری توکن هم در 2.15 سریعتر میشود. softmax و log_softmax اکنون روی کرنلهای اختصاصی Metal اجرا میشوند و واژگان بزرگ بیشترین سود را میبرند: یک softmax FP32 روی یک ردیف [1, 128256] از لاجیتها از ۵۷ میکروثانیه به ۷ میکروثانیه کاهش مییابد، حدود ۸ برابر سریعتر از نسخهٔ MPSGraph. این سرعت بیشتر در دیگر اندازههای رایج واژگان هم حفظ میشود:
ردپای حافظهٔ بسیار کوچکتر برای رمزگشایی ویدیو
یکی از چشمگیرترین نتایج این انتشار از تغییر padding ثابت میآید. رمزگشایی VAE در Wan-AI/Wan2.2-TI2V-5B-Diffusers در یک رمزگشایی کامل ۲۸ کاشی، ۸٬۷۶۴ فراخوانی padding انجام میدهد. با padding روی Metal، اوج حافظهٔ درایور از حدود ۲۷۰ گیبیبایت به ۸ گیبیبایت کاهش مییابد:
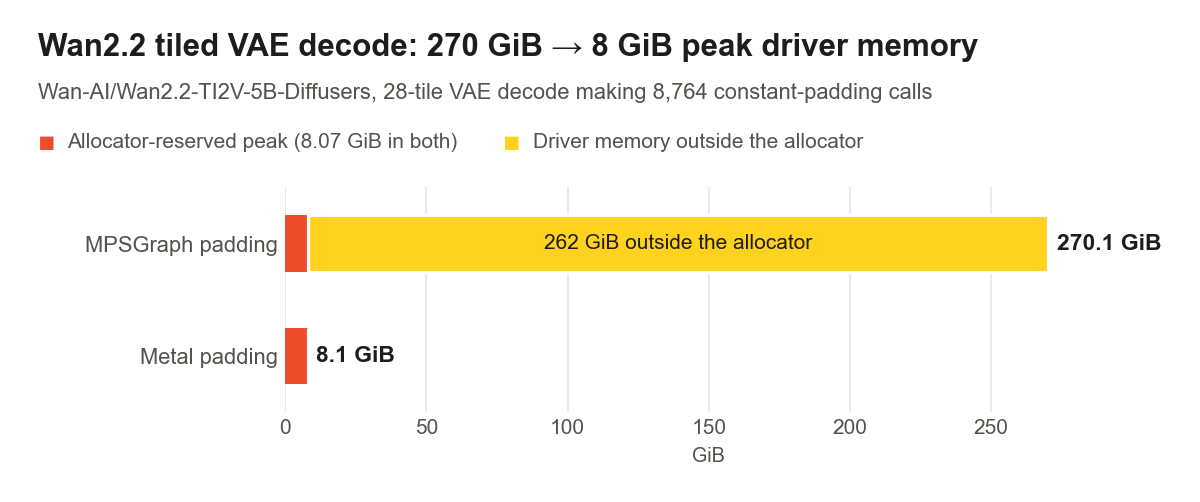
شاخص حافظه | padding با MPSGraph | padding با Metal
اوج فعلی تخصیص تانسور | ۴٫۴۲۲ گیبیبایت | ۴٫۰۹۵ گیبیبایت
اوج رزروشده توسط تخصیصدهنده | ۸٫۰۷۰ گیبیبایت | ۸٫۰۷۰ گیبیبایت
اوج کل حافظهٔ درایور | ۲۷۰٫۱۳۵ گیبیبایت | ۸٫۱۰۸ گیبیبایت
کنترل بیشتر با استریمهای MPS
اکنون میتوانید مستقیماً از پایتون انتخاب کنید کدام استریم MPS کار شما را اجرا کند. torch.mps.Stream و مدیر زمینهٔ torch.mps.stream این رابط را فراهم میکنند و Tensor.record_stream به تخصیصدهنده اجازه میدهد استفادهٔ یک تانسور در استریم دیگر را ردیابی کند.
این یک مثال کوچک است که کار را به یک استریم جداگانه میفرستد و پیش از خواندن نتیجه همگامسازی میکند:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
عملیات بیشتری روی MPS کار میکنند
چند عملیات دیگر هم اکنون روی MPS اجرا میشوند: torch.frexp، torch.logspace، torch.take و Tensor.put_، torch.heaviside، torch.special.laguerre_polynomial_l و مقایسههای اعداد صحیح بدون علامت. logspace هنوز خروجیهای صحیح یا بولی با بیش از یک عضو را پشتیبانی نمیکند.
توجه هم اصلاح درستی میگیرد: پیادهسازی ریاضی MPS برای توجه ضرب داخلی مقیاسشده اکنون پخش دسته و سر را بهدرستی مدیریت میکند.
نگاهی اجمالی به PyTorch 2.16
کار روی 2.16 از قبل بهخوبی پیش رفته است. برخی از تغییرات زیر روی شاخهٔ main اعمال شده و در نسخههای شبانه در دسترس است؛ برخی دیگر هنوز در حال بازبینیاند، بنابراین جزئیاتشان ممکن است پیش از انتشار تغییر کند.
رمزگشایی سریعتر مدلهای زبانی
وقتی مسیر رمزگشایی یک مدل دیگر هیچ عملیات MPSGraph نداشته باشد، GPU تنها پس از آنکه CPU رمزگذاری همهٔ کرنلهای آن را تمام کرد، کار روی یک توکن را آغاز میکند. PyTorch 2.16 بافر فرمان را هر ۱۶ کرنل یکبار ثبت میکند، بنابراین GPU در حالی که CPU هنوز بقیه را رمزگذاری میکند کار خود را شروع میکند. برای رمزگشایی کامپایلشدهٔ BF16 در زمینهٔ ۲۰۴۸ توکن:
مدل | پیش از تغییر | پس از تغییر | تغییر
LFM2.5-8B-A1B | ۱۰۸٫۸ توکن بر ثانیه | ۱۲۶٫۰ توکن بر ثانیه | +۱۶٪
Qwen3.6-35B-A3B | ۵۲٫۹ توکن بر ثانیه | ۶۲٫۸ توکن بر ثانیه | +۱۹٪
Qwen3.8-27B | ۱۲٫۱ توکن بر ثانیه | ۱۲٫۶ توکن بر ثانیه | +۴٪
توجه کاملاً روی Metal اجرا میشود
توجه ضرب داخلی مقیاسشده بهکلی از MPSGraph دست میکشد: هر شکلی روی کرنلهای Metal اجرا خواهد شد، با کرنلهای برداری اختصاصی برای رمزگشایی و Metal Performance Primitives برای پیشپرکردن نیمدقت روی نسخههای جدیدتر macOS. شکلهایی که پیشتر به MPSGraph بازمیگشتند بیشترین سود را میبرند. روی یک M5 Pro، رمزگشایی با توجه پرسوجوی گروهی (۳۲ سر پرسوجو، ۸ سر KV، بُعد سر ۸۰، زمینهٔ ۴K) از ۴۶۵ میکروثانیه به ۶۵ میکروثانیه کاهش مییابد و یک پیشپرکردن ۴K×۴K با بُعد سر ۴۰ از ۴۲ میلیثانیه به ۶ میلیثانیه میرسد.
انتقالهای بیشتر از MPSGraph به Metal
دورشدن از MPSGraph ادامه دارد. پیشروی و پسانتشار batch norm در جریان است، در حالی که MSE loss (تا ۱۲ برابر سریعتر روی ورودیهای کوچک)، std_mean و var_mean (تا ۴ برابر سریعتر) و bincount از قبل اعمال شدهاند. bincount چشمگیرترین است: وقتی بیشتر مقادیر در یک سبد واحد میافتند، شمارش ۴ میلیون عدد صحیح پیشتر ۶٫۸ ثانیه طول میکشید و اکنون نیم میلیثانیه طول میکشد.
نصب کوچکتر
شیدرهای همراه بهطور پیشفرض برای Metal 3.1 ساخته میشوند و نسخههای Metal 4 فقط برای کرنلهایی کامپایل میشوند که به آن نیاز دارند. این کار libtorch_cpu.dylib را حدود ۲۵٪ کوچکتر میکند، از ۳۸۴ مبیبایت به ۲۸۷ مبیبایت، و زمینه را برای شیدرهای Metal 4.1 با ضربهای ماتریسی سریعتر و ضرب ماتریسی بومی FP8 فراهم میکند.
جمعبندی
PyTorch 2.15 FP8 را به مک میآورد، رمزگشایی مدلهای زبانی را برای مدلهای متراکم و MoE سریعتر میکند، جبر خطی بیشتری را روی GPU میآورد و فهرست بلندی از عملیات را از MPSGraph به کرنلهای اختصاصی Metal منتقل میکند. نسخهٔ کاندید انتشار را امتحان کنید!
قدم بعدی ما
MPS بیشتر: 2.16 توجه را کاملاً روی Metal اجرا خواهد کرد و ما به انتقال عملیات از MPSGraph ادامه میدهیم.
torch.compile: ما در حال کار روی حذف شکستهای گراف هستیم تا مدلهای بیشتری بهطور کامل کامپایل شوند.
ایدههای شما: در PyTorch روی چه چیز دیگری کار کنیم؟ اگر چیزی کند است، وجود ندارد یا خراب است، روی MPS یا هر جای دیگر، یک issue در GitHub باز کنید و به ما بگویید.
تشکر فراوان از Nikita Shulga، Kurt Mohler و Aaron Gokaslan که بخش زیادی از این کار را بازبینی کردند و از همهٔ کسانی که در این انتشار به MPS کمک کردند.