بسیاری از فعالان یادگیری ماشین شهود نسبی دارند که چطور مدلها را سریع اجرا کنند، اما تعداد کمتری میدانند چطور تحلیل کنند که چرا یک مدل کند است. در بخش اول این مجموعه، یاد میگیرید چطور عملکرد استنتاج را بهصورت نظاممند تحلیل کنید و مشخص کنید زمان کجا صرف میشود.
این مطلب از صفر شروع میشود و هیچ تجربهٔ قبلی در پروفایلگیری لازم نیست. در این مسیر از AWS Trainium استفاده میکنیم؛ تراشهای که بهطور اختصاصی برای آموزش و استنتاج یادگیری عمیق ساخته شده است، و از TorchNeuron (torch_neuronx) که بکاند متنباز و بومی PyTorch برای همین تراشه است. TorchNeuron از جریانهای کاری استاندارد PyTorch روی Trainium پشتیبانی میکند؛ از جمله اجرای eager، torch.compile و APIهای استاندارد PyTorch، با تغییرات حداقلی در کد. علاوه بر این، TorchNeuron با Neuron Kernel Interface (NKI) یکپارچه میشود تا اپراتورهای سفارشی و بهینهسازی عملکرد برای سختافزار Trainium ممکن شود. در پایان این مطلب باید بدانید:
چطور torch.profiler را با بکاند Neuron پیکربندی کنید و یک رد (trace) تمیز ثبت کنید.
چطور جدول key_averages() را بخوانید تا مشخص کنید کدام عملیات زمان دستگاه Neuron را مصرف میکنند و زمان CPU خودِ هر عمل را با هم مقایسه کنید.
چطور یک عملیات را در Neuron Explorer دنبال کنید؛ از ارسال از سوی فریمورک، به زمانبندی در زمان اجرا و سپس اجرا روی سختافزار یک NeuronCore.
این نشانهها چطور میان سه پیادهسازی از یک عملیات یکسان تغییر میکنند.
Neuron بهعنوان بکاند PyTorch
پیش از پروفایلگیری یک بار کاری، بهتر است بدانید Neuron چطور با PyTorch یکپارچه میشود.
بکاند Neuron از نقطهٔ توسعهٔ PrivateUse1 در PyTorch استفاده میکند. این سازوکار به یک شتابدهنده اجازه میدهد بدون افزودن کلید dispatch اختصاصی مانند cuda با فریمورک یکپارچه شود. بستهٔ torch_neuronx همراه با PyTorch بالادستی، Neuron را بهعنوان بکاند بومی برای کد PyTorch ثبت میکند. برای جزئیات این سازوکار توسعه، مطلب Facilitating New Backend Integration by PrivateUse1 را ببینید.
راهاندازی پروفایلر
برای پروفایلگیری یک بار کاری Neuron از دو شیء استفاده میکنید:
NeuronConfig تعیین میکند کدام جریانهای داده و کدام NeuronCoreها ثبت شوند و خروجی کجا نوشته شود. آن را بهعنوان experimental_config به torch.profiler.profile میدهید.
NeuronProfiler یک NeuronConfig میگیرد و callbackای به نام export_trace ارائه میدهد. این callback رد فریمورک، یعنی trace.json، را در کنار ردهای سیستم Neuron مینویسد.
nc = NeuronConfig(
    modes=[ProfileMode.DEVICE, ProfileMode.RUNTIME],
    profile_output_dir=OUTPUT_DIR,
    capture_enabled_for_nc='0',
    correlate_device_time=True,
)
exporter = NeuronProfiler(nc)
پارامتر modes جریانهای دادهای را انتخاب میکند که ثبت شوند، مانند دستورهای دستگاه و ردهای زمان اجرا. پارامتر capture_enabled_for_nc تعیین میکند کدام NeuronCoreها ردیابی شوند. تنظیم correlate_device_time=True زمان دستگاه را از رد به جدول key_averages() منتقل میکند تا بتوانید زمان CPU و زمان دستگاه Neuron را مقایسه کنید. برای مرجع کامل پارامترها و مقادیر موجود ProfileMode، مستندات NeuronConfig Profile Modes را ببینید.
ابزار: Neuron Explorer
Neuron Explorer یک نمایشگر مرورگری برای رد سیستم، خط زمانی دستگاه و تفکیک هر موتور است. میتوانید از طریق تونل SSH یا افزونهٔ Visual Studio Code به آن دسترسی داشته باشید. در این مطلب از Explorer استفاده میکنیم تا آنچه را key_averages() بهصورت عددی گزارش میدهد تأیید کنیم و ببینیم میان ارسالها چه اتفاقی میافتد.
پس از پروفایلگیری، پوشهٔ خروجی شامل رد سیستم است و اگر دادهٔ دستگاه را ثبت کرده باشید، فایلهای جفتشدهٔ .neff و .ntff را هم در بر میگیرد. فایل Neuron Executable File Format (NEFF) اجرایی کامپایلشدهٔ Neuron را نگه میدارد و NTFF متناظر آن، رد دستورهای سختافزاری را. این دو فایل یک هش عددی مشترک دارند که نشان میدهد یک جفتاند. برای باز کردن پروفایل در Neuron Explorer، در پروفایل سیستمی یا ترکیبی، کل پوشهٔ خروجی را بارگذاری کنید. در پروفایل فقط-دستگاه، فایلهای .neff و .ntff متناظر را جداگانه بارگذاری کنید. برای دستورهای رابط کاربری و خط فرمان، بخش Step 5: Upload your profile را ببینید.
پروفایلگیری RMSNorm
در این تحلیل نخست، RMSNorm را پروفایل میکنیم؛ عملیاتی کوچک با توالی روشنی از عملیات حسابی و کاهشی.
سه پیادهسازی از همین عملیات را پروفایل میکنید:
RMSNorm ساده با عملیات جداگانهٔ PyTorch: ضرب، میانگین، جمع، ریشهٔ دوم معکوس و ضرب.
تابع torch.rms_norm()، تابع داخلی PyTorch که به یک هستهٔ ادغامشدهٔ Neuron تبدیل میشود.
RMSNorm ساده با torch.compile، با همان عملیات پیادهسازی اول.
اسکریپتها از ورودیها، پیکربندی پروفایلر و زمانبندی یکسانی استفاده میکنند تا نتایج مستقیماً قابل مقایسه باشند.
همهٔ اسکریپتهای بازتولید این کار در پوشهٔ نمونههای torch-neuronx در دسترساند.
پروفایل ۱: عملیات سادهٔ PyTorch
ابتدا RMSNorm را با عملیات جداگانهٔ PyTorch مینویسیم. هر خط به یک یا چند عمل ATen نگاشت میشود و میتواند تانسورهای میانی بسازد.
device = torch.device('neuron')

x = torch.randn(4, 512, dtype=torch.bfloat16, device=device)
weight = torch.ones(512, dtype=torch.bfloat16, device=device)

def rms_norm_fn(t):
    x_sq = t * t                                    # square
    mean_sq = x_sq.mean(dim=-1, keepdim=True)       # mean of squares
    rms = torch.rsqrt(mean_sq + 1e-6)               # 1 / sqrt(mean_sq + eps)
    return t * rms * weight                         # normalize + scale
پروفایلر را با دو آرگومان لازم برای بکاند Neuron فراخوانی کنید:
ProfilerActivity.PrivateUse1 را وارد کنید تا فعالیت دستگاه Neuron جمعآوری شود.
NeuronConfig را بهعنوان experimental_config بدهید تا قابلیتهای مخصوص Neuron در Kineto فعال شود.
زمانبندی با wait=2، warmup=1 و active=1 در چهار فراخوانی prof.step() کار میکند. این کار یک تکرار گرم را ثبت میکند، بدون آنکه سرباز اولیهٔ راهاندازی لحاظ شود.
درون حلقهٔ پروفایلر، torch.neuron.synchronize() را فراخوانی کنید. بدون این همگامسازی، ممکن است پروفایلر پیش از پایان کار دستگاه خروجی بگیرد و ستون زمان Neuron خالی بماند.
with torch.profiler.profile(
    activities=[ProfilerActivity.CPU, ProfilerActivity.PrivateUse1],
    experimental_config=nc,
    record_shapes=False,
    on_trace_ready=exporter.export_trace,
    schedule=torch.profiler.schedule(wait=2, warmup=1, active=1),
) as prof:
    for step in range(4):
        with torch.no_grad():
            _ = rms_norm_fn(x)
        torch.neuron.synchronize()
        prof.step()
پس از پایان پروفایلگیری، جدول key_averages() را بررسی کنید. آن را بر اساس self_privateuse1_time_total مرتب کنید تا عملیاتی که بیشترین هزینهٔ دستگاه را دارند اول بیایند. جدول نمایشدادهشده در اینجا به عملیات RMSNorm که زمان دستگاه Neuron گزارش میکنند محدود شده است. خروجی کامل key_averages() رویدادهای سمت CPU مانند تخصیص حافظه و انتقال میزبانبهدستگاه را نیز در بر میگیرد.
print(prof.key_averages().table(sort_by="self_privateuse1_time_total", row_limit=4))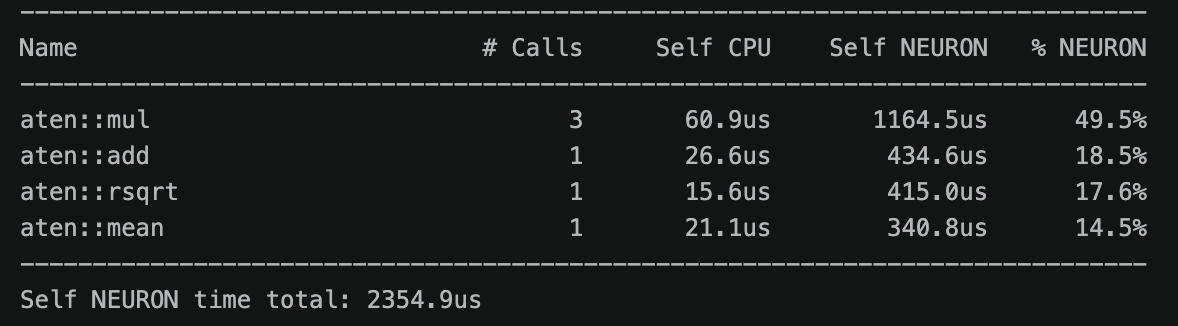
جدول میانگینهای کلیدی نشان میدهد سه فراخوانی aten::mul بیشترین سهم زمان دستگاه Neuron را به خود اختصاص دادهاند.
جدول نشان میدهد کدام عملیات ATen اجرا شدهاند، چند بار اجرا شدهاند و چه مقدار زمان روی CPU و دستگاه Neuron صرف کردهاند. aten::mul بیشترین زمان کل دستگاه را دارد، چون این تابع سه ضرب انجام میدهد.
نام | تعداد فراخوانی | زمان CPU خودِ عمل | زمان NEURON خودِ عمل | درصد NEURON
aten::mul | 3 | 60.9 μs | 1,164.5 μs | 49.5%
aten::add | 1 | 26.6 μs | 434.6 μs | 18.5%
aten::rsqrt | 1 | 15.6 μs | 415.0 μs | 17.6%
aten::mean | 1 | 21.1 μs | 340.8 μs | 14.5%
مجموع زمان NEURON خودِ عمل: 2.355 ms
هر سطر مستقیماً به تابع نگاشت میشود. aten::mul برای x * x، x * rms و ضرب نهایی در weight اجرا میشود. aten::mean آخرین بُعد را کاهش میدهد. aten::add مقدار اپسیلون را اضافه میکند و چون این مقدار اسکالر از CPU میآید، یک کپی میزبانبهدستگاه را راه میاندازد. aten::rsqrt ریشهٔ دوم معکوس را محاسبه میکند.
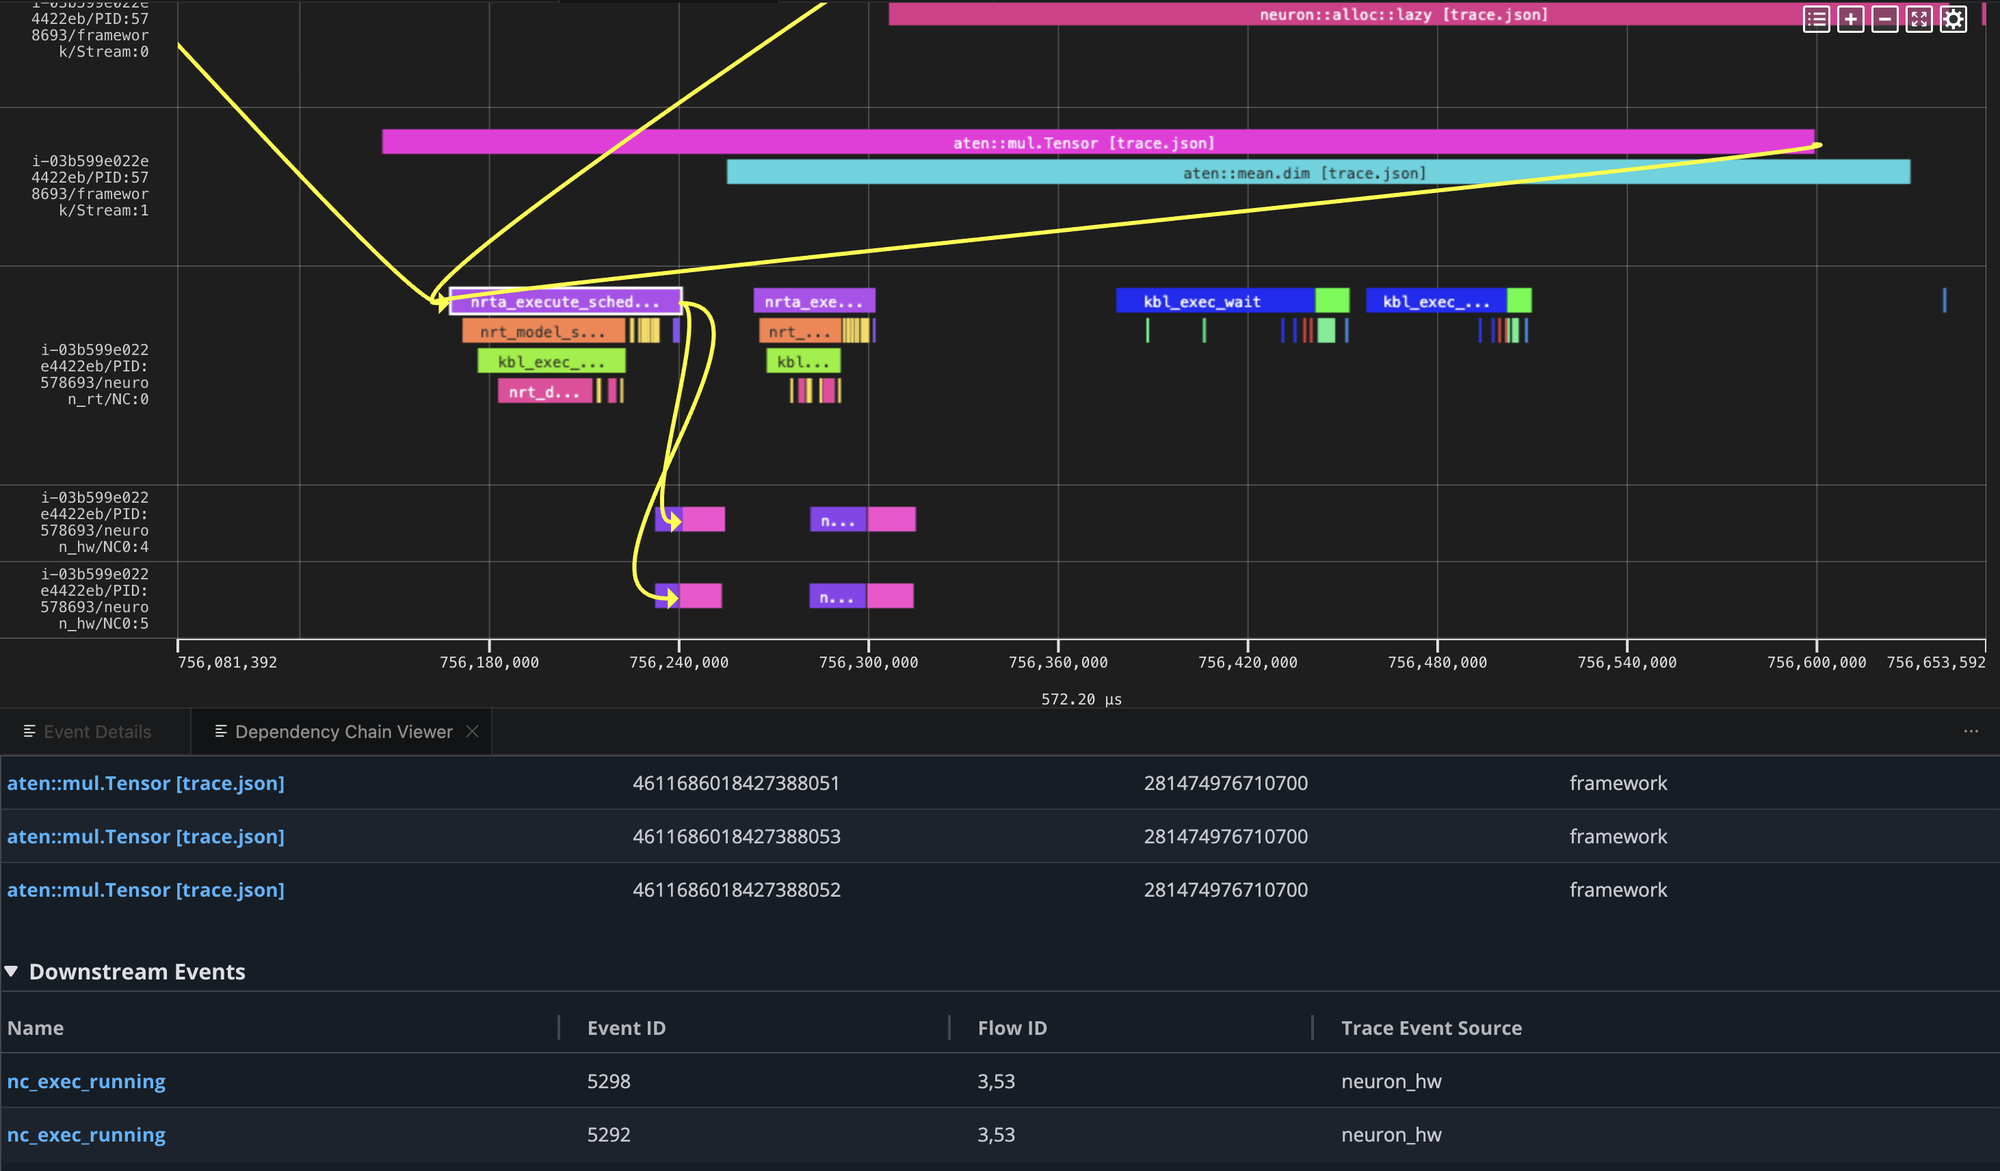
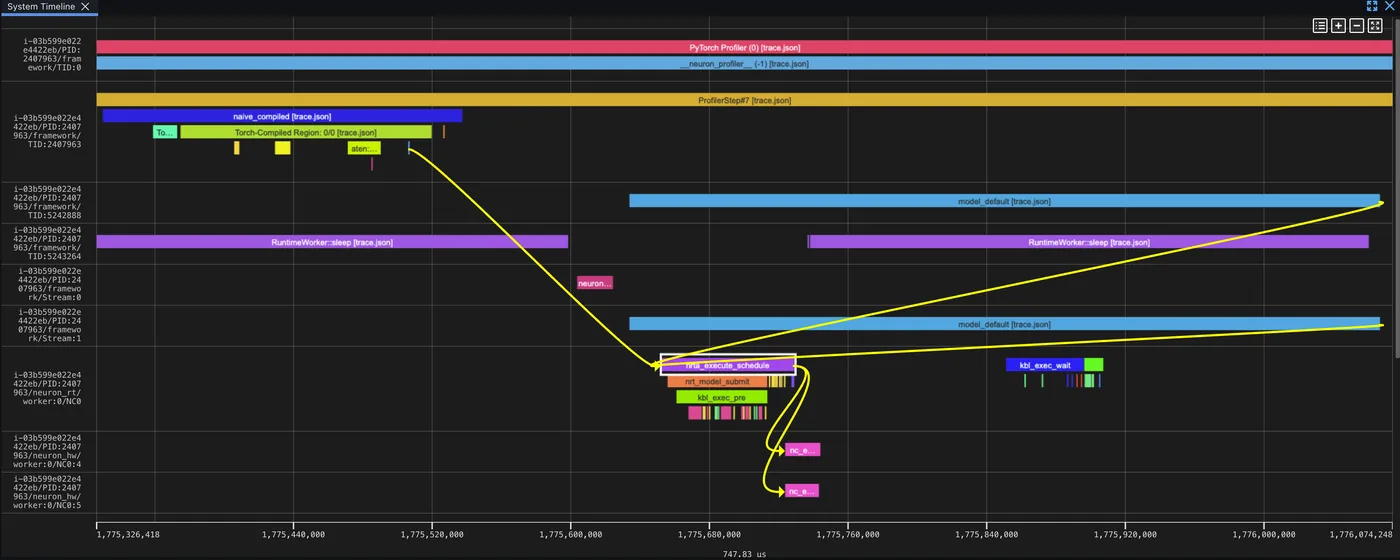
Neuron Explorer یک عمل aten::mul را از ارسال از سوی فریمورک، به زمانبندی در زمان اجرا و سپس اجرا روی مسیرهای سختافزاری Neuron دنبال میکند.
خواندن رد (trace) در Explorer
در Explorer زمان از چپ به راست و چرخهٔ عمر رویداد از بالا به پایین پیش میرود. هر عمل ATen از الگوی یکسانی پیروی میکند: ایجاد در مسیر فریمورک، زمانبندی در مسیر زمان اجرا بهصورت nrta_execute_schedule و اجرا روی دستگاه در مسیر سختافزار بهصورت nc_exec_running.
نمای رد سیستم، رویدادها را در مسیرهای جداگانه سازمان میدهد. در حالت گروهبندی Default، برچسبها از الگوی instance/PID/subsystem/identifier پیروی میکنند:
مسیر | پسوند برچسب | چه چیزی را نشان میدهد
ارسال فریمورک | framework/TID:<id> | رویدادهای ارسال اپراتور (زمان اجرای PrivateUse1)، گروهبندیشده بر اساس شناسهٔ رشته.
دستگاه فریمورک | framework/Stream:<n> | رویدادهای تعامل با دستگاه (درایور PrivateUse1)، گروهبندیشده بر اساس شمارهٔ جریان.
زمان اجرای Neuron | neuron_rt/NC:<n> | فراخوانیهای API زمان اجرای Neuron، گروهبندیشده بر اساس NeuronCore منطقی.
سختافزار Neuron | neuron_hw/NC<n>:<id> | رویدادهای اجرا روی سختافزار، گروهبندیشده بر اساس NeuronCore فیزیکی.
در حالت eager، هر عملیات مستقل اجرا میشود. از نمایشگر زنجیرهٔ وابستگی استفاده کنید تا aten::mul.Tensor را از لایهٔ فریمورک، به زمانبندی در زمان اجرا و سپس اجرا روی دستگاه دنبال کنید.
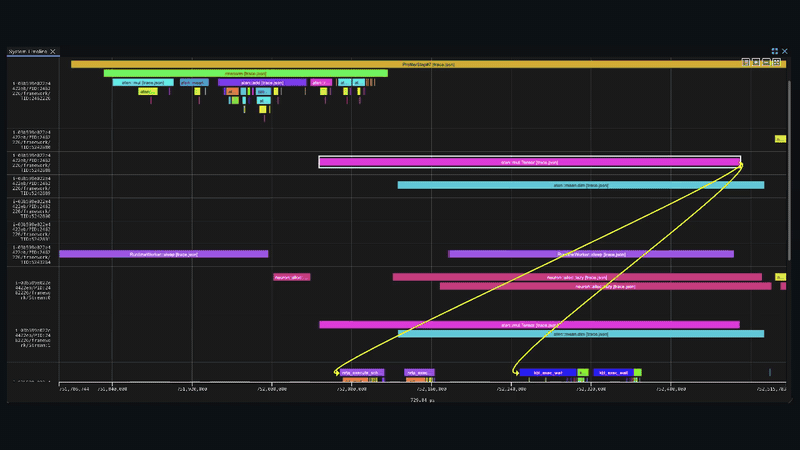
نمایشگر زنجیرهٔ وابستگی چرخهٔ عمر یک عملیات را در مسیرهای فریمورک، زمان اجرا و سختافزار برجسته میکند.
پروفایل ۲: torch.rms_norm
عملیات جداگانه را با تابع داخلی rms_norm در PyTorch جایگزین کنید. Neuron این عملیات را به یک هستهٔ ادغامشده تبدیل میکند:
def rms_norm_fn(t):
    return torch.rms_norm(t, [512], weight)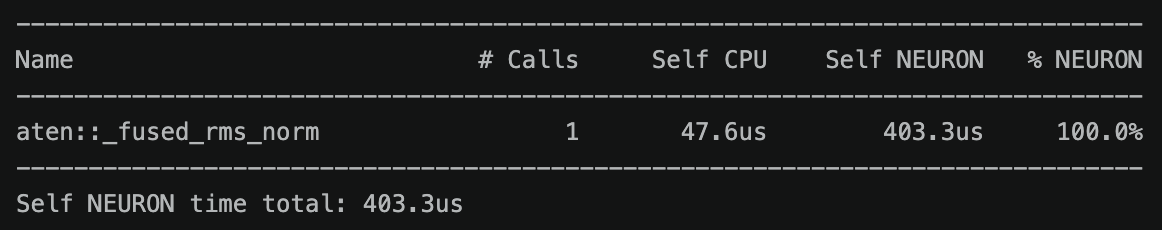
RMSNorm ادغامشده در جدول میانگینهای کلیدی بهصورت یک عمل دستگاه ظاهر میشود.
نام | تعداد فراخوانی | زمان CPU خودِ عمل | زمان NEURON خودِ عمل | درصد NEURON
aten::_fused_rms_norm | 1 | 47.6 μs | 403.3 μs | 100%
مجموع زمان NEURON خودِ عمل: 403.3 μs
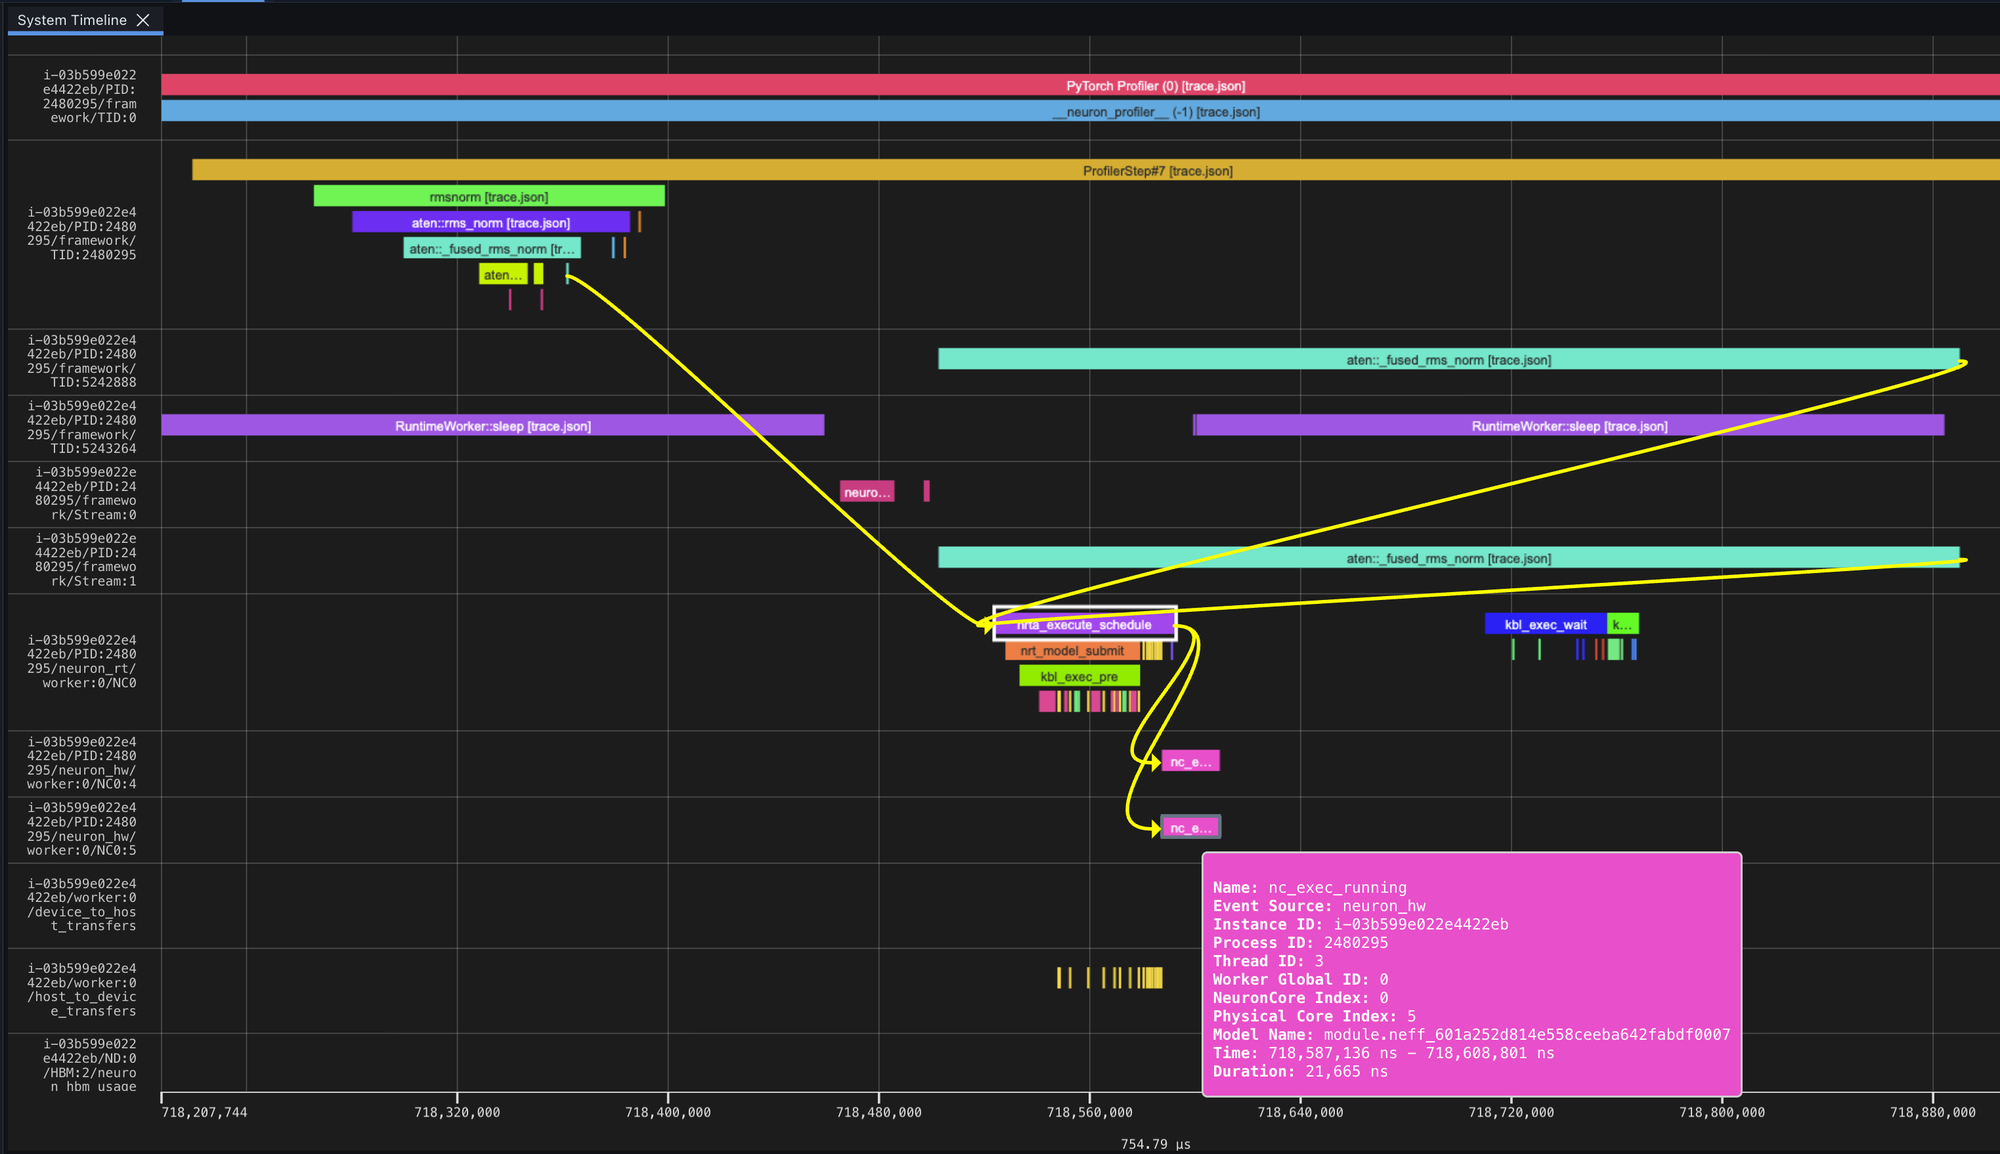
RMSNorm ادغامشده یک مسیر از فریمورک به سختافزار را طی میکند، نه آنکه هر عمل حسابی را جداگانه ارسال کند.
مقایسهٔ مسیر تبدیل به سطح پایینتر
در پیادهسازی ساده، هر عملیات مستقلاً از مرز dispatch عبور میکند و مسیر خودش را از فریمورک به زمان اجرا و سپس سختافزار طی میکند. در پیادهسازی ادغامشده، یک فراخوانی پایتون کل محاسبه را پوشش میدهد. رد شامل یک ارسال و یک رویداد سختافزاری است، بدون فاصله میان عملیات سازنده.
پروفایل ۳: PyTorch ساده با torch.compile
در مثال آخر، تابع RMSNorm سادهٔ اولیه را با torch.compile کامپایل کنید.
با @torch.compile(backend="neuron")، TorchDynamo بایتکد پایتون را بهصورت یک گراف FX ثبت میکند و AOTAutograd آن را به عملیات ATen تبدیل میکند. بکاند Neuron گراف کامل را دریافت میکند، نه آنکه هر عملیات را جداگانه ارسال کند. عملیات را ادغام میکند، دسترسی به حافظه را بهینه میکند و گراف را در یک آرتیفکت NEFF کامپایل میکند. این آرتیفکت بهصورت یک ارسال سختافزاری اجرا میشود.
@torch.compile(backend='neuron', fullgraph=True)
def naive_compiled(t):
    x_sq = t * t
    mean_sq = x_sq.mean(dim=-1, keepdim=True)
    rms = torch.rsqrt(mean_sq + 1e-6)
    return t * rms * weight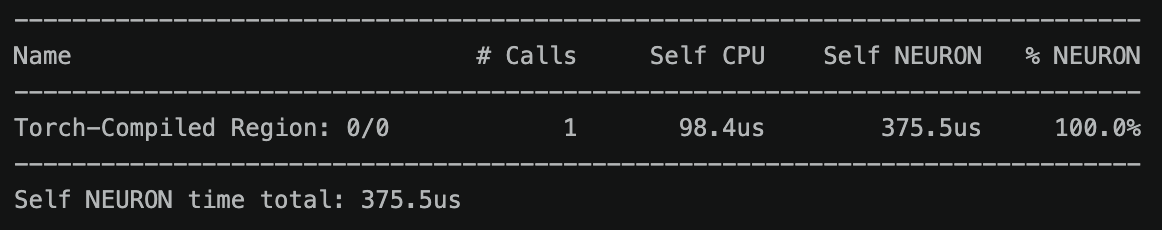
تابع کامپایلشده در جدول میانگینهای کلیدی بهصورت یک Torch-Compiled Region ظاهر میشود.
نام | تعداد فراخوانی | زمان CPU خودِ عمل | زمان NEURON خودِ عمل | درصد NEURON
Torch-Compiled Region: 0/0 | 1 | 98.4 μs | 375.5 μs | 100%
مجموع زمان NEURON خودِ عمل: 375.5 μs
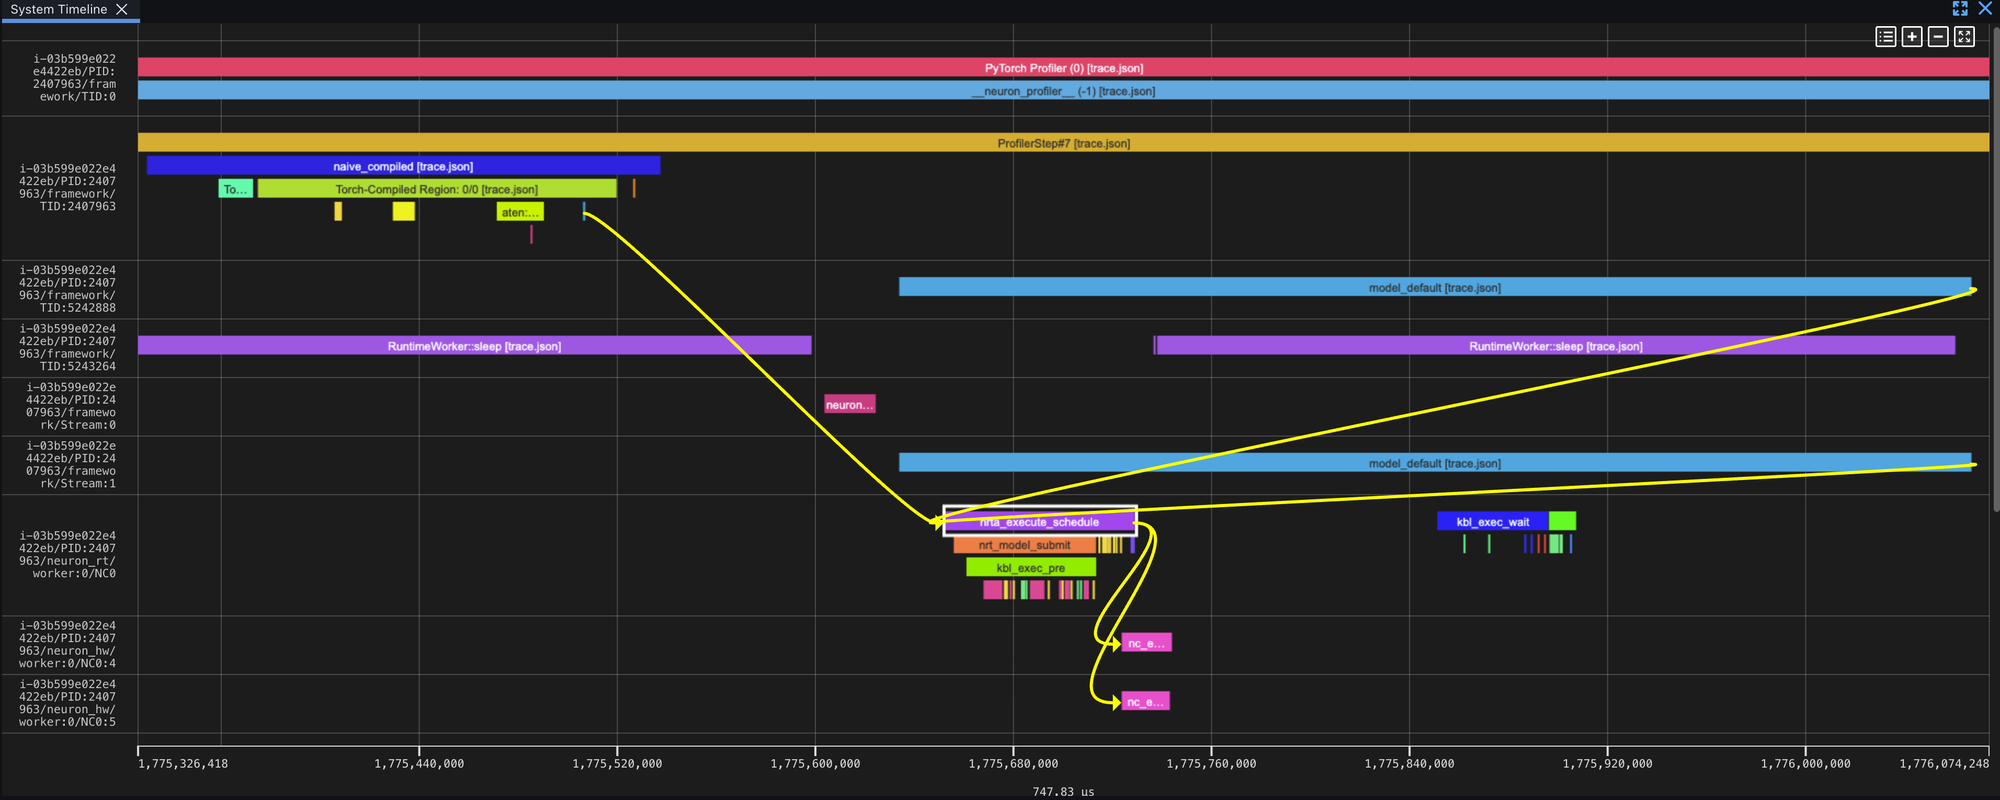
گراف کامپایلشده یک مسیر را از زمانبندی در زمان اجرا و اجرا روی سختافزار طی میکند.
جدول یک اجرای دستگاه را نشان میدهد، مانند پروفایل ۲، اما کد مسیر متفاوتی را طی میکند. بهجای فراخوانی یک عملیات ادغامشدهٔ اختصاصی، کامپایلر خودِ ادغام را از تابع پایتون اولیه کشف میکند. در این اجرا، زمان Neuron با torch.rms_norm قابلمقایسه است: 375 μs در برابر 403 μs.
خلاصهٔ مقایسهٔ کنار هم
گونه | زمان NEURON | زمان CPU خودِ عمل | تعداد فراخوانی اپراتور
عملیات ساده | 2,355 µs | ~125 µs | 6
torch.rms_norm | 403 µs | ~48 µs | 1
ساده + torch.compile | 376 µs | ~98 µs | 1
هم torch.rms_norm و هم torch.compile، RMSNorm را در یک ارسال هسته ادغام میکنند. در این اجراها، هر دو روش حدود یکششم زمان دستگاهِ پیادهسازی ساده را میگیرند. ادغام فاصلههای میان اجراهای سختافزاری را حذف میکند و از مادیسازی مقادیر میانی مانند x_sq و mean_sq میان عملیاتهایی که جداگانه ارسال میشوند جلوگیری میکند.
نتیجهگیری
key_averages() نشان میدهد کدام عملیات زمان دستگاه را مصرف میکنند، و خروجی کامل آن آمادهسازی و انتقالهای سمت CPU را هم آشکار میکند. Explorer رد بصری متناظر را فراهم میکند. میتوانید یک عملیات را از ارسال از سوی فریمورک، به زمانبندی در زمان اجرا و سپس اجرا روی سختافزار دنبال کنید و فاصلههایی را ببینید که ادغام حذفشان میکند.
همین جریان کاری را میتوانید روی مدلهای بزرگتر به کار ببرید: نقطهٔ داغ را در جدول پیدا کنید، آن را در رد تأیید کنید و سپس تعیین کنید آیا یک عملیات ادغامشده یا torch.compile میتواند هزینهٔ آن را کاهش دهد.
در بخش دوم به پروفایل سطح دستگاه میرویم. NEFF را باز میکنید، تفکیک TensorEngine، VectorEngine و دسترسی مستقیم به حافظه (DMA) را بررسی میکنید و هسته را روی مدل roofline قرار میدهید تا مشخص شود محدود به محاسبات است یا محدود به حافظه.
سپاس ویژه از Aritra Roy Gosthipaty (آریترا روی گوشیپاتی) برای الهام آغاز این مجموعه، و از همکارانم Pinak Panigrahi (پیناک پانیگراهی)، Samir Araujo (سمیر آرائوخو)، Akhil Azhikodan (آخیل آژیکودان)، Esha Lakhotia (ایشا لاکوشیا) و بقیه برای بازبینی!