مدلهایی که با تنظیم دقیق مدلهای بازمتن عمومی مانند Qwen و Gemma برای یک دامنه یا یک وظیفه تخصصی میشوند، واژگانی را به ارث میبرند که برای دامنهها و کاربردهای عمومی ساخته شده است.
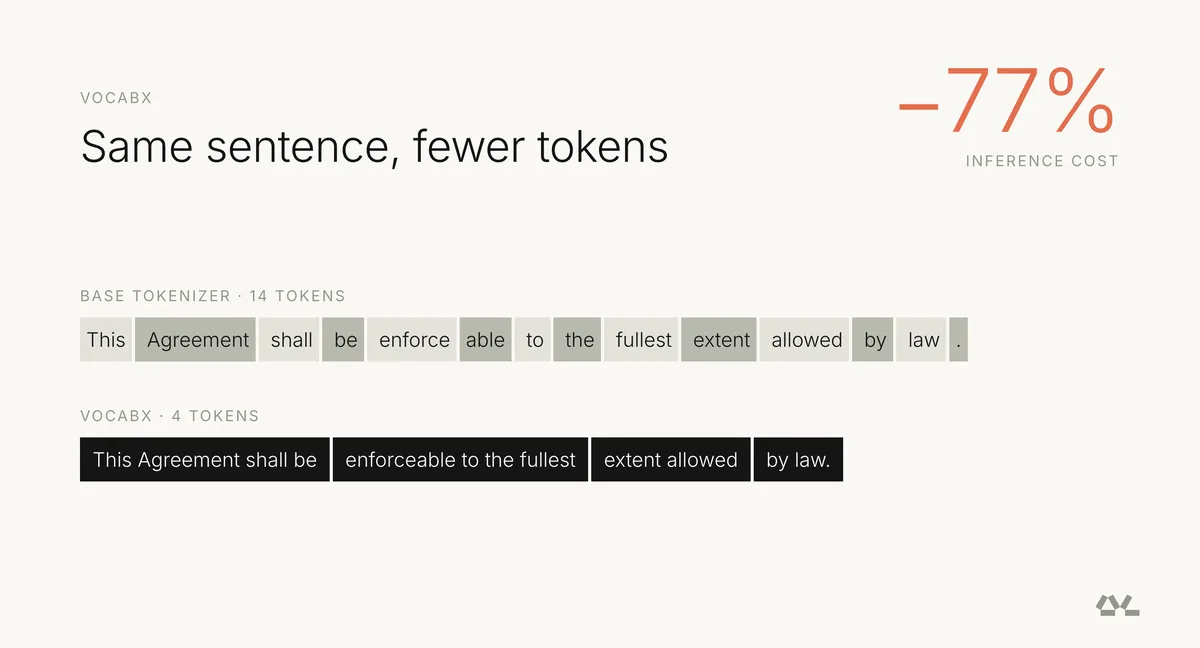
در یک نمرهدهنده مقاله که در محیط تولید اجرا میکنیم، همین واژگان متنی را که مدل بیشتر مینویسد به توکنهای زیادی میشکست. این مقاله بخشی از نتایج مقاله VocabX را پیشنمایش میدهد که بهزودی منتشر خواهیم کرد: چگونه واژگان را بر پایه هزینه هر توکن و نه بسامد آن تخصصی کردیم و هزینه استنتاج اندازهگیریشده را بدون تغییر مدل پایه ۷۷٪ کاهش دادیم.
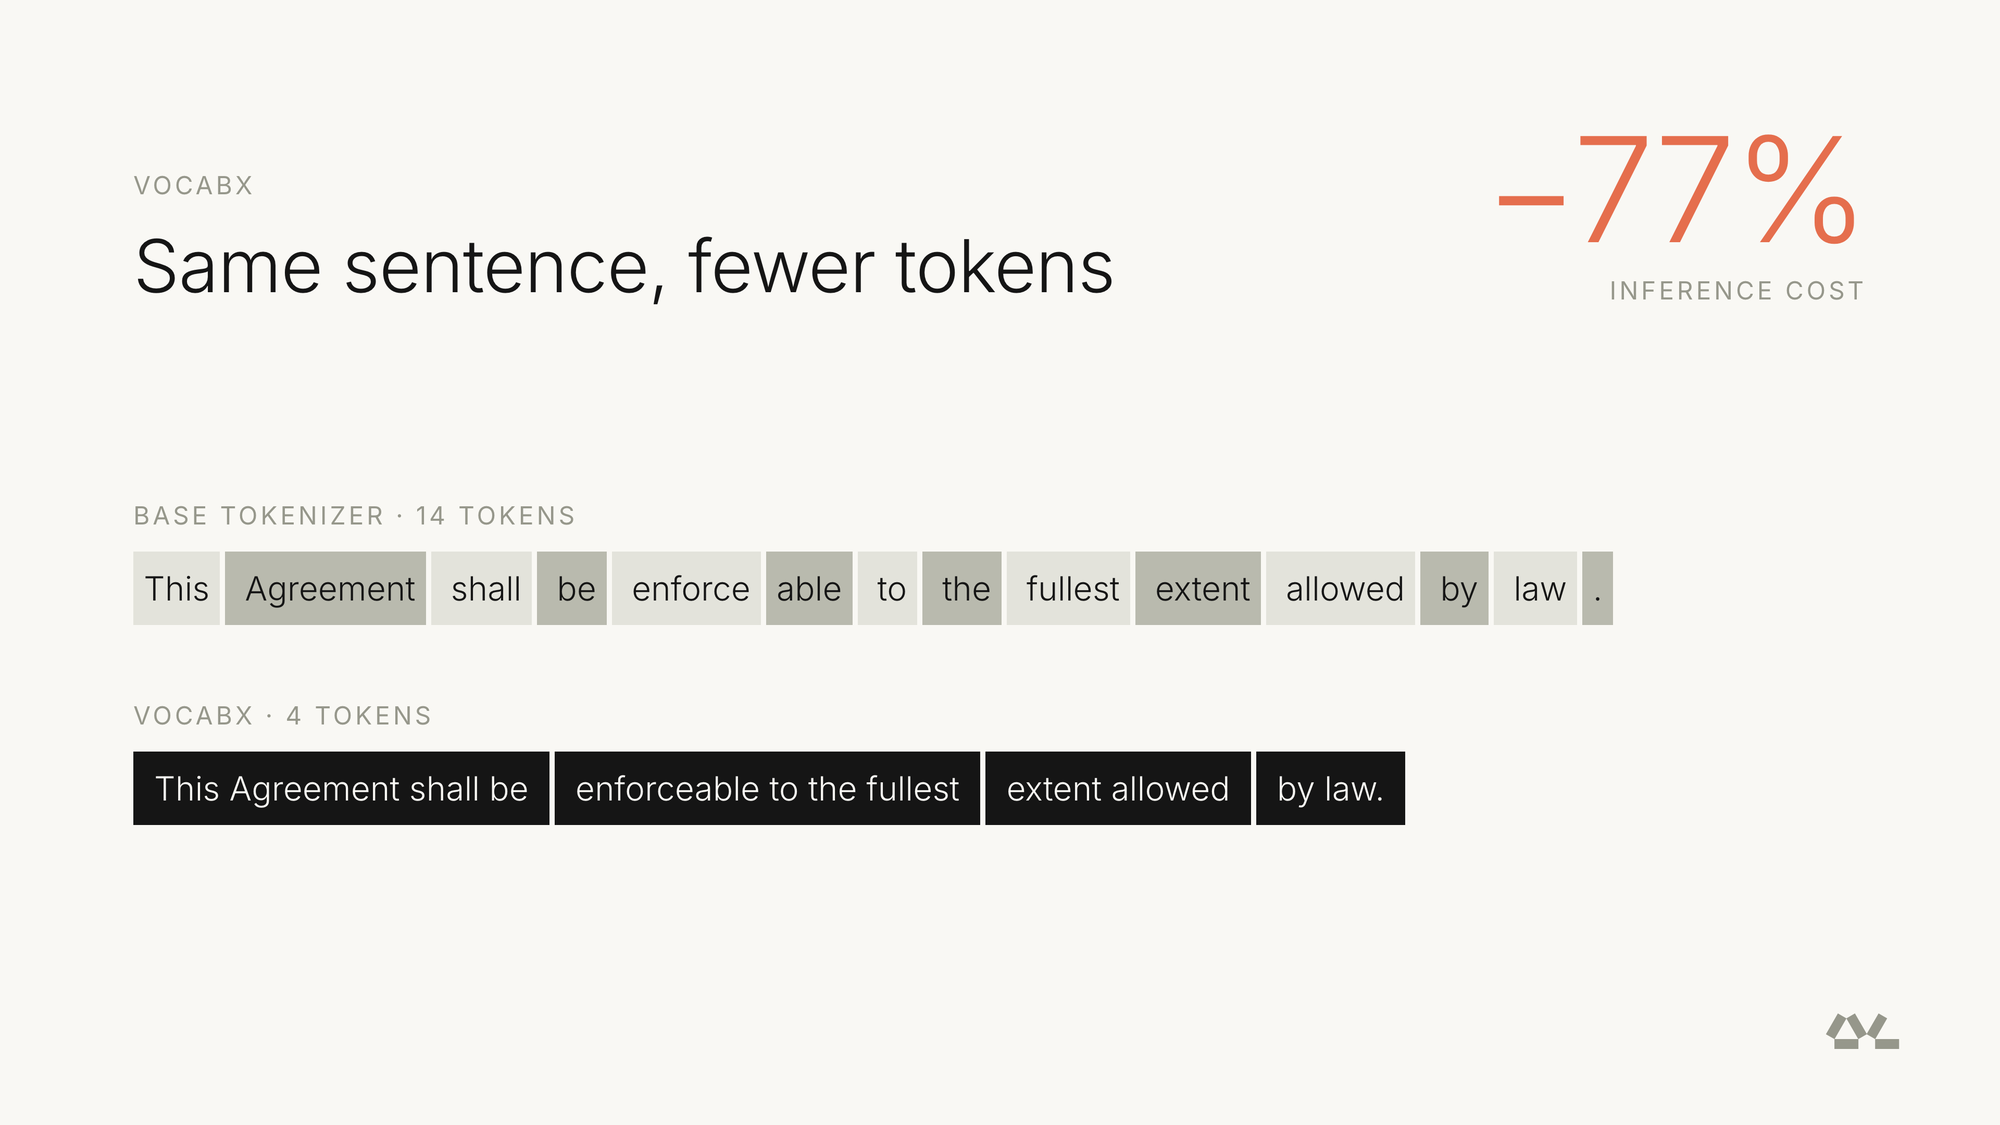
توکنایزر معمولاً ویژگی ثابت مدل پایه تلقی میشود؛ چیزی که به ارث میرسد و دستنخورده میماند. اما برای مدلی که در یک دامنه واحد تخصصی شده، میتواند یکی از بزرگترین اهرمهای کاهش هزینه باشد، و پیش از هر مرحله آموزش تعیین میشود.
یکی از سیستمهایی که در محیط تولید اجرا میکنیم، نمرهدهنده خودکار مقالههای پرتغالی است که بر پایه Qwen3-4B ساخته شده. این سیستم مقاله، پرامپت و متنهای پشتیبان را دریافت میکند و یک ارزیابی JSON شامل نمره و توضیح برای هر شایستگی برمیگرداند.
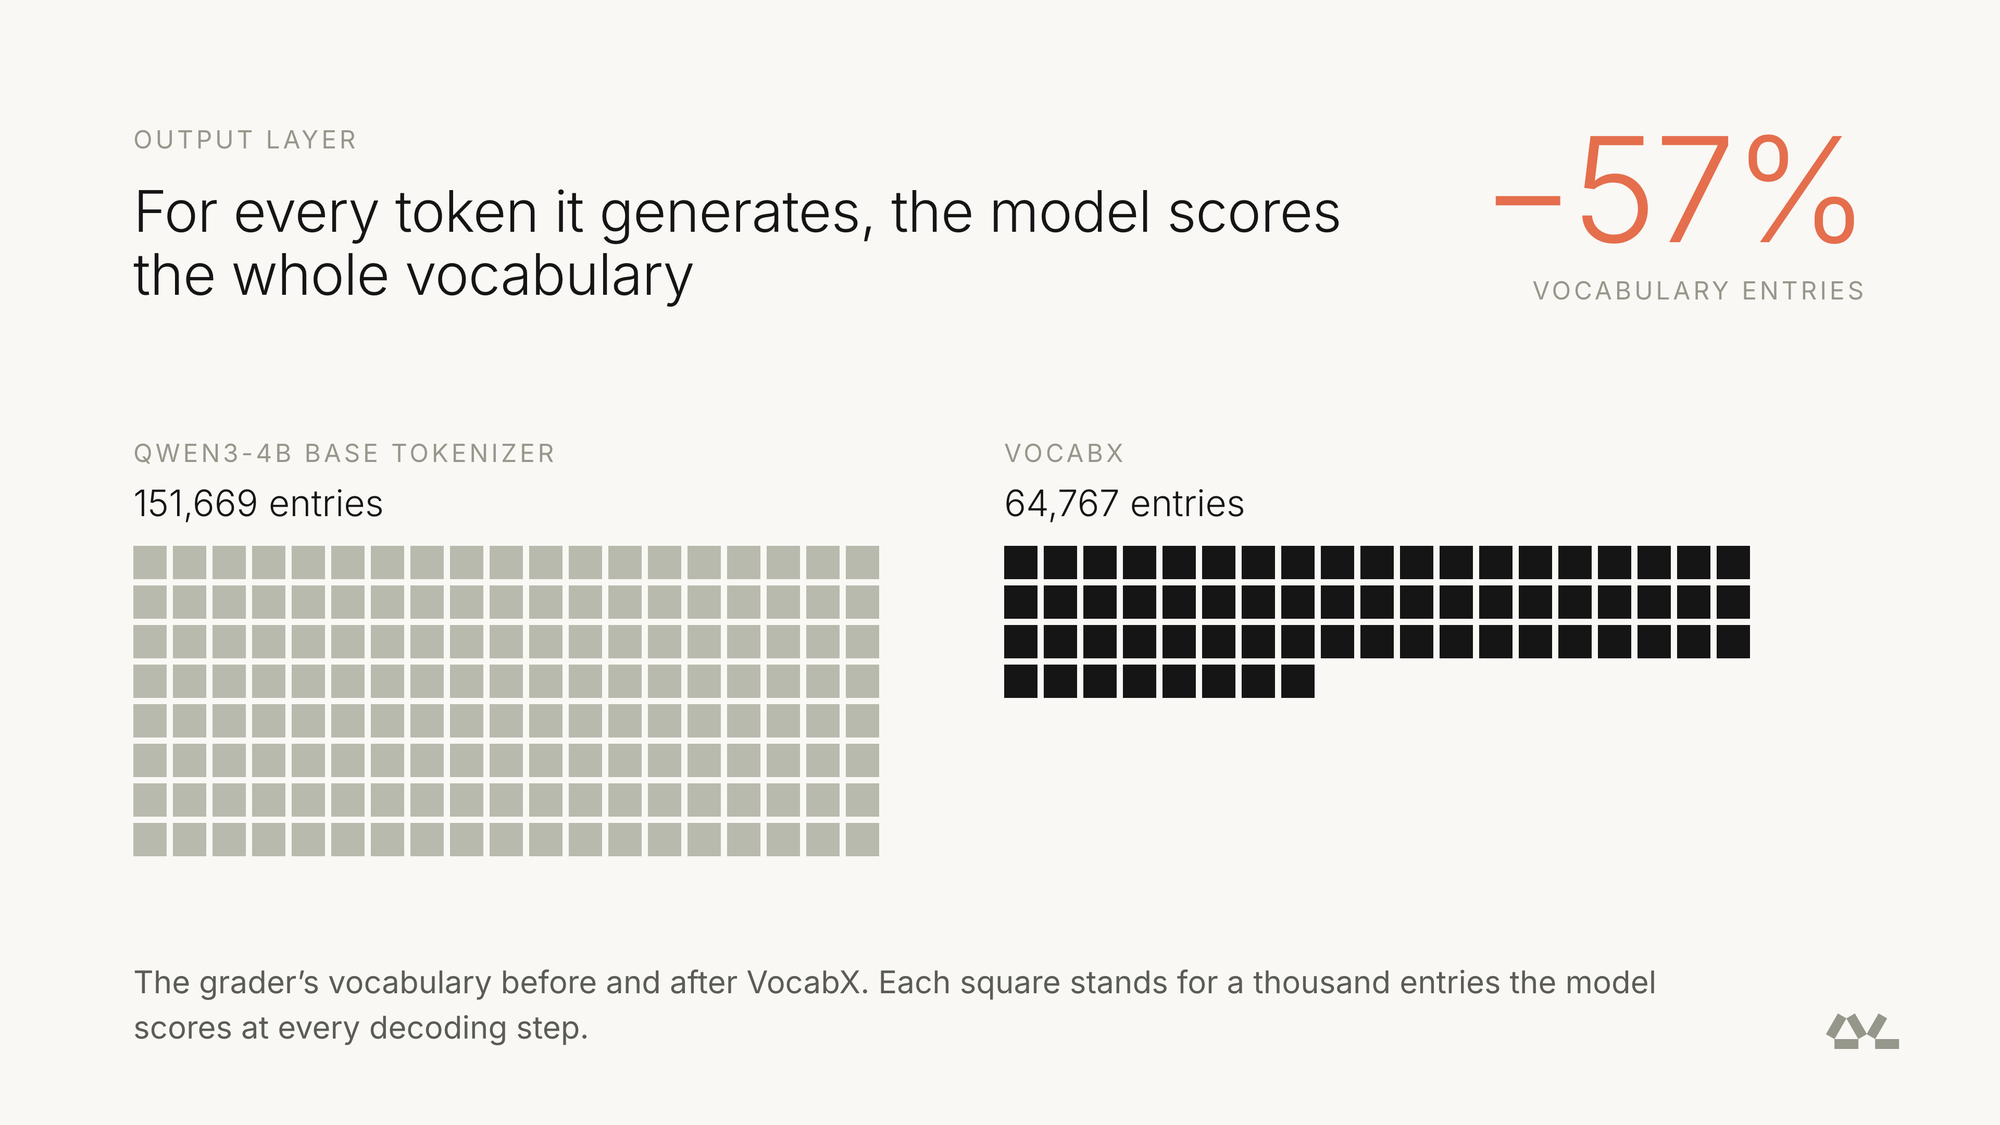
مدل از قبل کوچک بود، با ۴ میلیارد پارامتر، و از قبل برای این وظیفه آموزش دیده بود. اما توکنایزر آن همچنان توکنایزر اصلی Qwen3-4B بود که برای زبانها و انواع متنهای متعدد ساخته شده است. در این نمرهدهنده، توکنایزر فقط برای یک زبان، پرتغالی، و یک قالب پاسخ واحد به کار میرفت. این وضعیت دو هزینه داشت: متنی که نمرهدهنده در هر درخواست مینویسد بیش از نیاز توکن مصرف میکرد، و مدل در هر توکن تولیدی به واژگانی با ۱۵۱٬۶۶۹ ورودی امتیاز میداد که بسیاری از آنها در این وظیفه تقریباً هرگز استفاده نمیشوند.
ما آن واژگان را با روشی به نام VocabX بازسازی کردیم و مدل پایه، داده و دستور آموزش را یکسان نگه داشتیم. اعداد این مقاله از نسخه فعلی مقاله میآید که هنوز در دست داوری است و ممکن است پیش از انتشار تغییر کند.
واژگانی که برای همه ساخته شده
مدلهای زبانی پیشرو با توکن میخوانند و مینویسند، و توکنایزر تعیین میکند متن چگونه به توکن تبدیل شود. توکنایزرهای مدلهای عمومی پیشرو روی مجموعههای بزرگی از متن در دامنهها و زبانهای گوناگون آموزش دیدهاند؛ از کد منبع تا قراردادها تا چینی. برای یک مدل عمومی، این انتخاب منطقی است.
برای مدلی که در یک دامنه واحد به کار میرود، همین انتخاب همزمان دو نوع اتلاف ایجاد میکند.
اولی تکهتکهشدن است. توکنایزر دقیقاً همان چیزی را که دامنه بیشتر تکرار میکند به قطعات زیادی میشکند. در نمرهدهنده، هر پاسخ با همان پوشش JSON، همان نام شایستگیها و همان عبارتهای ارزیابی آغاز میشود. در قراردادها، این تکرار مربوط به بندهای کلیشهای است. در کد، مربوط به شناسهها. هر یک از این توالیها جایی که یک توکن کافی بود چند توکن هزینه دارد، و مدل هزینه هر یک از آنها را در هر درخواست میپردازد.
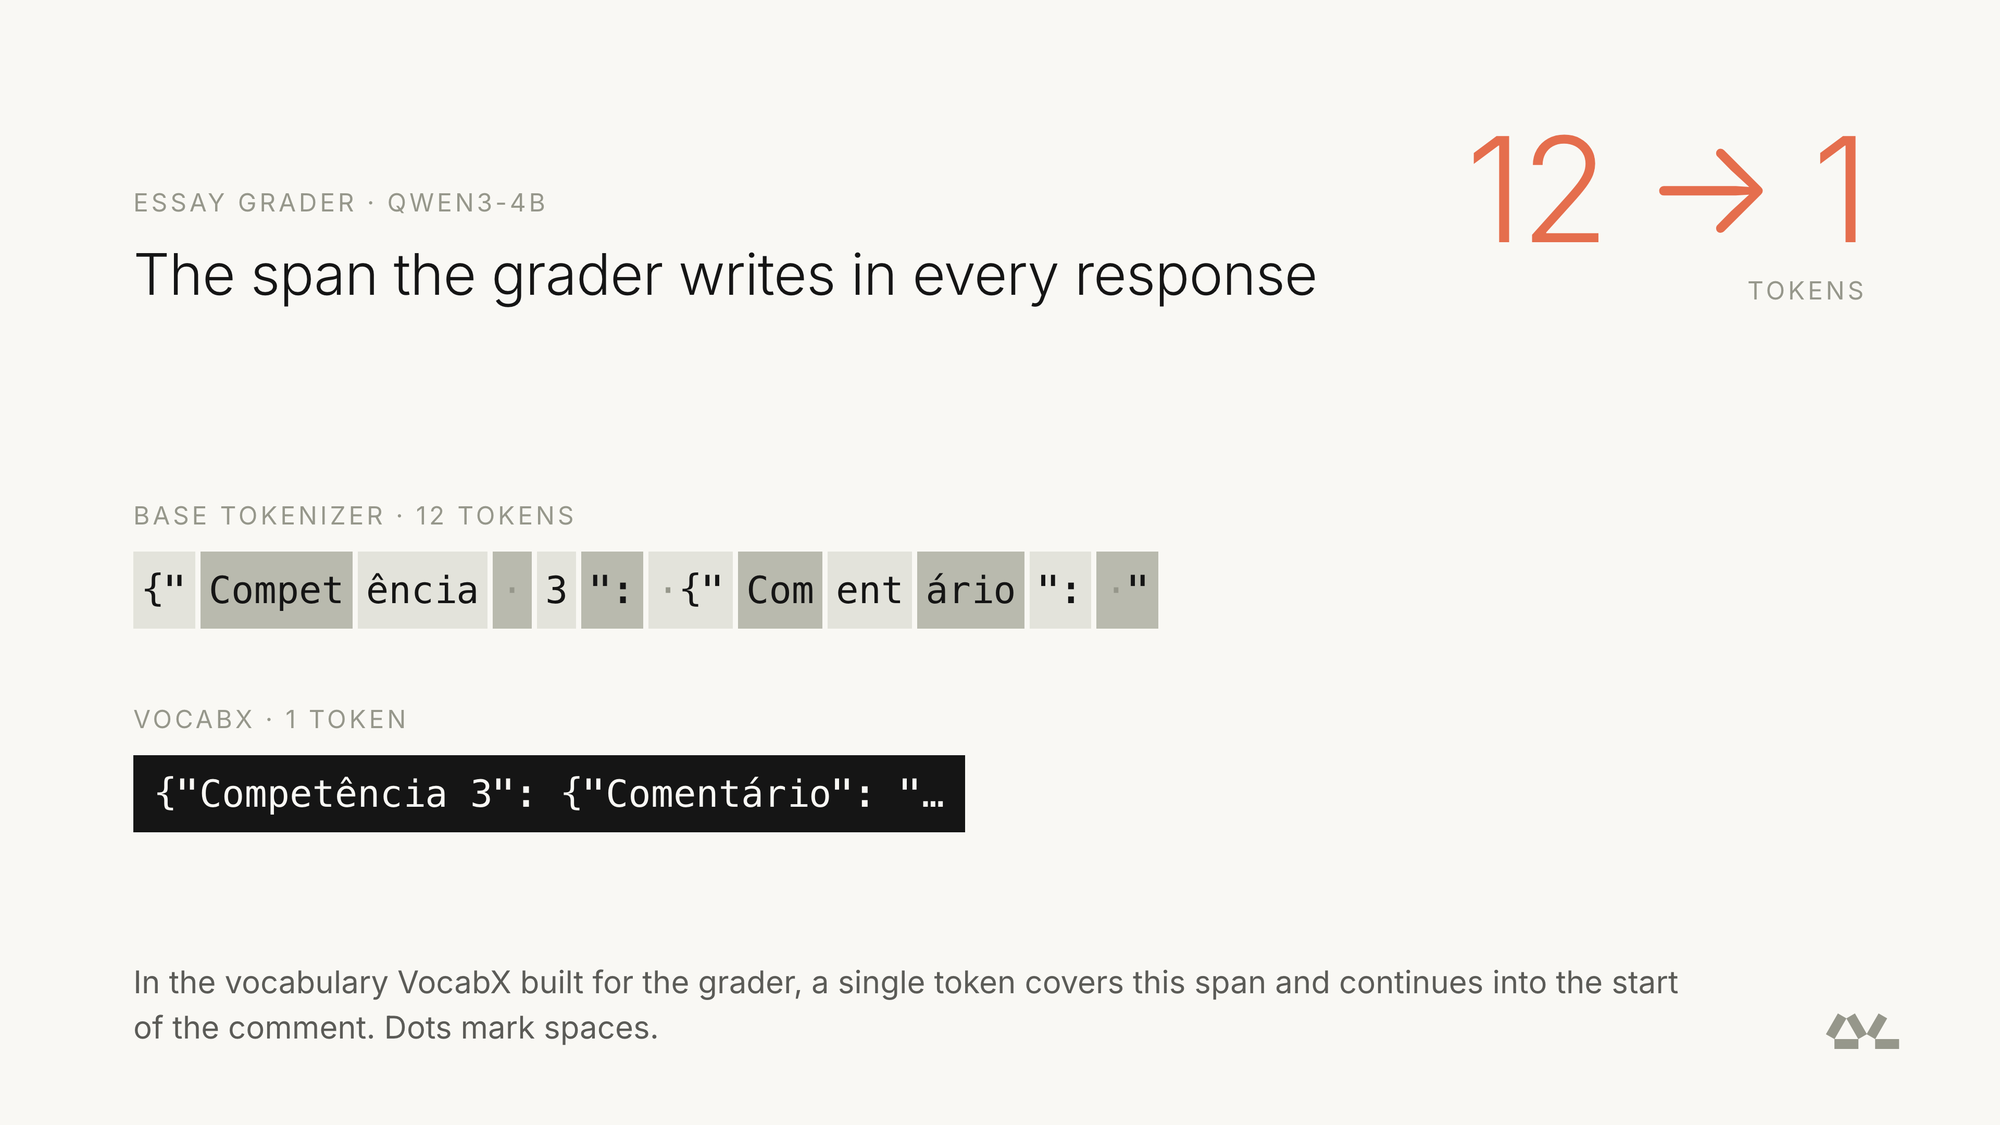
دومی مازاد است. واژگان دهها هزار ورودی دارد که دامنه هرگز از آنها استفاده نمیکند، و مدل در هر توکنی که تولید میکند برای همه آنها امتیاز محاسبه میکند. مدلی که برای نمرهدهی آزمونهای زیستشناسی مدارس آمریکا تنظیم شده، تقریباً هرگز به چینی نمینویسد، اما در هر گام احتمال هر توکن چینی را محاسبه میکند. واژگان آنچه را دامنه بیشتر تکرار میکند به قطعات زیادی میشکند و ورودیهایی را نگه میدارد که دامنه هرگز استفاده نمیکند.
خواندن ارزان است، نوشتن گران
واکنش طبیعی این است که توکنها را بشماریم و بکوشیم تعدادشان را کم کنیم. اما تعداد، صورتحساب نیست.
برای فهم اینکه چرا یک توکن تولیدی بیشتر هزینه دارد، بهتر است نگاهی به نحوه کار استنتاج بیندازیم. استنتاج دو فاز دارد. در پیشپرکردن (prefill)، مدل کل ورودی را در یک گذر از شبکه پردازش میکند: هر وزنی که از حافظه GPU خوانده میشود برای همه توکنهای ورودی دوباره به کار میرود و محدودیت، توان محاسباتی است. در رمزگشایی (decode)، مدل پاسخ را توکنبهتوکن تولید میکند و هر توکن یک گذر کامل نیاز دارد. هر خواندن وزن فقط چند بار استفاده میشود و GPU بیشتر وقت خود را صرف انتظار برای رسیدن داده از حافظه میکند: محدودیت به پهنای باند حافظه تبدیل میشود.
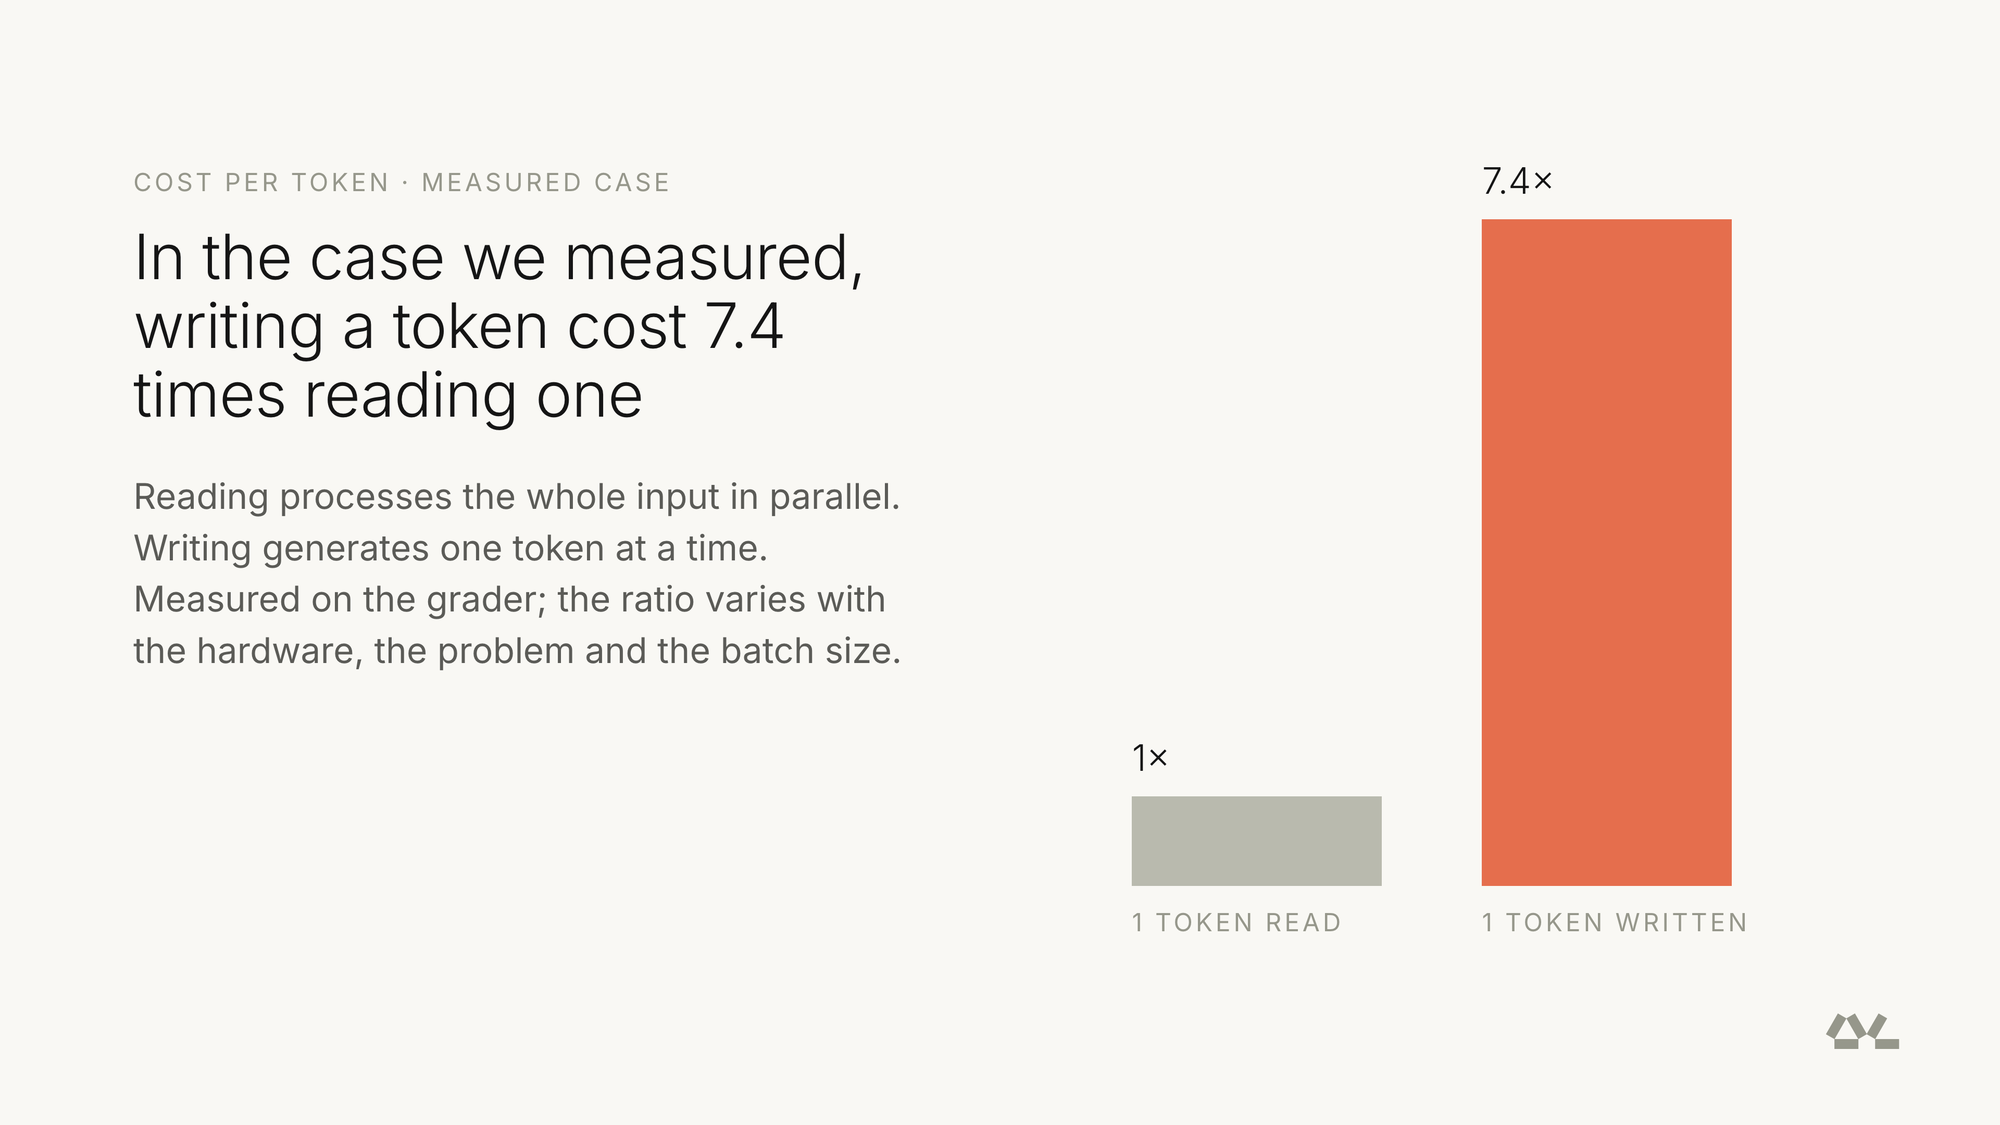
این اثر دقیقاً در همان جایی قویترین است که ما کار میکنیم: مدلهای کوچک که با دستههای متوسط سرو میشوند. دستهبندی درخواستها خواندن وزنها را میان آنها تقسیم میکند و مشکل را کم میکند، اما حل نمیکند. در هر گام رمزگشایی، مدل حافظه KV (KV cache) را هم میخواند؛ حافظه توجهی که زمینه پردازششده را نگه میدارد و با آن رشد میکند. در موردی که اندازه گرفتیم، یعنی همین نمرهدهنده، هزینه یک توکن تولیدی ۷.۴ برابر یک توکن خواندهشده است، اما این نسبت به سختافزار، مسئله، اندازه دسته، طول زمینه و عوامل دیگر بستگی دارد و میتواند از این هم بیشتر باشد. بهطور کلی جهت رابطه برقرار است: تولید گرانتر از خواندن است.
شرکتی حملونقل را در نظر بگیرید که برای هر جعبه هزینه میگیرد، اما برای جعبههای خروجی هفت برابر جعبههای ورودی. کمکردن تعداد کل جعبهها کمک میکند. کمکردن جعبههای خروجی هفت برابر بیشتر کمک میکند. روشی که ورودی و خروجی را به یک اندازه فشرده کند، بیشتر صرفهجویی ممکن را از دست میدهد.
جزء سوم صورتحساب، خود واژگان است. لایه آخر مدل، سر LM (LM head)، وضعیت داخلی را به امتیازی برای هر توکن ممکن تبدیل میکند. برای این کار، برای هر ورودی واژگان یک ردیف پارامتر نگه میدارد. در مدلی به اندازه Qwen3-4B، این ماتریس تقریباً ۱۰٪ پارامترها را تشکیل میدهد. سهمی که مدلهای بزرگ بدون توجه جذبش میکنند، اما برای مدل کوچک سنگین است.
و این هزینه فقط یک بار پرداخت نمیشود. لایه ورودی فقط ردیف توکنی را که خوانده میشود جستوجو میکند، اما سر LM برای هر توکن تولیدی کل ماتریس را میخواند و ضرب میکند. چون رمزگشایی از قبل به حافظه وابسته است، هر ردیف اضافه داده بیشتری است که باید در هر گام جابهجا شود. ورودیای که دامنه هرگز استفاده نمیکند دقیقاً همان هزینه ورودی پرکاربرد را دارد. به همین دلیل است که افزودن توکن میتواند همزمان تعداد را کم و صورتحساب را زیاد کند. VocabX این جزء را در معیار انتخاب خود نمیگنجاند، اما اندازه واژگان را در دو مرحله کنترل میکند: ادغام زیرواژه واژگان پایه را با واژگانی کوچکتر و مخصوص دامنه جایگزین میکند، و توکنهای کلان (macro token) زیر یک سقف ثابت وارد میشوند. در نمرهدهنده، لایه خروجی از حدود ۱۵۲٬۰۰۰ ردیف به حدود ۶۵٬۰۰۰ ردیف رسید.
چرا راهحلهای موجود کافی نبودند
تطبیق واژگان مدل ایده تازهای نیست. روشهای مرجع در ادبیات، مانند انتقال سریع واژگان (fast vocabulary transfer یا FVT)، توکنسازی چندواژهای (multi-word tokenization یا MWT) و گسترش درجای توکنایزر (in-place tokenizer expansion یا in-place BPE) از Liquid AI که آموزش BPE را از واژگان اصلی ادامه میدهد، از قبل تکهتکهشدن را کم میکنند. وقتی آنها را روی مسئله خود آزمودیم، دو محدودیت یافتیم.
آنها توکنها را بر پایه بسامد انتخاب میکنند، نه هزینه. عبارتی که در ورودی زیاد ظاهر میشود برای آنها ارزش بیشتری از عبارتی دارد که در پاسخ کمتر ظاهر میشود، حتی اگر دومی برای سرو کردن گرانتر باشد.
آنها روی یک لایه کار میکنند. یا نحوه برش کلمهها به قطعات را تنظیم میکنند، یا عبارتهای کامل را در یک توکن ادغام میکنند. هیچیک از این سه روش هر دو کار را زیر یک معیار انجام نمیدهد. و بزرگترین اتلاف نمرهدهنده دقیقاً در بازههای بلند و تکراری مانند پوشش JSON بود که یک روش زیرواژهای فقط پس از ادغام تکتک اجزا به آن میرسد.
چگونه حلش کردیم
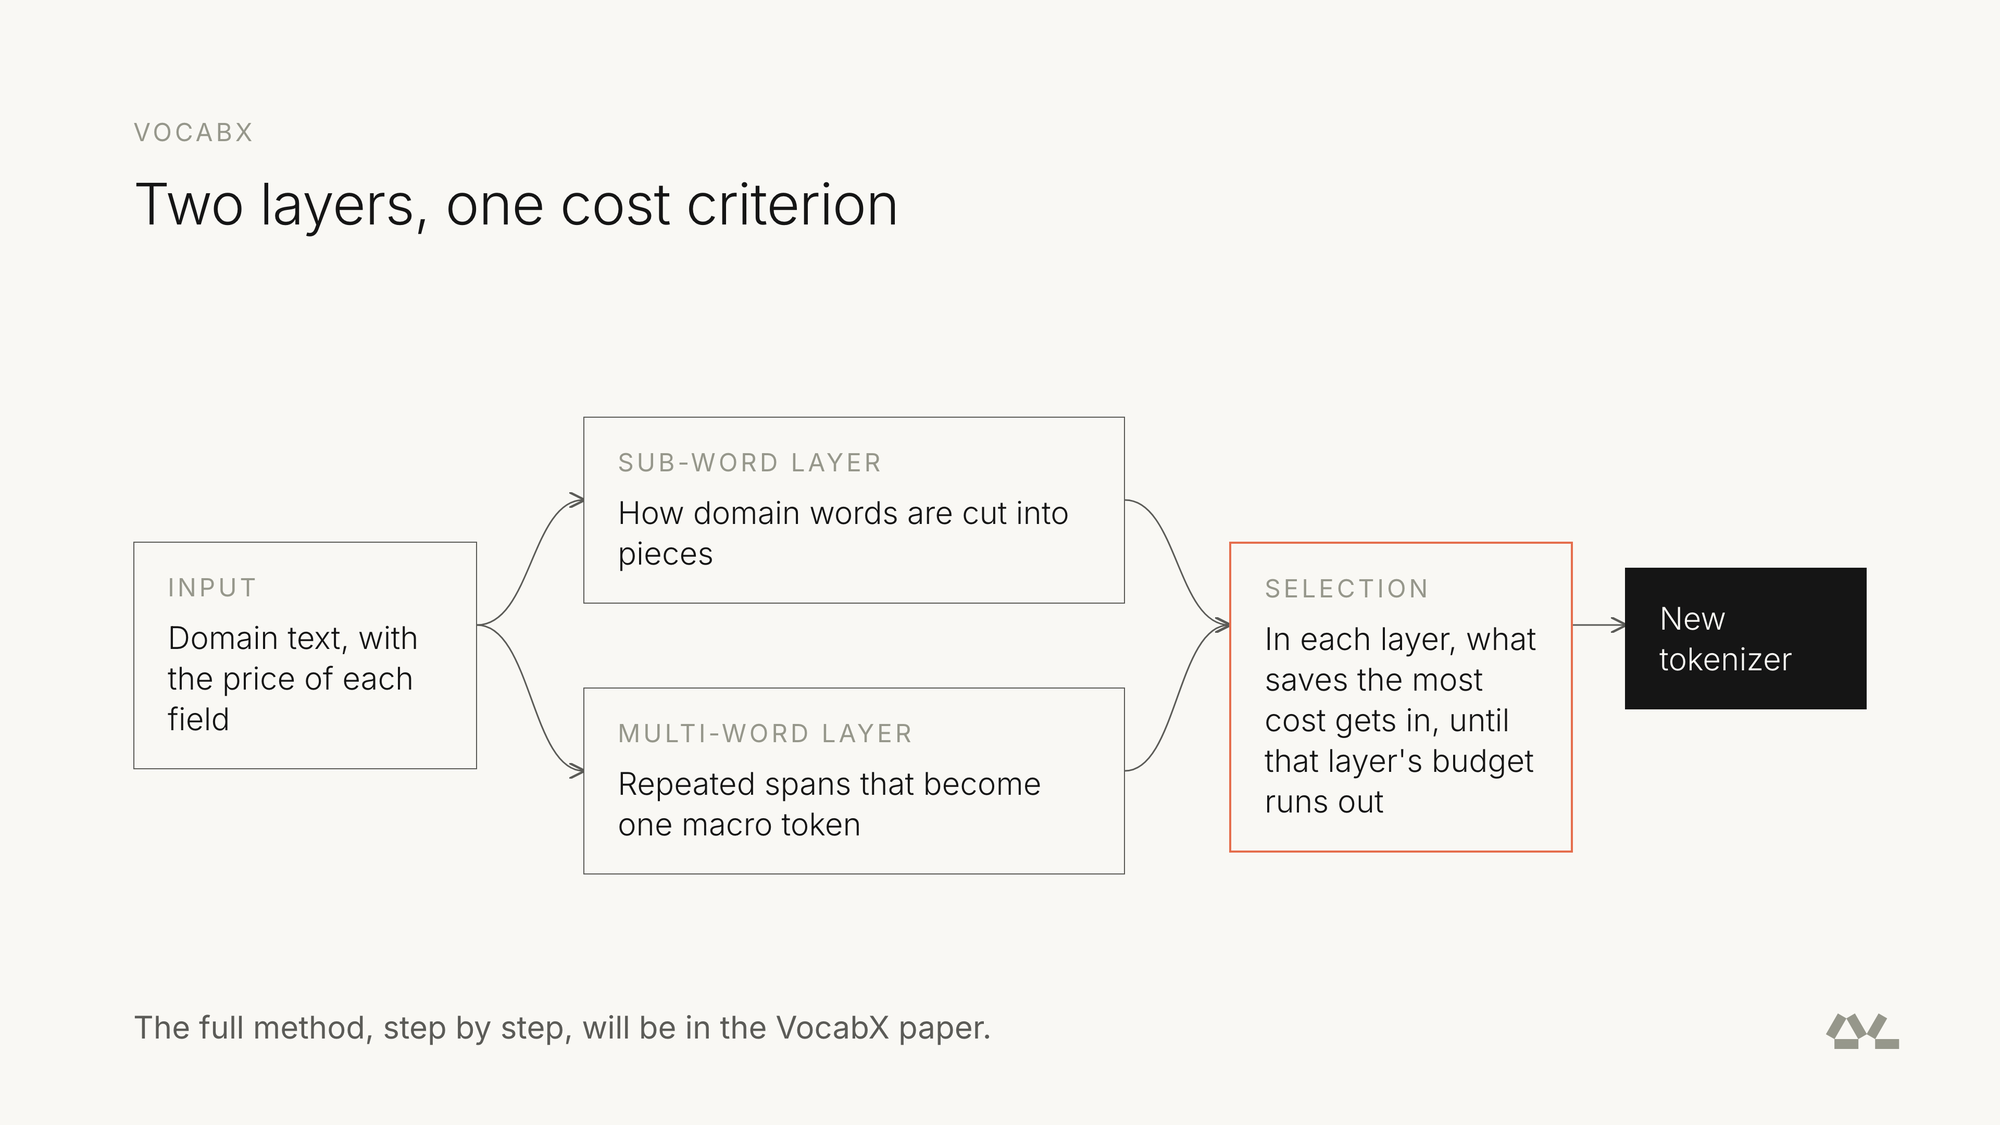
VocabX هر دو محدودیت را برطرف میکند، بهعلاوه مشکل سومی که در مسیر بدیهی حل مشکل اول پیش میآید.
اول، پرسش را تغییر دادیم. بهجای اینکه بپرسیم یک نامزد چند توکن صرفهجویی میکند، میپرسیم چقدر هزینه و زمان صرفهجویی میکند. هر توکن حذفشده در قیمت فیلدی که در آن ظاهر میشود ضرب میشود: پرامپت سیستم، پیام کاربر یا پاسخ مدل. در موردی که اندازه گرفتیم، یعنی همین نمرهدهنده، یک توکن صرفهجوییشده در پاسخ ۷.۴ برابر یک توکن صرفهجوییشده در ورودی ارزش دارد، و واژگان بر همین اساس ساخته میشود.
دوم، همزمان روی هر دو لایه کار میکنیم. برگردیم به شرکت حملونقل: میتوانید جعبهها را با بستهبندی بهتر هر قلم کم کنید، یا با تشخیص اینکه همان کیت دوازدهقلمی هر هفته ارسال میشود و فرستادن کیت در یک جعبه واحد. VocabX هر دو کار را میکند. در لایه زیرواژه، نحوه برش کلمههای دامنه به قطعات را بازسازی میکند. در لایه چندواژه، به دنبال بازههای کامل تکراری میگردد، از عبارتهای کوتاه تا خطوط کامل و پوششهای JSON، و هر یک را به یک توکن واحد تبدیل میکند که ما آن را توکن کلان (macro token) مینامیم. هر دو لایه زیر همان معیار هزینه انتخاب میشوند، هر یک با بودجه خودش.
برای یافتن این بازهها از پنج کاوشگر (miner) استفاده میکنیم؛ جستوجوهای خودکاری برای یافتن بازههایی که در پیکره تکرار میشوند و هر یک در یک نوع تکرار تخصص دارند: واژههای بلند، خطوط کامل، عبارتها، جملههای کامل، و ساختارهای دارای نقطهگذاری مانند JSON و تگها. با میانگینگیری روی هشت پیکره، کاوشگر آخر بیشترین سهم را داشت و در کد بهتنهایی ۱۷.۵ واحد سهم داشت. بدون هر پنج کاوشگر، کاهش توکن در نمرهدهنده ۵۵.۶ واحد افت میکرد.
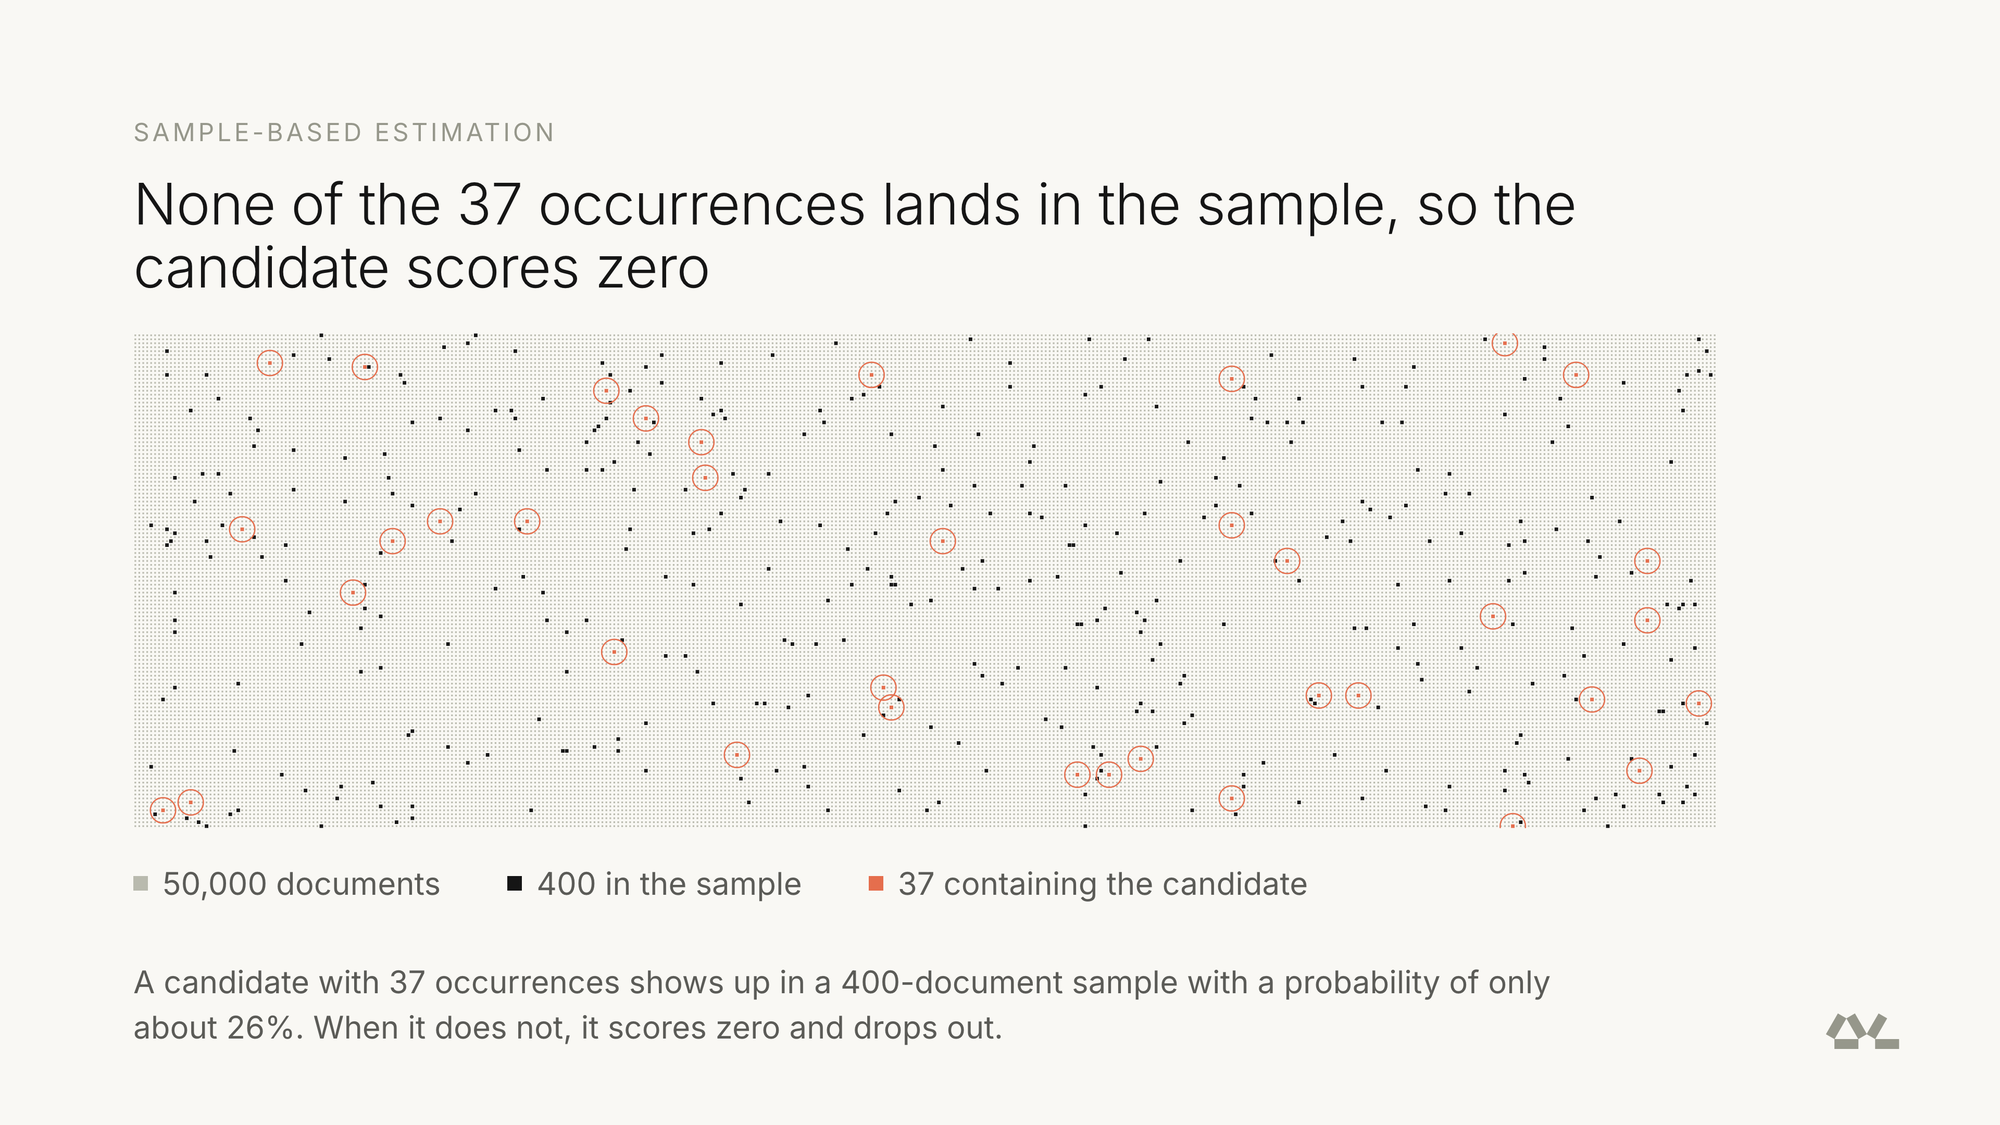
سوم، آنچه را که نمونه نمیبیند برآورد میکنیم. انتخاب توکن بر پایه هزینه مستلزم دانستن این است که هر نامزد پس از توکنهای انتخابشده چقدر صرفهجویی میکند. اندازهگیری دقیق این مقدار مستلزم پردازش دوبارهٔ کل پیکره پس از هر انتخاب است، دهها هزار بار. روش رایج برای انجام این کار در مقیاس بزرگ، اندازهگیری روی نمونهای از اسناد است، و در این حالت نامزدی که در نمونه حاضر نیست سود صفر میگیرد.
عبارتی که ۳۷ بار در ۵۰٬۰۰۰ سند ظاهر میشود، در نمونهای با ۴۰۰ سند فقط حدود ۲۶٪ مواقع دیده میشود. در پیکرهای از قراردادها، فقط ۱۶.۶٪ نامزدها در نمونهای با ۴۰۰ سند ظاهر میشوند؛ بقیه هرگز ارزیابی نمیشوند.
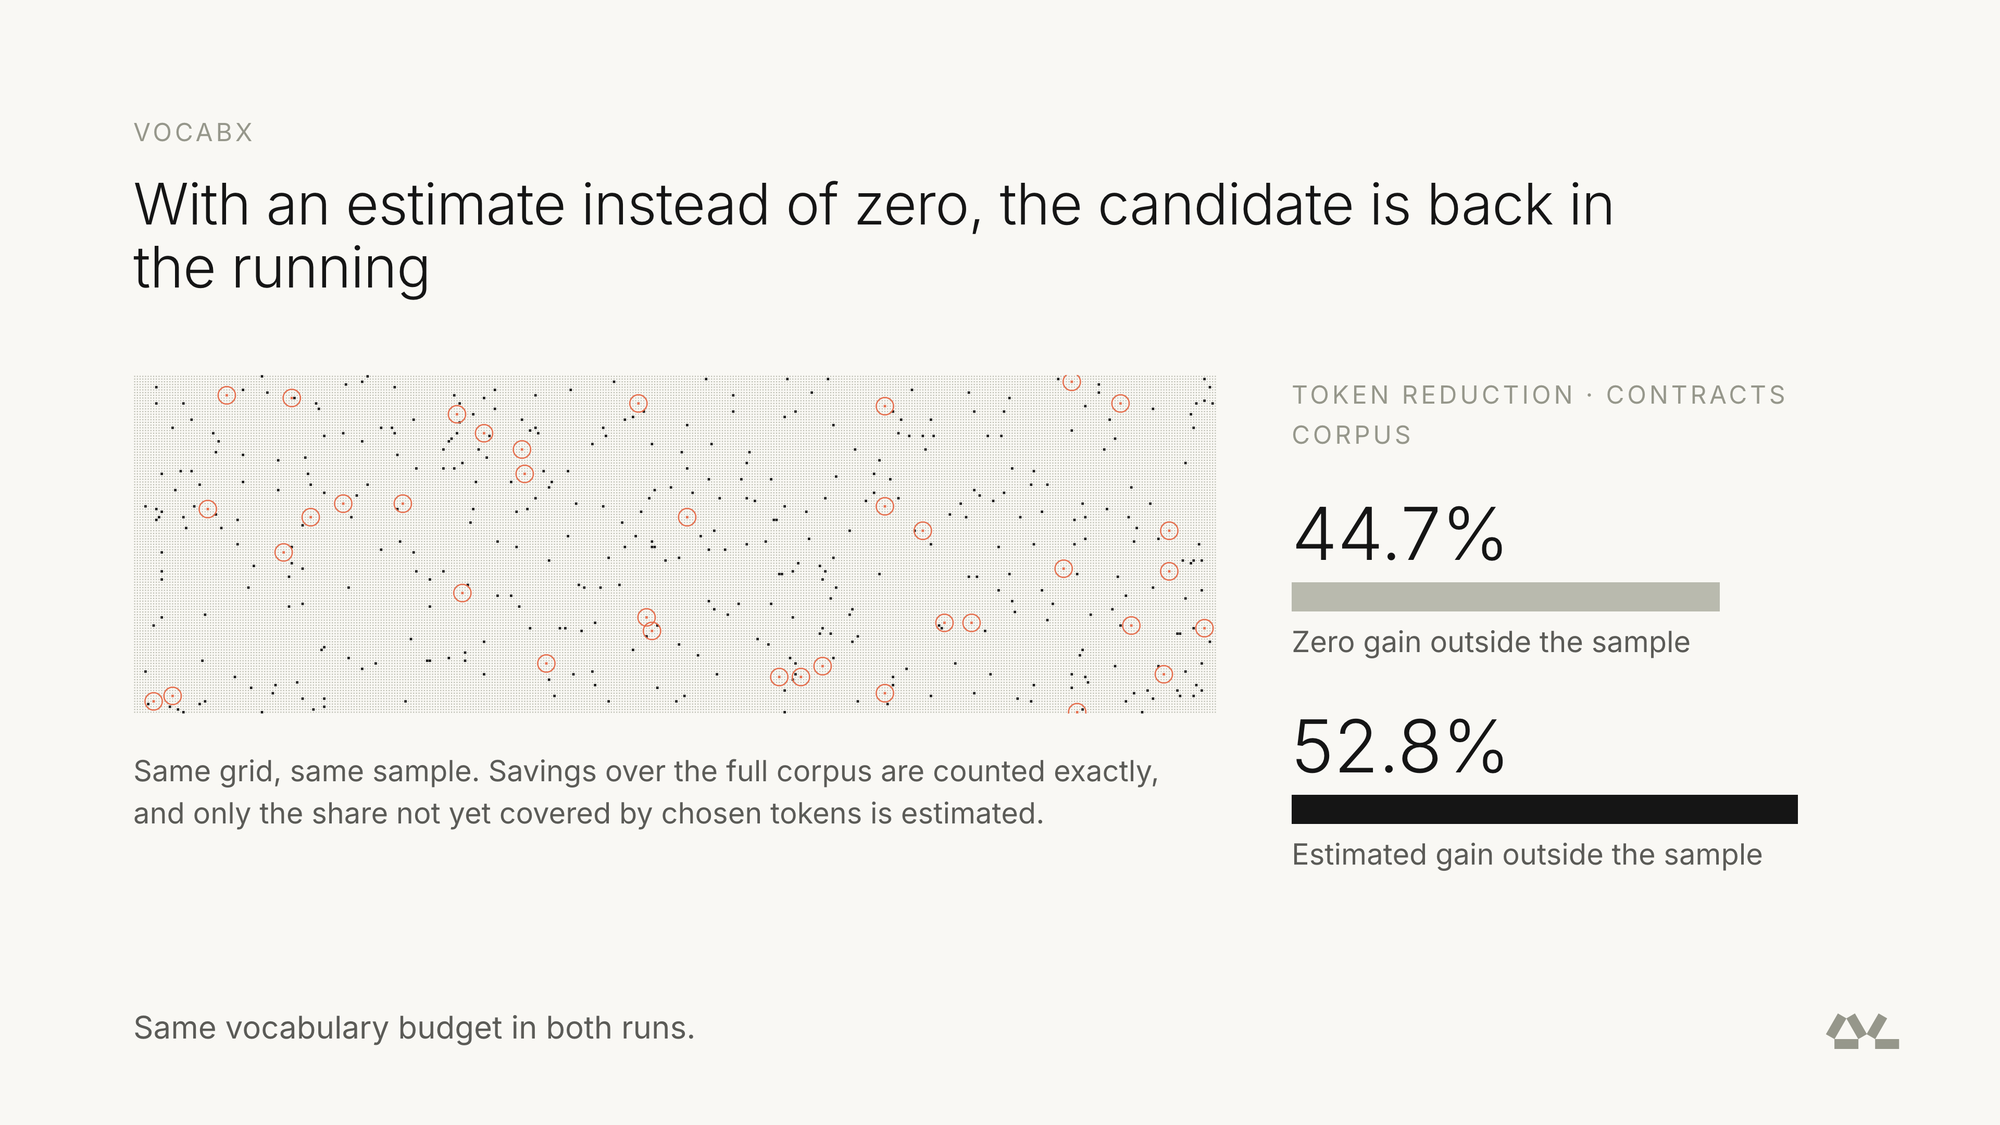
سود یک نامزد دو بخش دارد. یکی اینکه در کل پیکره چقدر صرفهجویی میکند، و این را میتوان دقیق و بدون نمونه شمرد. دیگری اینکه چه مقدار از این صرفهجویی هنوز توسط توکنهای انتخابشده پوشش داده نشده است، و فقط همین بخش نیاز به برآورد دارد. برای نامزدهایی که نمونه نمیبیند، بهجای صفر از برآورد آماری بر پایه رفتار نامزدهایی که نمونه میبیند استفاده میکنیم. نامزدی که در نمونه کمیاب اما در پیکره پرتکرار است، دوباره وارد رقابت میشود.
همین تغییر بهتنهایی، با همان نمونه و همان بودجه، کاهش توکن را در پیکرهای از قراردادها از ۴۴.۷٪ به ۵۲.۸٪ رساند.
چه چیزی در نمرهدهنده تغییر کرد
برای اندازهگیری اثر واقعی، هفت نسخه از نمرهدهنده را با همان مدل پایه، همان داده، همان دستور آموزش و همان بذر تصادفی آموزش دادیم. تنها تفاوت میان آنها توکنایزر است. همهٔ آنها همان ۵۰۰ درخواست را روی همان ماشین آزمون، با کارت گرافیک RTX 5090 و سرور استنتاج vLLM اجرا کردند، و هزینه از زمان اجرای اندازهگیریشده محاسبه شد.
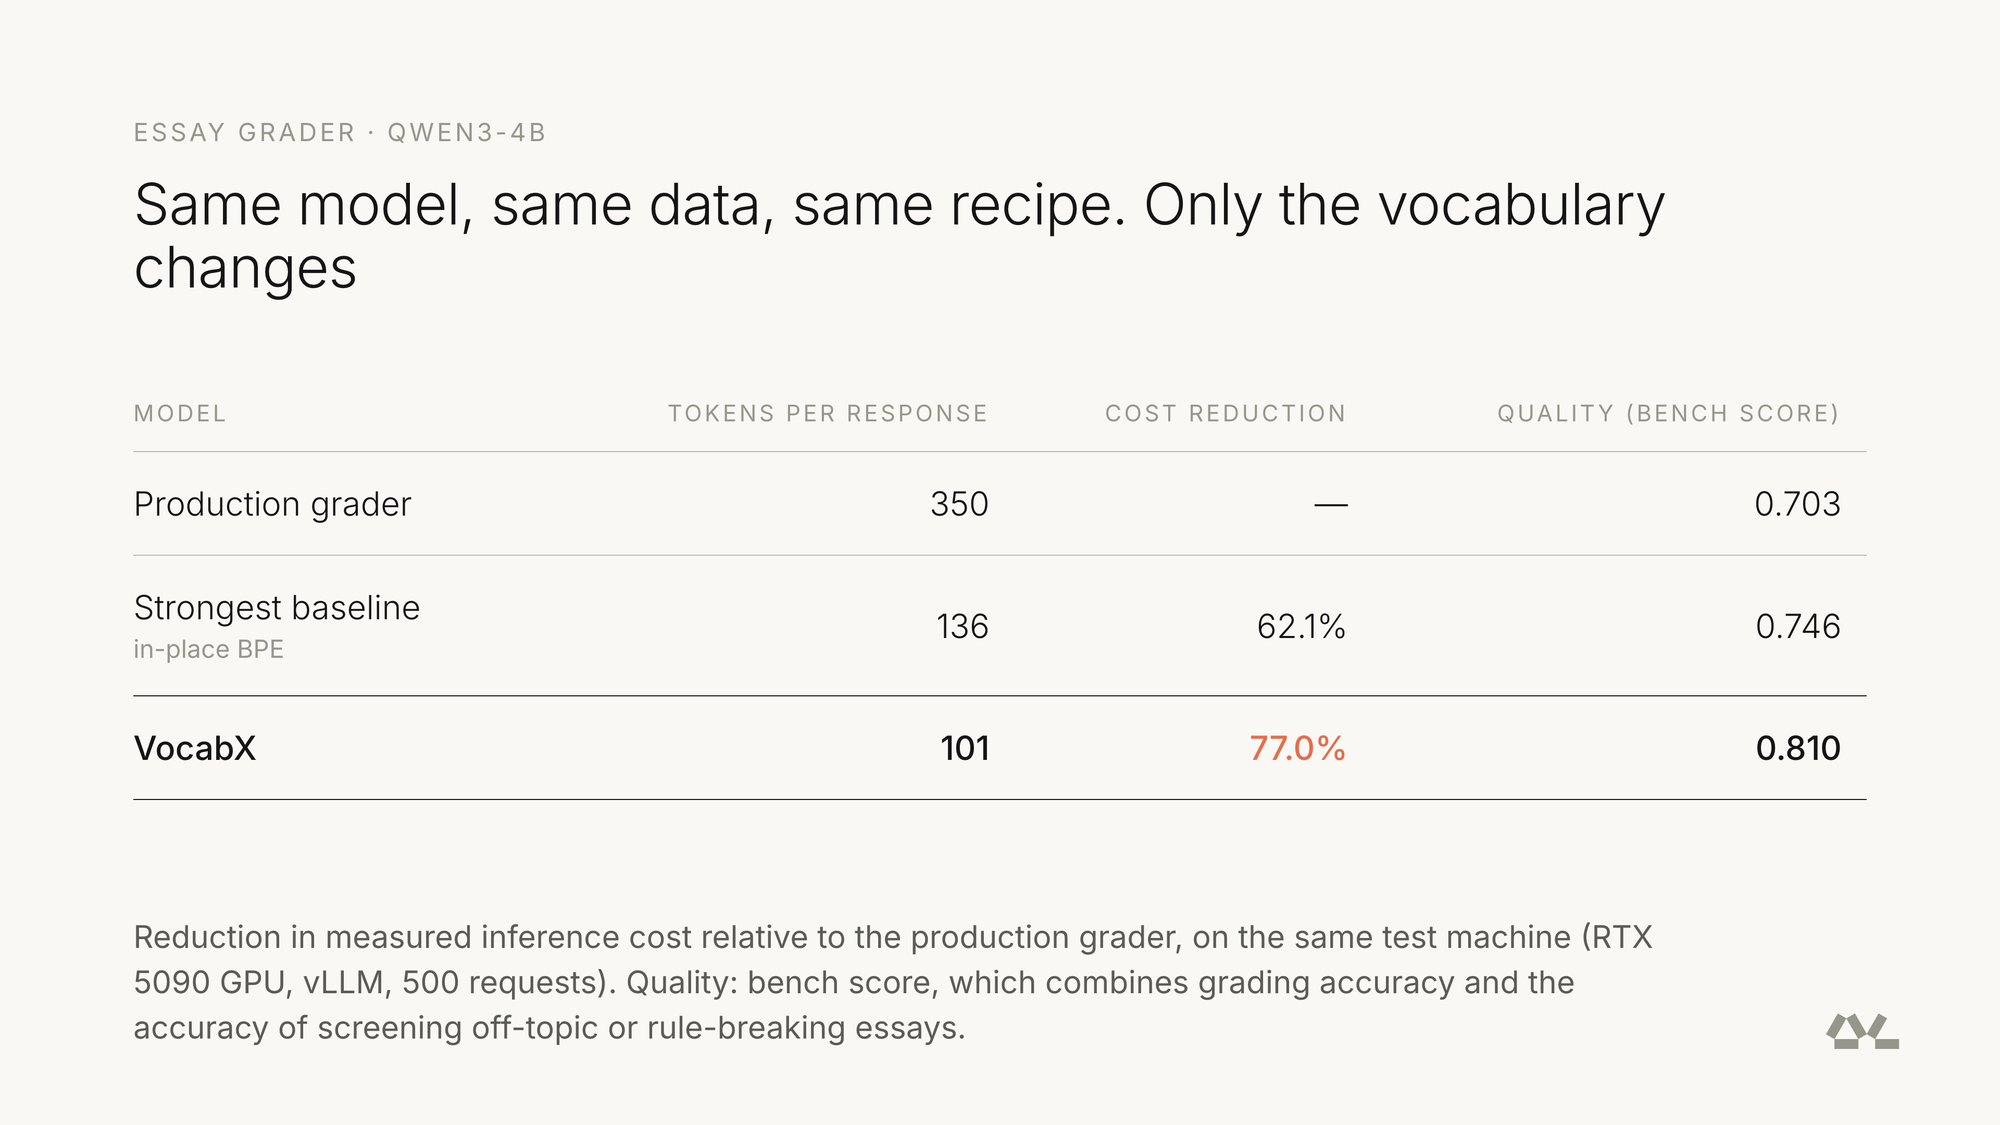
پاسخ مدل بهطور میانگین از ۳۵۰ توکن به ۱۰۱ توکن کاهش یافت. هزینه ۷۷.۰٪ کم شد. کیفیت، که با امتیاز بنچ سنجیده میشود و دقت نمرهدهی و دقت غربالگری مقالههای خارج از موضوع یا ناقض قواعد را با هم میسنجد، از ۰.۷۰۳ به ۰.۸۱۰ رسید.
رسیدن به این نتیجه نیازمند اصلاح مسیر بود. نسخهٔ اول واژگان، نمرهٔ هر شایستگی را با JSON اطرافش در یک توکن کلان واحد ادغام میکرد. این فشردهترین گزینه بود، اما کیفیت افت کرد: امتیاز بنچ آن ۰.۶۸۹ بود، پایینتر از ۰.۷۰۳ نمرهدهندهٔ تولیدی. با قرارگرفتن نمره درون توکن کلان، هر ترکیب از نمره و ساختار به گونهای متفاوت از همان توکن تبدیل میشد و مدل هر دو را در یک گام انتخاب میکرد. دادن توکن جداگانه به نمره، هر پاسخ ۲ توکن اضافه هزینه داشت، امتیاز بنچ را به ۰.۸۱۰ رساند و در اندازهگیری حتی ارزانتر بود: کاهش ۷۷.۰٪ در برابر ۷۳.۳٪ برای نسخهٔ ادغامشده.
این درس فراتر از نمرهدهنده کاربرد دارد. فشردهسازی وقتی هزینه دارد که بازهٔ فشردهشده همان تصمیمی را حمل کند که مدل برای گرفتنش وجود دارد. هدف، ارزانترین واژگان ممکن نیست؛ ارزانترین واژگانی است که توکنهای مهم را حفظ کند.
فراتر از نمرهدهنده
برای فهمیدن اینکه آیا این سود مخصوص مورد ما بود، VocabX را با سه روش مرجع روی پنج دامنهٔ عمومی (قراردادها، مقالههای پزشکی، مقالههای علمی، اخبار و کد پایتون) و سه خانوادهٔ مدل (Qwen3، Llama-3.1 و Gemma-3) مقایسه کردیم. همهٔ روشها از همان اسناد کاوش و آزمون و همان سقف واژگان استفاده کردند.
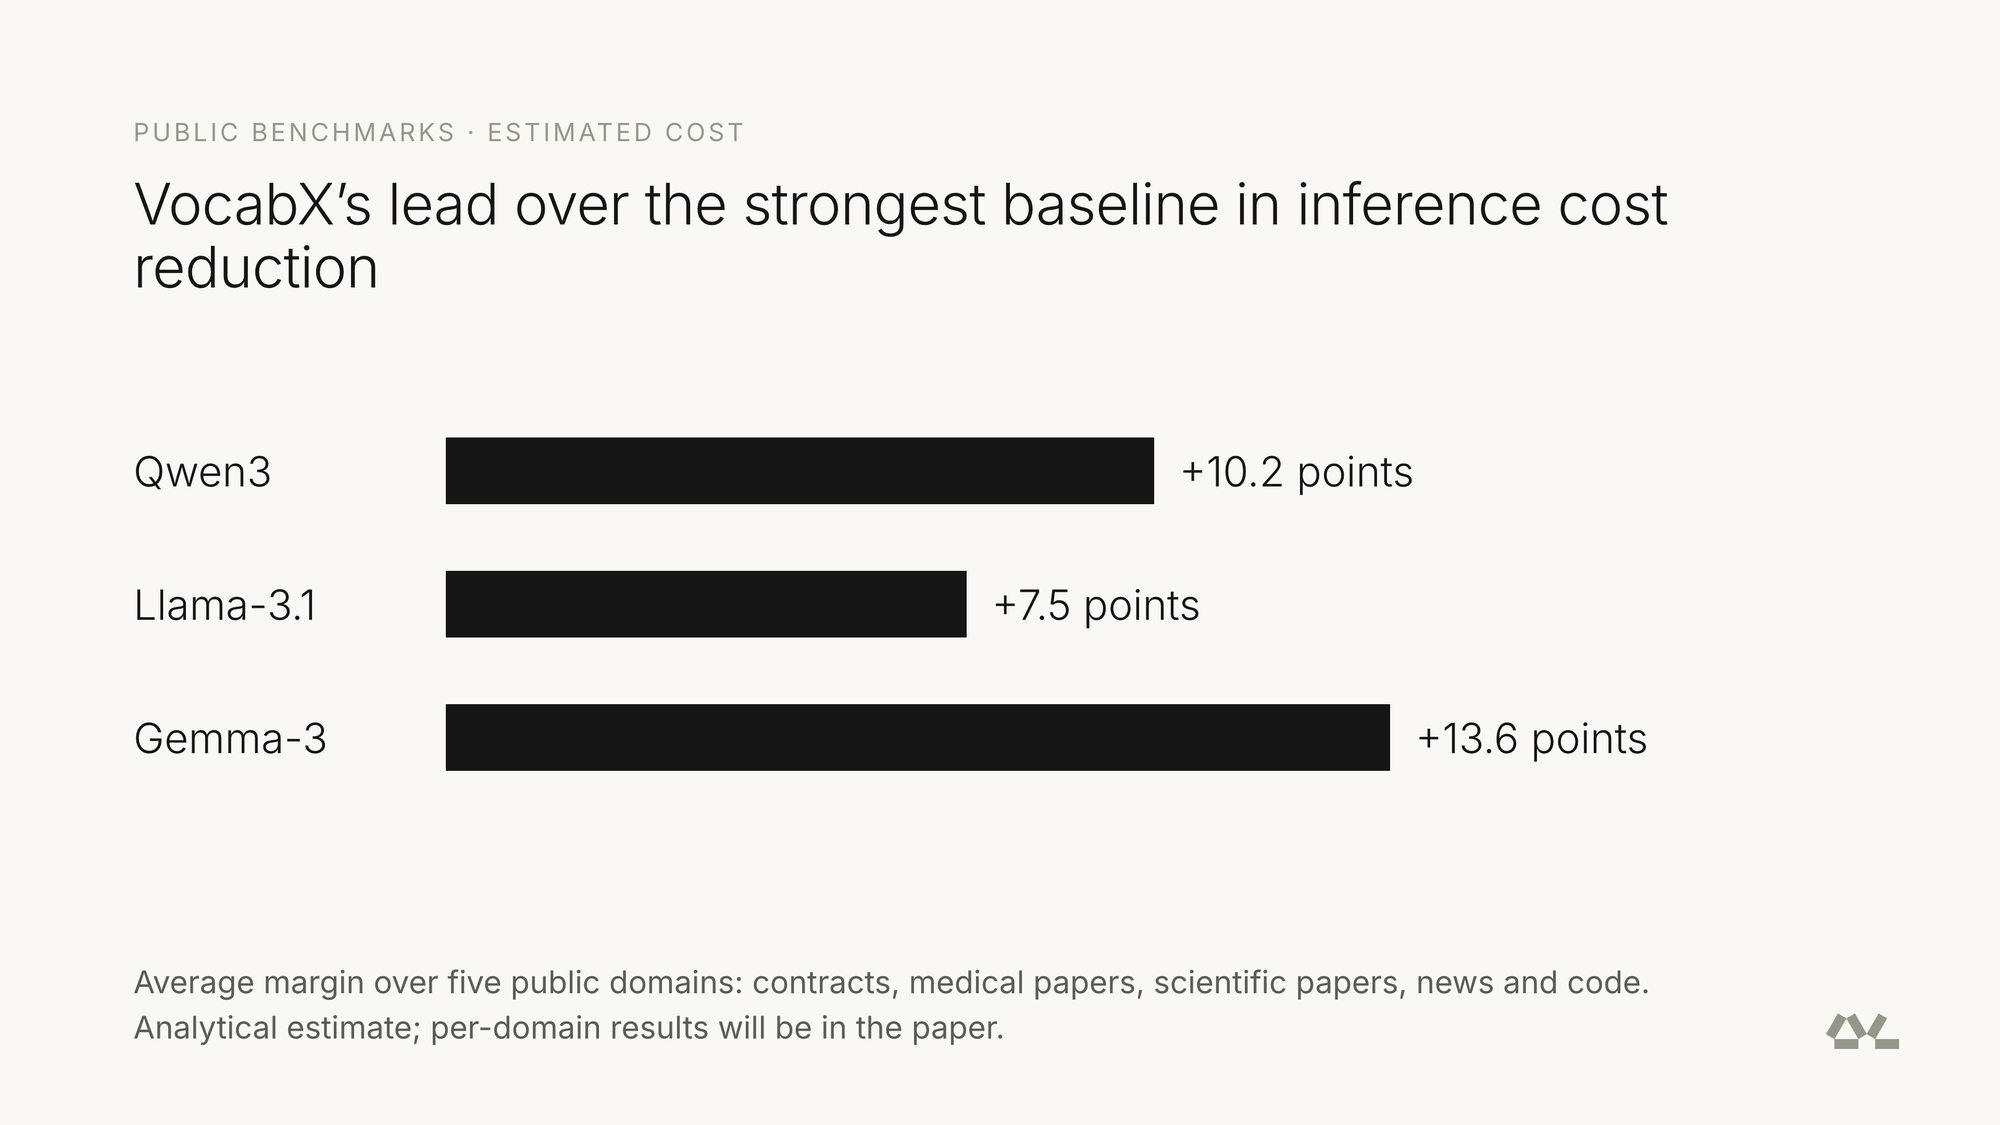
VocabX در هر پانزده ترکیب بیشتر از قویترین روش مرجع فشرده کرد، به میزان ۱.۲ تا ۹.۳ واحد. در هزینهٔ استنتاج برآوردی هم نسخهٔ هرسشدهٔ VocabX در هر پانزده ترکیب پیشتاز بود، با حاشیهٔ میانگین ۱۰.۲ واحد روی Qwen3، ۷.۵ واحد روی Llama-3.1 و ۱۳.۶ واحد روی Gemma-3. در قراردادها، نسخهٔ هرسشده به کاهش ۶۲.۶٪ توکن با ۱۱۳٬۴۲۶ ورودی واژگان رسید، در برابر ۶۱.۸٪ برای بهترین پیکربندی in-place BPE که ۲۰۷٬۸۰۳ ورودی دارد.
پرداخت فقط برای توکنهایی که اهمیت دارند
VocabX مدل را هوشمندتر نمیکند. کاری میکند که مدل دیگر برای متنی که لازم نیست تکهتکه بنویسد هزینه نپردازد و به واژگانی که هرگز استفاده نخواهد کرد امتیاز ندهد. در نمرهدهندهٔ ما، این کار هزینهٔ استنتاج اندازهگیریشده را ۷۷٪ کاهش داد، با همان مدل پایه و همان دستور آموزش.
تخصصیسازی معمولاً با داده و وزنها آغاز میشود. میتواند یک لایه زودتر هم آغاز شود، در واژگان.
روش کامل، جدولهای هر آزمایش و مداخلههای کنارگذاشتهشده در مقالهٔ VocabX خواهد آمد که بهزودی منتشر میکنیم.
منابع
Dharma-AI. "VocabX: Cost-Weighted Vocabulary Adaptation for Domain-Specific Language Models." In preparation (2026).
Gee, Leonidas, et al. "Fast vocabulary transfer for language model compression." EMNLP Industry Track (2022).
Gee, Leonidas, et al. "Multi-word tokenization for sequence compression." EMNLP Industry Track (2023).
Smith, Jimmy T.H., et al. "In-Place Tokenizer Expansion for Pre-trained LLMs." arXiv:2607.15232 (2026).
بیشتر بخوانید
همان خوشه، ۳۳ واحد استفادهٔ بیشتر: آنچه تغییر کرد، ترتیب بود
مدیریت GPU: چرا GPUهای بیکار هواپیمای زمینگیرشدهٔ جدیدند
چرا تخصصیسازی اجتنابناپذیر است
تخصصیسازی بر مقیاس پیروز میشود: متغیر راهبردیای که بیشتر تصمیمهای خرید هوش مصنوعی از آن غافل میمانند
واپاشی متن: یک حالت خرابی در محیط تولید که بیشتر بنچمارکها آن را رصد نمیکنند
Dharma-AI را در Hugging Face ببینید تا دموهای ما را امتحان کنید، مدلهای باز ما را دانلود کنید و ببینید چگونه سیستمهای هوش مصنوعی تخصصی در کاربردهای واقعی سازمانی از مدلهای عمومی بهتر عمل میکنند.