بنچمارک CWE-bench برای آزمودن مرزهای توانمندی سایبری مدلهای پیشرو طراحی شده است. Collinear AI در ادامهٔ تلاش برای جابهجا کردن این مرزها، نسخهٔ دوم CWE-bench را بهصورت مجموعهای عمومی از ۱۰۰ تسک منتشر کرده که هر کسی میتواند آنها را اجرا کند و مدل خود را رویشان بسنجد. ساختار کار همان قبلی است: یک عامل، نسخهای از یک مخزن واقعی متنباز و یک دستور کوتاه دریافت میکند و هدفش یافتن و رفع یک ضعف امنیتی است، بدون آنکه کارکردهای موجود از کار بیفتد. امتیازدهی کاملاً برنامهنویسیشده است؛ بنابراین نتایج قطعیاند و هر کسی میتواند بدون هزینهٔ اضافی آنها را بازتولید کند. همهٔ بررسیهای برنامهنویسیشده با کمک پنلهای داوری مدل زبانی تنظیم شدهاند تا به سمت سختگیری و انصاف پیش بروند. مجموعهٔ نگهداشتهشدهای هم جداگانه نگه میداریم تا بتوانیم پیشرفت را روی تسکهایی پیگیری کنیم که هیچ مدلی آنها را ندیده است. برای ارزیابی مدل خود روی مجموعهٔ نگهداشتهشده با cyber@collinear.ai تماس بگیرید.
هدف ما جامعبودن است. مدافع باید راههای نفوذ مهاجم را پیشبینی کند و هر بار درست عمل کند. این ۱۰۰ تسک ۹۱ CWE مختلف را پوشش میدهند و طیف گستردهای از کلاسهای آسیبپذیری را در بر میگیرند. مدلی که در این مجموعه خوب عمل کند باید سطوح مختلف ضعفی را که مهاجم بالقوه میتواند از آنها سوءاستفاده کند درک کند. تشخیص یک الگوی آشنا کافی نیست.
در تلاش دقیق برای بهبود مستمر کیفیت، برای هر تسک بررسی کردیم که پرسشهای زیر درست باشند:
آیا دستور شبیه یک دستور واقعی است و نه یک موقعیت ارزیابی؟
آیا همهٔ رفتارهای امتیازدهیشده از دل دستور قابل استنباطاند؟
آیا بازبین درستی رفتار را بررسی میکند و نه ساختار خاص یک راهحل مشخص را؟
آیا کد اولیه شکست میخورد و اصلاح مرجع موفق میشود؟
آیا کارکرد اصلی با اصلاح جدید همچنان برقرار است؟
آیا بازبینها راهحلهای حفظشده مانند وصلهٔ شناختهشدهٔ بالادستی را رد میکنند؟
هر تسک بهصورت دستی هم بازبینی شد. عمومیکردن این مجموعه بخشی از همین تلاش برای بهبود کیفیت است. از بازخورد دربارهٔ هر تسک و مشارکت در مجموعهٔ عمومی استقبال میکنیم.
نتایج
نتایج در دو جای Hub پیگیری میشوند. جدول امتیازات در صفحهٔ مجموعهدادهٔ CWE-bench مدلهای با وزن باز را پوشش میدهد و خودکار بهروز میشود: آزمایشگاهها و جامعهٔ کاربران نتیجه را با باز کردن یک PR روی مخزن مدل و افزودن فایل نتایج اضافه میکنند (روش کار). برای مقایسهٔ کامل، از جمله مدلهای فقطAPI مانند Gemini، Claude و GPT، به Space جدول امتیازات CWE-bench مراجعه کنید؛ مدلهای جدید از طریق PR روی همان Space اضافه میشوند.
مدلهای با وزن باز، از صفحهٔ مجموعهداده:
همهٔ مدلهای ارزیابیشده، از جمله مدلهای فقطAPI:
از ۱۱ مدل ارزیابیشده، Gemini 4 Argon با ۶۷٫۸٪ pass@1 و ۸۱٫۰٪ pass@4 پیشتاز است و کمی از Claude Opus 5.5 (۶۷٫۳٪ pass@1 و ۷۸٫۰٪ pass@4) جلوتر است. ۹۵ تسک توسط دستکم یک مدل حل شدهاند؛ نشانهای از اینکه این تسکها واقعاً قابل حلاند. با این حال، حتی مدل صدرنشین هم در ۱۹٪ از مجموعه در هر تلاش شکست میخورد؛ یعنی دنبالهٔ دشوار کارها هنوز حلنشده باقی مانده است. مجموعهٔ عمومی، ارزیاب و هارنس باز هستند. مدل خود را اجرا کنید و بگویید کجای این جدول قرار میگیرد.
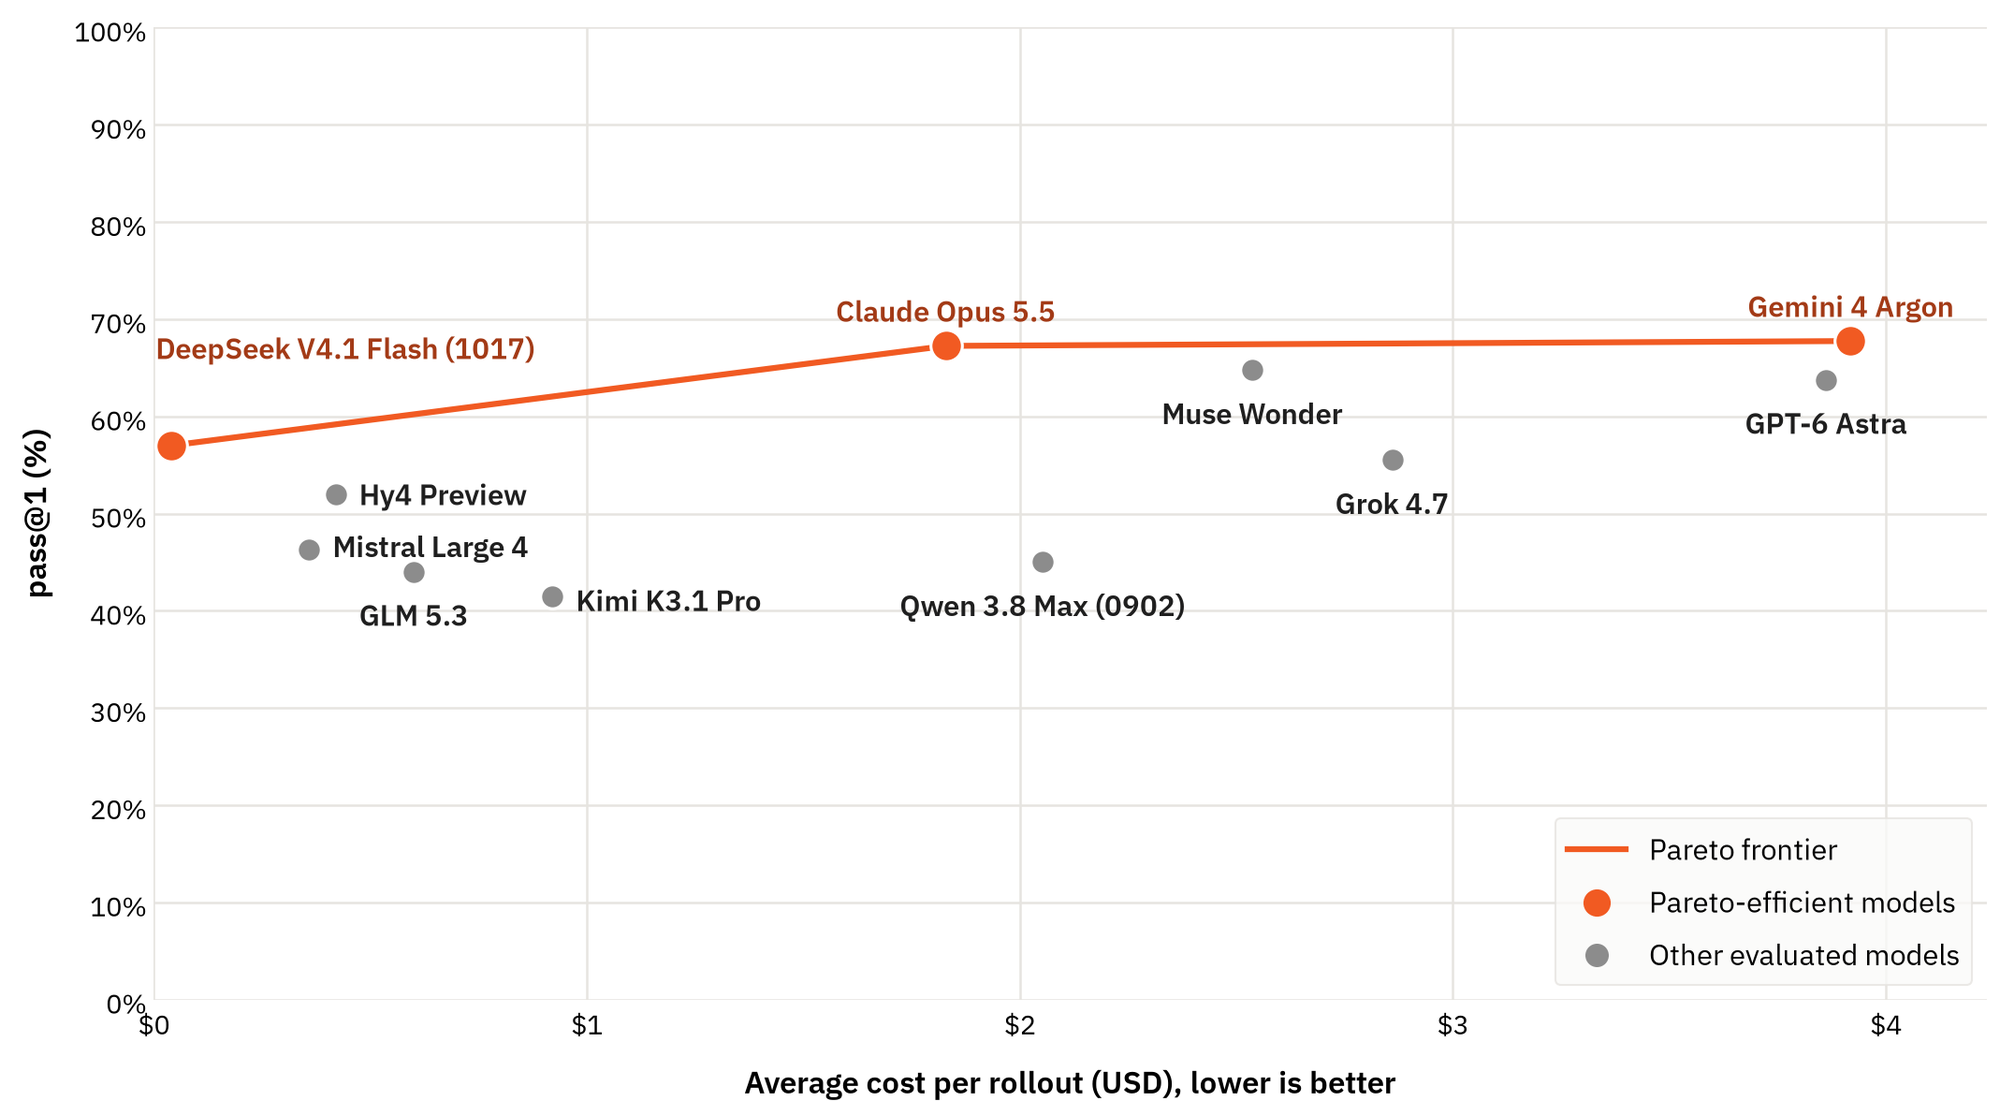
از نظر هزینه، DeepSeek V4.1 Flash (1017)، Claude Opus 5.5 و Gemini 4 Argon مرز پارتو را تشکیل میدهند: DeepSeek با ۰٫۰۴ دلار بهازای هر اجرای تلاش به ۵۷٫۰٪ pass@1 میرسد، Opus با ۱٫۸۳ دلار ده واحد درصد به آن اضافه میکند و Gemini با ۳٫۹۲ دلار کمی جلوتر میافتد.
اجرا از Hub
هر تسک یک تسک مستقل Harbor است (یک محیط داکریشده، یک دستور و یک بازبین قطعی) و مجموعهداده یک registry.json هم همراه دارد. بنابراین Harbor میتواند کل بنچمارک را مستقیماً از مخزن Hugging Face اجرا کند، بدون آنکه خودتان چیزی را کلون کنید:
harbor run --repo "https://huggingface.co/datasets/collinear-ai/cwe-bench" -d cwe-bench@2.0 -k 4 \
  --agent <agent> --model <model> --env docker \
  --allow-agent-host <model API host>
پرچم -k 4 برای هر تسک ۴ تلاش انجام میدهد و امتیاز گزارششده میانگین پاداش روی همهٔ ۴۰۰ تلاش است. مجموعهداده دسترسیمحدود است: ابتدا شرایط دسترسی را در صفحهٔ مجموعهداده بپذیرید. Harbor تسکها را با git دریافت میکند، پس توکن HF خود را یک بار در credential helper گیت ذخیره کنید:
hf auth login --token $HF_TOKEN --add-to-git-credentialتسکها برچسب rl-environment هم دارند: همان محیطها و بازبینها میتوانند پاداش آموزش عاملهای دفاعی را فراهم کنند، نه فقط برای ارزیابی آنها.