اگر از یک مدل فرانتیر (پیشرو) یک اسلاید بخواهید، اسلاید خوبی تحویل میگیرید. اما اگر ده اسلاید بخواهید، کمکم شبیه هم میشوند: همان پیشفرضهای خوشسلیقه، همان سبک اختصاصی، و ظاهری که بوی «اسلاید ساختهشده با هوش مصنوعی» میدهد. تا وقتی که نمیخواهید اسلاید شبیه قالب خودتان باشد، این وضعیت مشکلی ندارد. مدلهای فرانتیر سبک اختصاصی خودشان را دارند و هرچه هم در پرسش (prompt) تأکید کنید، باز به همان سبک برمیگردند. از این گذشته، گاهی محتوا محرمانه است و به هیچ وجه نباید از سیستمهای شما خارج شود.
هر دو مورد به مدلی اشاره میکند که خودتان در اختیار دارید: وزنهای متنباز، اجرا روی زیرساخت خودتان و آموزشدیده با زبان طراحی خودتان. اما نکتهٔ دشوار این است که مدلهای کوچک متنباز، همانهایی که واقعاً میتوانید روی سرور خود میزبانی کنید، در این کار ضعیفاند. اسلایدهایشان خراب از کار درمیآید: عنوانهایی که در پسزمینه محو میشوند، متنی که از لبهٔ اسلاید بیرون میزند و شکلهایی که روی هم میافتند.
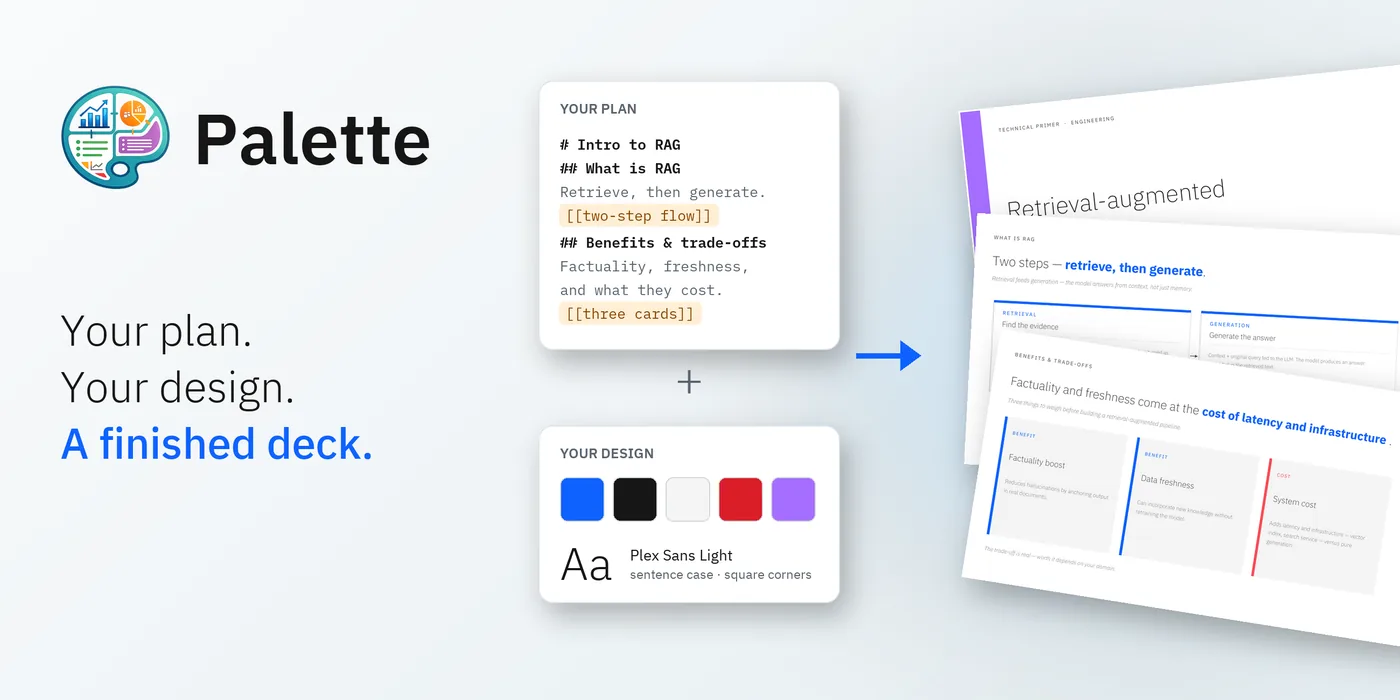
Palette یک فرض را میآزماید: مدل کوچک متنباز ۲۰B که با داده مصنوعی در زبان طراحی شما آموزش دیده و یک هارنس (چارچوب بررسی و تعمیر) خروجیاش را بررسی میکند، میتواند با سیستمهای فرانتیر رقابت کند، در حالی که مالکیت نتیجه در دست شما میماند. ما یک مدل ۲۰B را به شیوهای که انسانها اسلاید میسازند تنظیم دقیق کردیم: یک طراح اسلاید را برنامهریزی میکند و یک کدنویس هر اسلاید را میکشد. داده آموزشی آن از زبان طراحی IBM (IBM Design Language) پیروی میکند و در PresentBench در دو حوزه از سه حوزهای که سنجیدیم رتبه اول را کسب کرده است. این مطلب توضیح میدهد داده را چگونه ساختیم، مدل را چگونه آموزش دادیم و چگونه هارنسی پیرامون آن ساختیم.
چرا ساخت اسلاید برای مدلهای کوچک دشوار است
یک اسلاید در ظاهر ساده است، اما ساختنش از مدل میخواهد سه کاری را انجام دهد که مدلهای کوچک در آنها ضعیفاند.
اسلاید را بدون دیدن آن میچیند. مدل اسلاید نمیکشد؛ کدی مینویسد که هر عنصر را با مختصات x و y، عرض و اندازه فونت قرار میدهد. اینکه آیا یک عنوان ۷۵ کاراکتری با فونت ۵۶ در دو خط جا میشود، محاسبهای است که مدل در ذهن خود انجام میدهد و تنها پس از رندر شدن کد میفهمد اشتباه کرده است. مدلهای کوچک اغلب این را اشتباه میکنند و شکلهای رویهمافتاده و متن بیرونزده از اسلاید از همینجا میآید.
همزمان دو نوع تصمیم میگیرد. تصمیم درباره اینکه هر اسلاید چه میگوید و چگونه نشان داده شود (نمودار یا جدول؟ چه چیزی حذف شود؟) قضاوت تحریریهای است. جایگذاری دقیق آن، هندسه است. یک پاس واحد باید هر دو را در ۱۰ تا ۲۰ اسلاید انجام دهد و در این میان پالت رنگ، تایپوگرافی و چیدمان را نیز یکدست نگه دارد.
دادهای وجود ندارد که نشان دهد اسلایدها چگونه ساخته میشوند. اسلایدهای آمادهٔ زیادی وجود دارد، اما نه منطق پشت انتخابهای طراحی و نه کدی که آنها را تولید کرده است.
مثل انسان بسازید: یک طراح و یک کدنویس
هیچکس اسلاید را در یک پاس نمیسازد. اول داستان را تعیین میکنید (چند اسلاید، هر کدام چه میگوید، کدام نمودار میگیرد و کدام جدول) و تنها بعد از آن هر اسلاید را میسازید. Palette کار را به همین شکل تقسیم میکند: دو نقش که هر دو با یک آداپتور LoRA انجام میشوند:
طراح پلن را میخواند و یک بریف ساختاریافته JSON مینویسد: پالت رنگ، سیستم تایپوگرافی و برای هر اسلاید چیدمان، محتوای دقیق و یک دلیل طراحی کوتاه.
کدنویس مشخصات یک اسلاید را از بریف میگیرد و کد JavaScript مبتنی بر pptxgenjs را که آن را میکشد مینویسد، و پیش از آن استدلال خود را میآورد.
اکنون هر نقش یک نوع تصمیم میگیرد: طراح قضاوت تحریریهای را بر عهده دارد و کدنویس هندسه را. بریف میان آنها خوانا و قابل ویرایش است، بنابراین یک انسان یا یک عامل میتواند چیدمان یک اسلاید را بدون بازتولید کل اسلاید تغییر دهد. و چون بافت هر اسلاید پیش از نوشتن هر کدی تثبیت میشود، فراخوانیهای کدنویس بهصورت موازی و یکی برای هر اسلاید اجرا میشوند، که مرحله کدنویسی را حدود ۶ تا ۷ برابر سریعتر میکند.
ما آداپتور را با LoRA و نه تنظیم دقیق کامل آموزش دادیم: این روش یک قالب و یک مهارت را روی یک مدل پایه توانمند میآموزد بدون اینکه دانش موجود مدل پایه را مختل کند، و هر آزمایش را ارزانتر کرد. یک درس: نمونههای کدنویس حدود ۵ برابر طولانیتر از نمونههای طراح هستند، بنابراین ترکیب سادهلوحانه باعث آموزش ناکافی طراح شد تا زمانی که نمونههایش را ۵ برابر بیشنمونهگیری کردیم.
ساخت مصنوعی اسلایدها و استدلال پشت آنها
هیچ پیکره عمومی از پلنها، تصمیمهای طراحی و کد اسلاید وجود ندارد، بنابراین یکی با یک معلم بزرگ متنباز تولید کردیم. هر اسلاید از یک دستورالعمل شروع میشود که ژانر، طول، چیدمانها و هر دستور کاربر را تعیین میکند، تا کنترل کنیم داده چه چیزهایی را پوشش میدهد. پلنها از فهرستهای مرتب تا انبوه محتوای خام متغیرند، تا مدل یاد بگیرد حذف و خلاصه کند. حدود ۱۰۰۰ اسلاید ساختیم که تقریباً ۱۰,۰۰۰ اسلاید را پوشش میدهد.
هر نمونه همچنین استدلال پشت خود را دارد که به شکل پادواقعی (counterfactual) نوشته شده است: ردپا یک گزینه جایگزین را میسنجد و میگوید چرا رد شد، تا مدل قاعده پشت یک انتخاب را یاد بگیرد، نه فقط خود انتخاب را. طراح درباره محتوا و فرم استدلال میکند. برای مثال:
«درآمد برای چهار فصل، با یک روند صعودی روشن. جدول را در نظر گرفتم، اما نکته این اسلاید روند است نه ارقام دقیق، بنابراین نمودار میلهای آن را در یک نگاه قابل مشاهده میکند.»
کدنویس درباره هندسه استدلال میکند:
«عنوان ۶۲ کاراکتر است. با فونت ۴۴ به سه خط میشکست و به نمودار زیرین میرسید، بنابراین آن را روی ۳۶ تنظیم کردم که در دو خط جا میشود و بالای نمودار فضای کافی باقی میگذارد.»
معلم بهتنهایی داده را خوب نمیکند؛ حلقهای که پیرامون آن است این کار را میکند. هر اسلاید ساختهشده رندر میشود و همان بررسیکنندهای که هارنس در زمان استنتاج استفاده میکند، آن را از نظر همپوشانی و سرریز بررسی میکند. اسلایدهای خراب تعمیر میشوند و استدلالشان به همان شکل پادواقعی بازنویسی میشود، شامل اینکه چیدمان اصلی چه اشتباهی داشت و چرا اصلاح کار میکند. هر اشتباهی که بررسیکننده میگیرد به نمونه آموزشی بهتری تبدیل میشود.
سختترین مسئله وفاداری بود. بدترین خطا اسلایدی است که واقعیتهایی دارد که در ورودی نبودهاند، و دریافتیم که یک قاعده در پرسش نمیتواند از آن جلوگیری کند. اگر بریفی جدول شش در پنج بخواهد اما فقط سه گلوله داشته باشد، کدنویس باید بقیه را از خود بسازد.
چیزی که این را حل کرد اسلایدهای مرجع بود، نه قواعد: اصلاح یک مرجع بهطور قابل اتکا خروجی معلم را تغییر میداد، در حالی که افزودن یک قاعده بهندرت چنین میکرد. معلم چند اسلاید مرجع را در پرسش خود میبیند و بسیار بیشتر از آنکه از دستورها پیروی کند، از آنها کپی میکند.
هدایت اسلاید با زبان ساده
کاربران اغلب کنترل دقیقتری روی انتخابهای طراحی مشخص میخواهند: نمودار به جای جدول، یک رنگ خاص، جلد تیرهتر. Palette به آنها اجازه میدهد این را با دستورها (directives) بخواهند؛ دستورهای کوتاهی که مستقیماً در پلن نوشته و در [[ ]] قرار میگیرند:
## Rollout plan
- March: pilot with two teams
- May: security review complete
- July: rollout to all of engineering
- September: company-wide launch
- November: first adoption review
[[make this a timeline]]
طراح هر دستور را در بریف میگنجاند و کدنویس هنگام کشیدن اسلاید از آن پیروی میکند. بدون دستور، مدل بهطور منطقی این نقاط عطف را به شکل جدول نشان میداد؛ با آن، مدل به جای جدول یک خط زمانی میکشد.
مدل از دستورها پیروی میکند چون برای این کار آموزش دیده است. دستورالعملهای داده شامل دستورهایی از ۱۲ دسته است که چند نمونه از آنها در ادامه آمده، هر کدام به چند شکل مختلف بیان شدهاند، تا مدل قصد را یاد بگیرد نه یک عبارت ثابت را.
دسته | نمونه دستور
چیدمان | [[این را به یک خط زمانی تبدیل کن]]
لحن | [[صریح باش، بدون پردهپوشی]]
مخاطب | [[این برای هیئتمدیره است]]
ترتیب | [[با درخواست شروع کن]]
حذف | [[قیمتگذاری نباشد]]
تأکید | [[عدد اصلی را برجسته کن]]
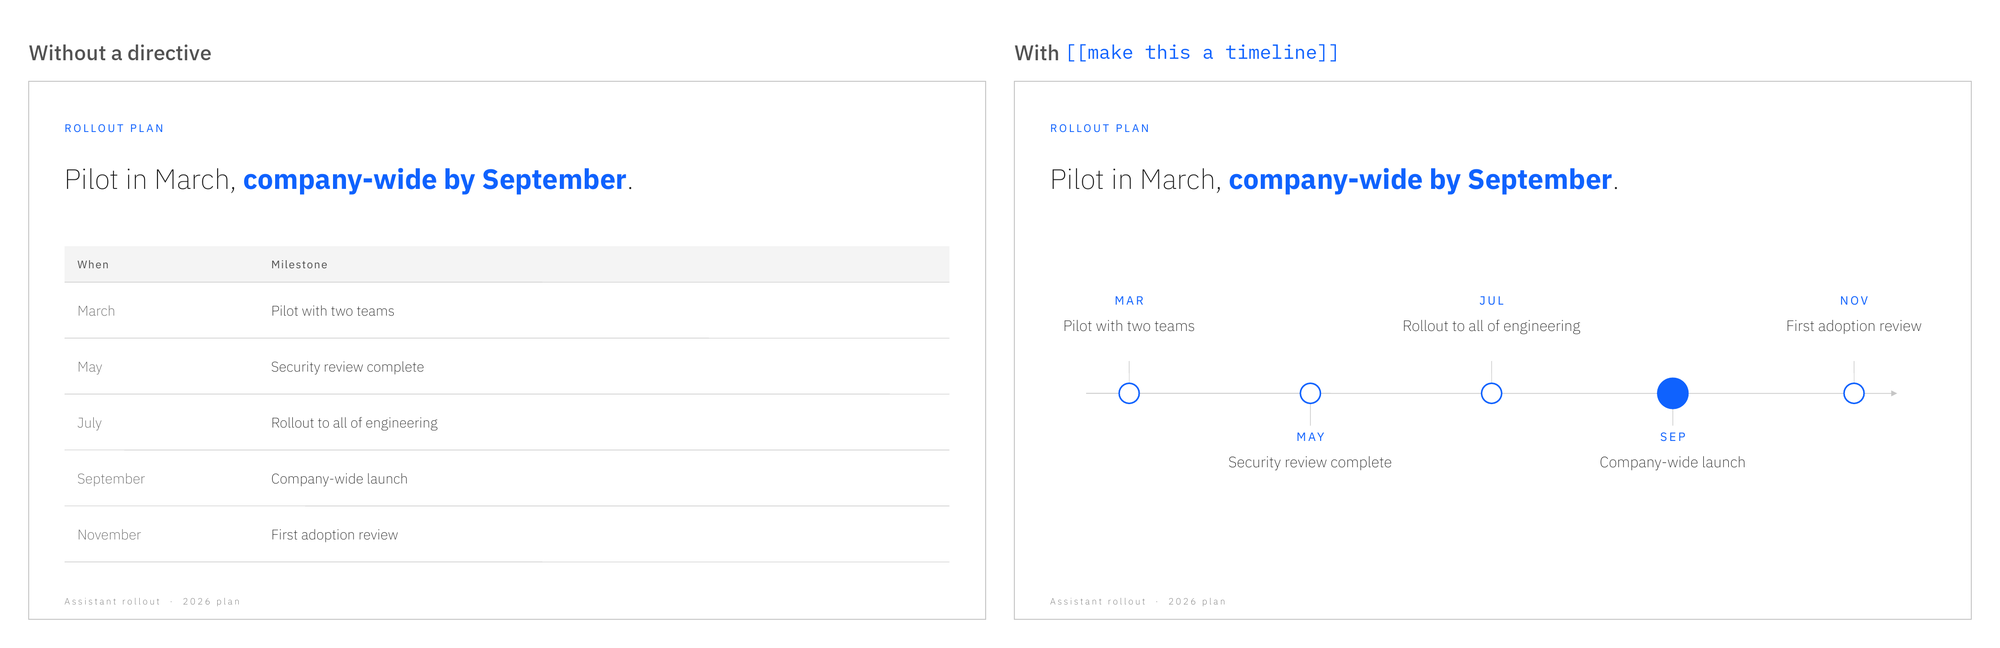
شکل ۱. نمایشی از همان پلن بدون دستور (چپ) و با دستور [[این را به یک خط زمانی تبدیل کن]] (راست).
ساخت هارنس بررسی و تعمیر
حتی یک مدل خوب آموزشدیده هم گاهی اسلاید خراب تولید میکند: عنوانی همرنگ پسزمینه، یا دو کادر که روی هم میافتند. بنابراین Palette خروجی مدل را مستقیم برنمیگرداند؛ هر دک ابتدا از یک هارنس عبور میکند.
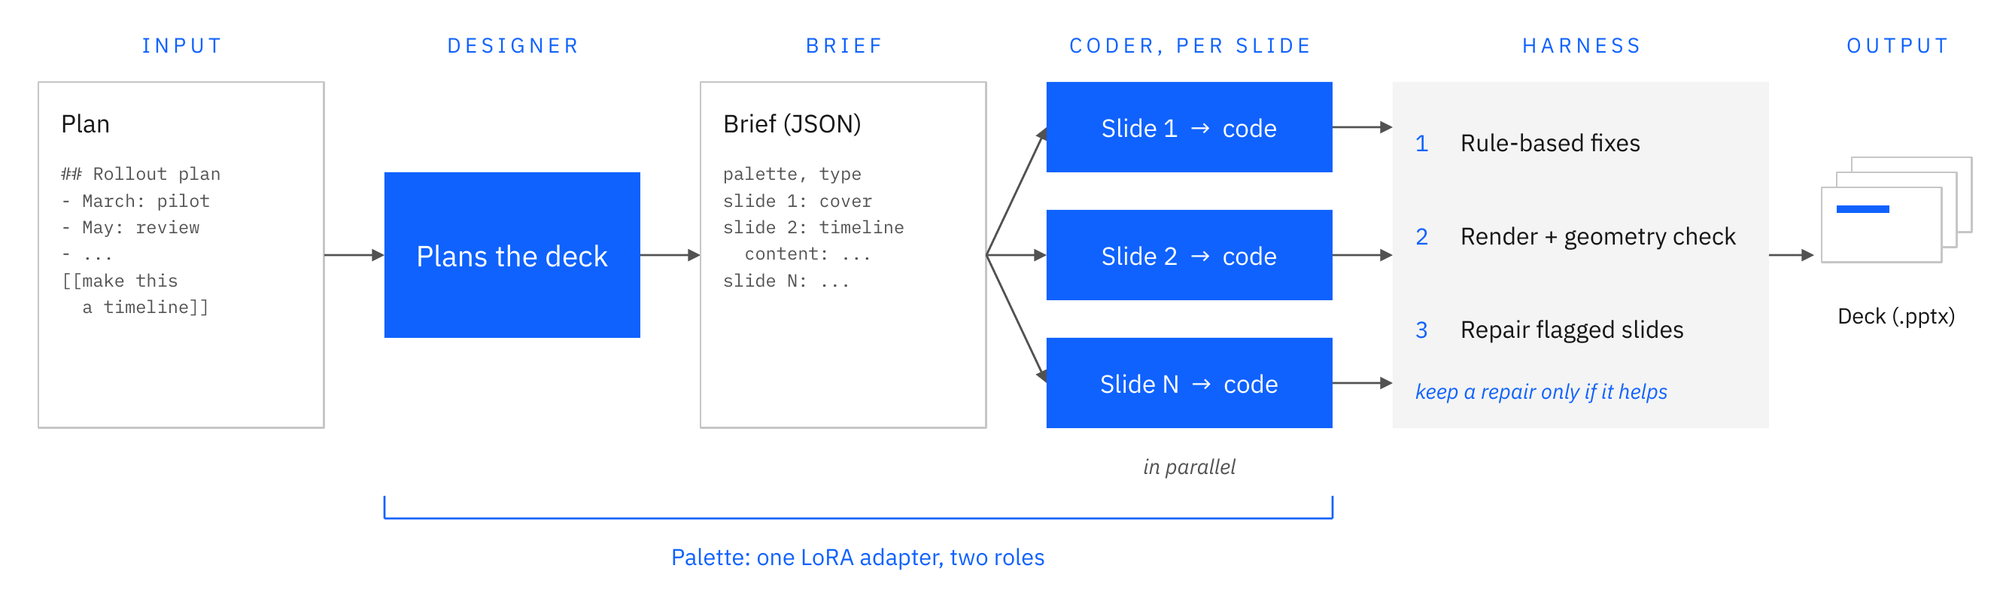
شکل ۲. طراح بریف را مینویسد، کدنویس کد هر اسلاید را بهصورت موازی مینویسد، و هارنس هر اسلاید را پیش از تحویل دک بررسی و تعمیر میکند.
ابتدا قواعد ساده اشتباهات شناختهشده را اصلاح میکنند، مانند کد رنگ بدشکل که در غیر این صورت همه اسلایدها را سیاه میکرد. سپس هر اسلاید رندر و اندازهگیری میشود: یک بررسیکننده هندسه، متنی را که همپوشانی دارد، بریده میشود یا از اسلاید بیرون میزند علامتگذاری میکند. اسلایدهای علامتخورده به یک مدل ویرایشگر جداگانه میروند که کد آن اسلاید را بازنویسی میکند.
قاعده کلیدی این است که بازنویسی تنها وقتی نگه داشته میشود که بررسیکننده تأیید کند اسلاید بهتر شده است؛ در غیر این صورت نسخه اصلی میماند. این کار هارنس را برای اجرا روی هر دک ایمن میکند. میتواند اسلایدی را درست کند، اما نمیتواند آن را بدتر کند.
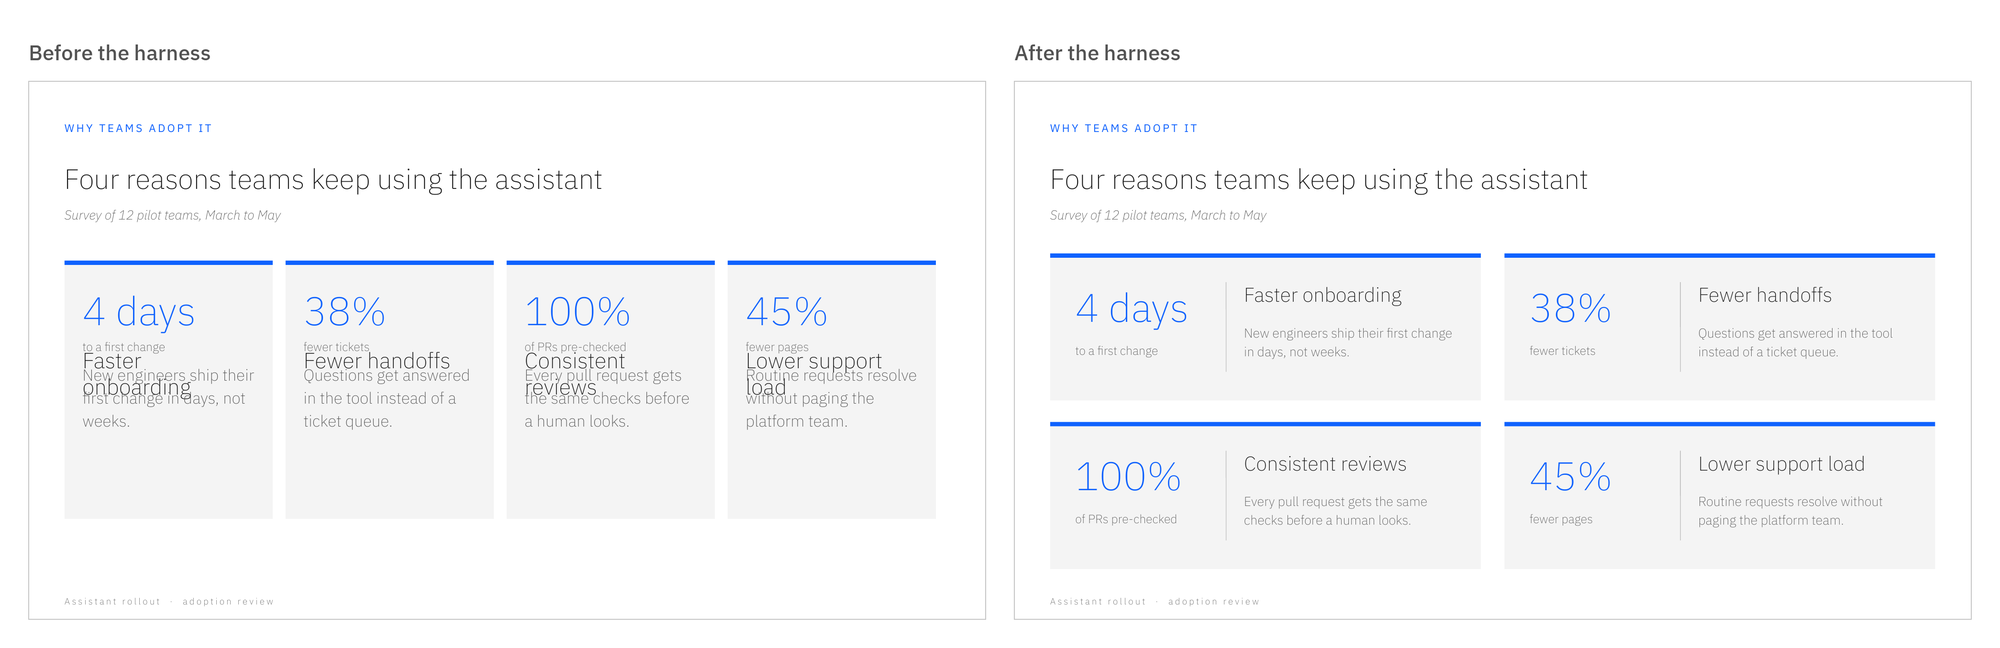
شکل ۳. نمایشی از یک تعمیر. در حالت تولیدشده (چپ)، عنوان هر کارت روی توضیحاتش افتاده است؛ هارنس همپوشانیها را تشخیص میدهد و کارتها را به یک شبکه ۲×۲ بازچینش میکند (راست).
برای سنجش اثر آن، هر دک PresentBench را یک بار تولید کردیم و آن را با و بدون هارنس امتیاز دادیم. در ۱۳۱ دک، هارنس بهطور میانگین ۳.۵ امتیاز اضافه میکند.
ارزیابی
ما روی PresentBench ارزیابی میکنیم که دکهای تولیدشده را بر پنج معیار میسنجد: اصول پایه، طراحی بصری، کامل بودن، درستی و وفاداری. PresentBench به جای پلن یک سند منبع ارائه میدهد، بنابراین برای این اجراها یک مدل فرانتیر جداگانه هر پلن را از سند خود پیشنویس کرد و Palette دک را از آن پلن ساخت. ما سه حوزه را گزارش میکنیم؛ اعداد خط پایه از مقاله PresentBench است.
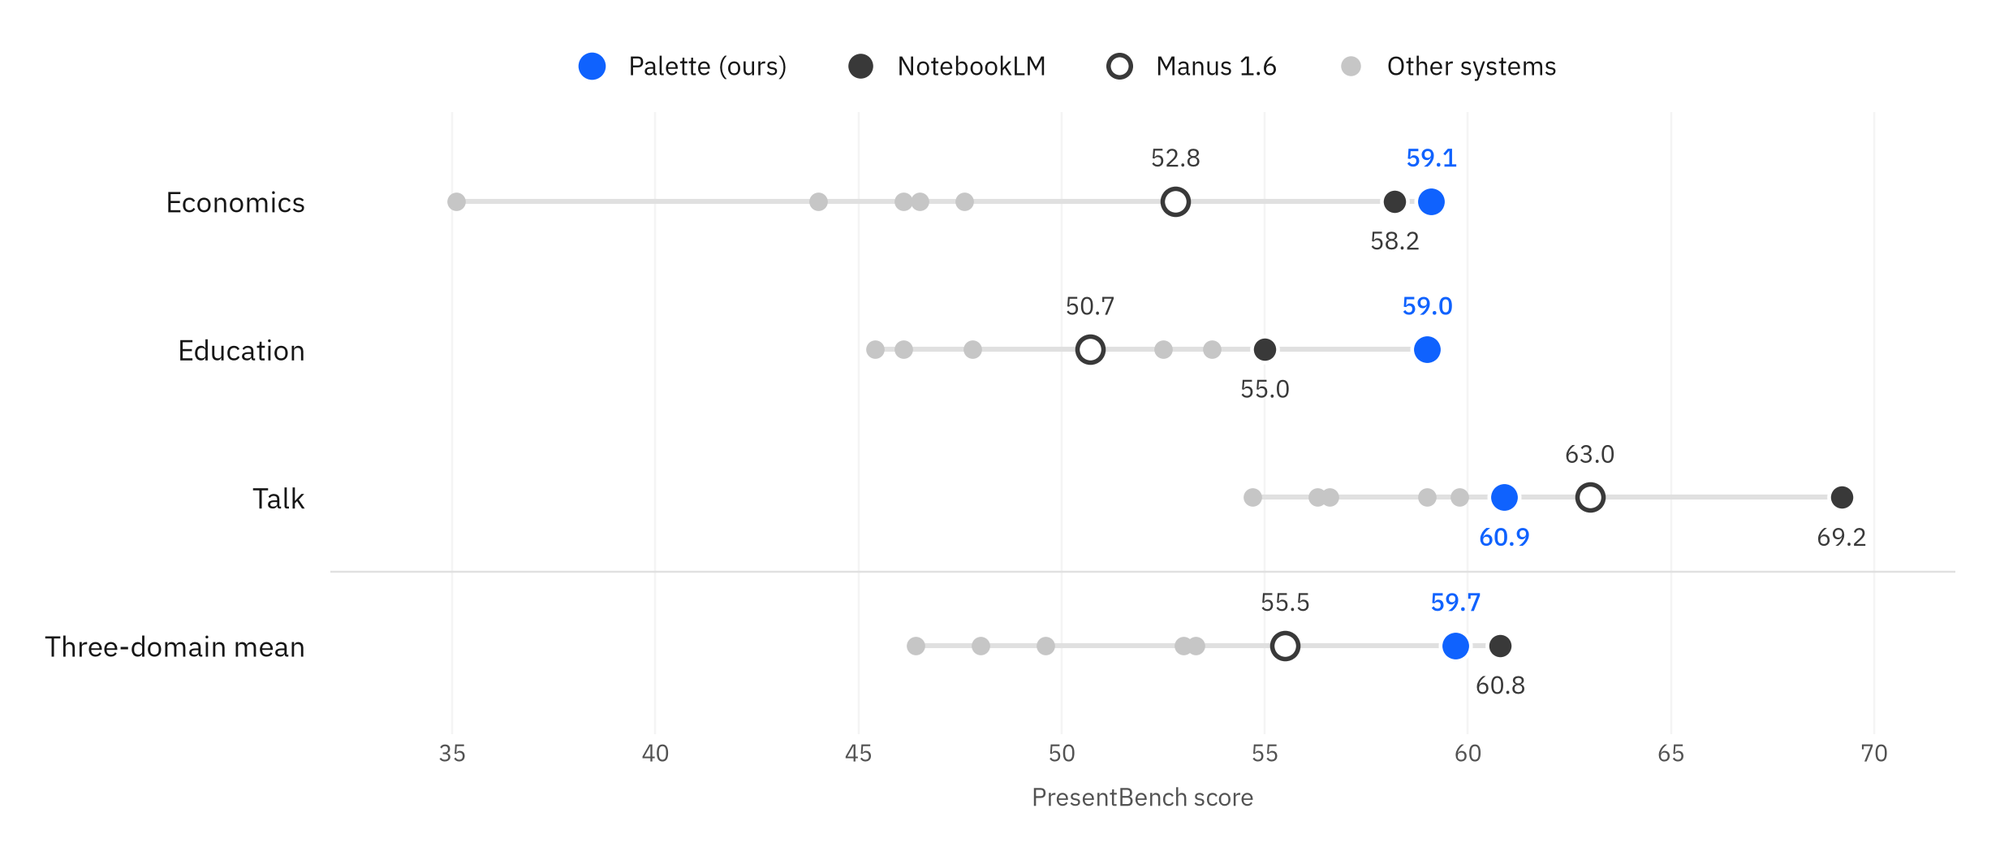
شکل ۴. امتیازهای PresentBench به تفکیک حوزه. Palette (آبی) در برابر NotebookLM، Manus 1.6 و پنج سیستم دیگر (خاکستری). Palette در Economics و Education رتبه اول، در Talk رتبه سوم و در میانگین سه حوزه رتبه دوم را دارد.
Palette جایی بهترین عملکرد را دارد که محتوای ساختاریافته و دقت عددی امتیاز را تعیین میکند و در Economics و Education رتبه اول را کسب میکند. در Talk که دکها روایی و مبتنی بر گفتارند، دو سیستم بسته امتیاز بالاتری میگیرند و Palette سوم میشود. در میان سه حوزه رتبه دوم را دارد، با ۱.۱ امتیاز اختلاف پشت NotebookLM (۵۹.۷ در برابر ۶۰.۸) و جلوتر از بقیه رقبا، بهعنوان یک مدل متنباز ۲۰B واحد.
PresentBench میسنجد که آیا یک دک خوب است یا نه، اما نمیسنجد که آیا از یک زبان طراحی مشخص پیروی میکند. ما از بنچمارکی که این کار را بکند آگاه نیستیم و این شکافی است که امیدواریم به پر کردنش کمک کنیم.
قدم بعدی
هارنس در حال حاضر سیگنالهای ارزان و قابل راستیآزمایی را محاسبه میکند: آیا اسلاید رندر میشود، آیا چیزی همپوشانی یا سرریز دارد، آیا هر واقعیت به بریف برمیگردد. امروز از آنها برای تعمیر خروجی پس از تولید استفاده میکنیم. در قدم بعدی میخواهیم از همین بررسیها بهعنوان پاداش برای یادگیری تقویتی استفاده کنیم، تا مدل از همان ابتدا این اشتباهات را نکند. چون کدنویس هر بار یک اسلاید را کار میکند، هر اسلاید یک رولاوت (اجرای مستقل) کوتاه و مستقلاً قابل بررسی است، که برای آموزش به سبک GRPO مناسب است.
همچنین میخواهیم شکاف دکهای پرشکل را با استخراج شکلها از اسناد منبع (مثلاً با Docling) و جایگذاری آنها با هارنس پر کنیم. و در حال بررسی راه سبکتری برای آوردن قالبهای خودتان هستیم: بازپوشش خروجی از یکی دو فایل .pptx موجود شما، بدون آموزش مجدد.
آنچه آموختیم
ساخت Palette چند روش مؤثر را به ما آموخت که بهطور طبیعی به کارهای دیگری که خروجیشان ساختاری قابل بررسی در کد دارد گسترش مییابد، از نمودارها و دیاگرامها تا چیدمان رابط کاربری:
استدلال را در داده بگذارید. آموزش بر اساس اینکه چرا یک انتخاب انجام شد، از جمله اینکه چه چیزی رد شد، بیش از خود انتخاب میآموزد.
نمونهها را اصلاح کنید پیش از آنکه قاعدهای اضافه کنید. وقتی معلم چیزی را اشتباه میگرفت، اولین واکنش ما افزودن یک قاعده به پرسش آن بود و این بهندرت کمک میکرد. معلم بسیار بیشتر از آنکه از دستورها پیروی کند از دکهای مرجعش کپی میکرد، بنابراین اصلاح مرجع چیزی بود که واقعاً خروجیاش را تغییر داد.
تعمیرها را بهطور پیشفرض ایمن کنید. اصلاحی که تنها وقتی نگه داشته میشود که بهطور قابل اندازهگیری کمک کند، میتواند روی هر خروجی اجرا شود.
اول بررسیکننده را بسازید. این همان چیزی است که داده را قابل اتکا و خروجیها را برای تحویل ایمن میکند.