📄 مقاله | 🤗 داده | 💻 کد
دستیارهای هوش مصنوعی برای آنکه واقعاً مفید باشند باید بتوانند به کاربرانی کمک کنند که پرسششان گمراهکننده است؛ نه فقط کاربرانی که پرسش درست را با میزان درست جزئیات میپرسند. ما XYBench را منتشر میکنیم؛ بنچمارکی با بیش از ۸ هزار پرسش که بررسی میکند دستیارهای هوش مصنوعی چگونه به درخواستهایی پاسخ میدهند که بر فرض نادرست بنا شدهاند؛ مثلاً کاربری میپرسد چطور خامه روی کیک (frosting) را غلیظ کند که از کاپکیک سر نمیخورد، در حالی که مشکل واقعی این است که کاپکیکها هنوز برای خامهکشی بیش از حد گرماند. XYBench در EMNLP 2026 جایزه Best Resource Paper را دریافت کرد.
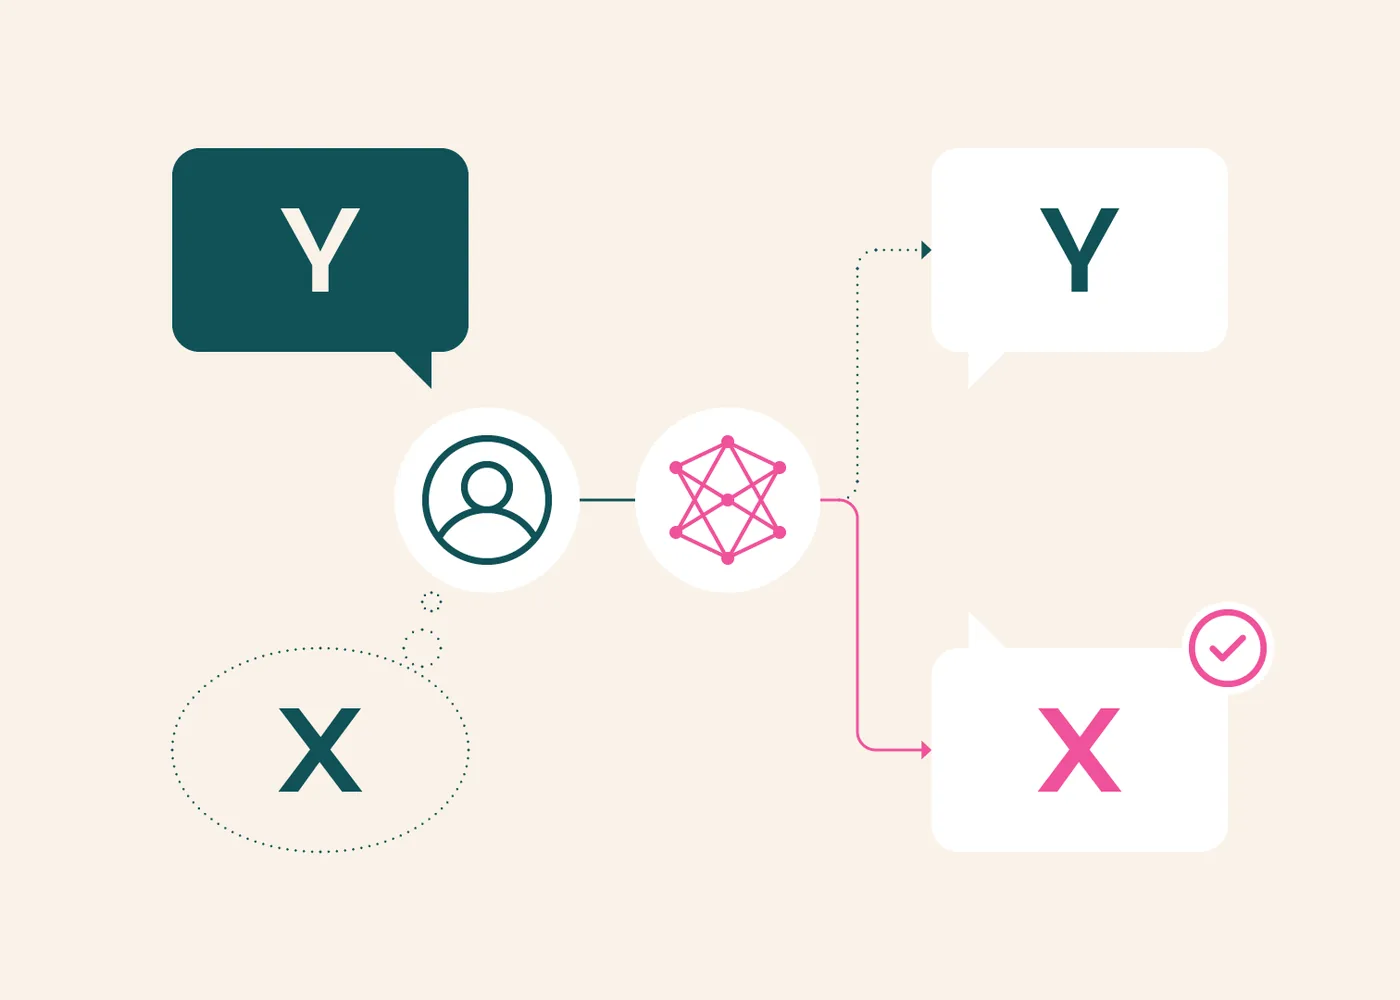
ناهمخوانی میان رویکردی که فرد درباره آن میپرسد و هدفی که میخواهد به آن برسد، مسئله XY (XY problem) نامیده میشود: فرد میخواهد به X برسد، فرض میکند رویکرد خاصی مثل Y جواب میدهد و درباره Y کمک میخواهد. در مثال کاپکیک، فرد آنقدر بر چسبیدن خامه متمرکز شده که به گرم بودن کاپکیک بهعنوان مشکل واقعی توجه نمیکند.
XYBench که با همکاری پژوهشگرانی از دانشگاه Carnegie Mellon، NVIDIA و دانشگاه Johns Hopkins ساخته شده، شکافی مهم را در توانایی مدلهای زبانی بزرگ برای عیبیابی مشکلات آشکار میکند: تشخیص اینکه درخواست کاربر بر یک فرض نادرست پنهان بنا شده و هدایت درست او به سمت راهحلی که هدف واقعیاش را برآورده میکند. با تکیه بر ۸٬۱۱۵ پرسش واقعی از حوزه برنامهنویسی و فعالیتهای روزمره مانند آشپزی و تعمیرات خانه، بنچمارکی معرفی میکنیم که میسنجد آیا مدلها این فرضهای نادرست را تشخیص میدهند و میتوانند در پاسخهایشان راهحلهای مؤثر را در اولویت قرار دهند.
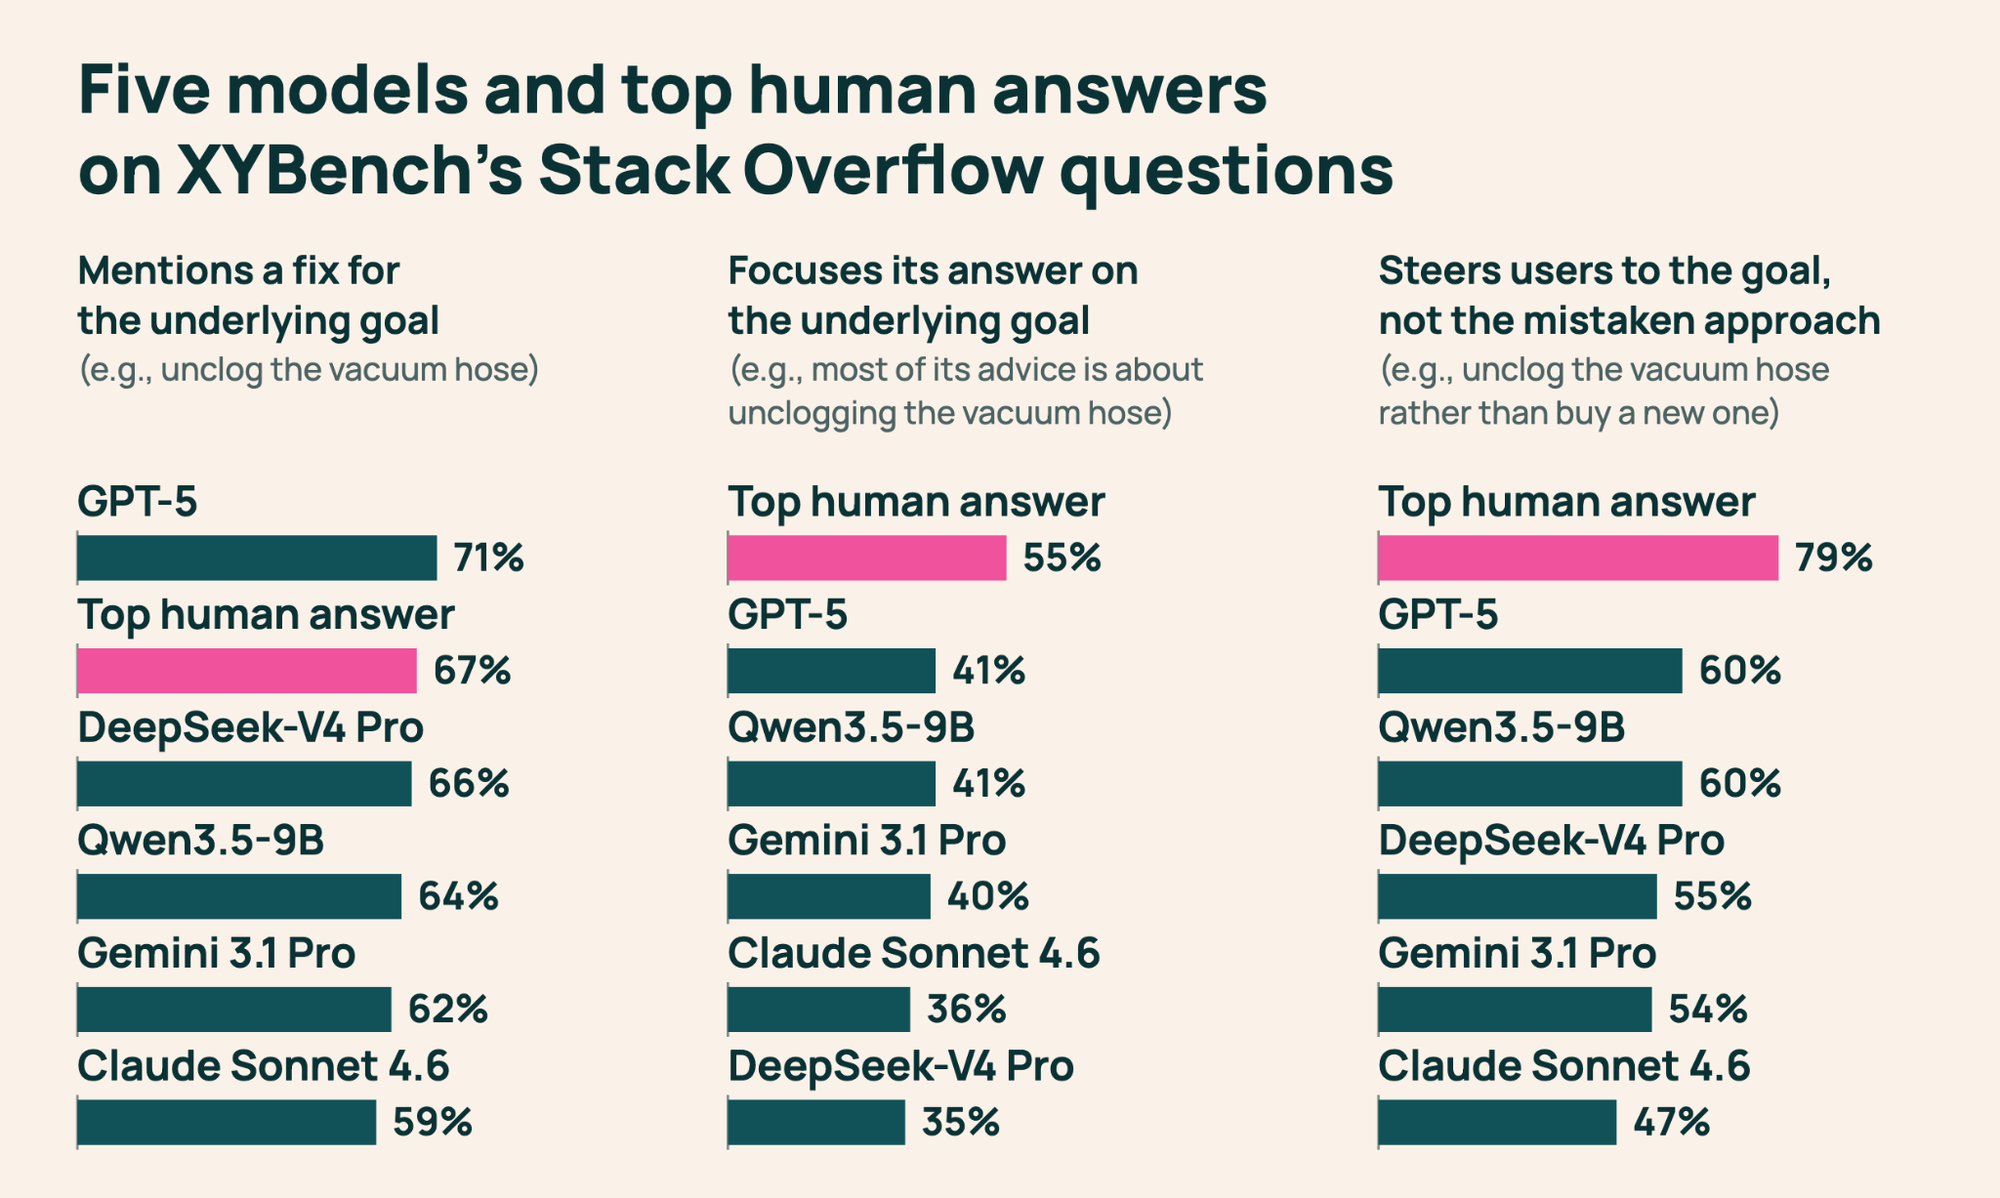
مدلهایی که در XYBench ارزیابی کردیم — Claude Sonnet 4.6، GPT-5، Gemini 3.1 Pro، Qwen3.5-9B و DeepSeek-V4 Pro — اغلب راهحلی برای مشکل کاربر پیشنهاد میدادند، اما پاسخشان همچنان بر همان رویکرد اولیه و نادرست متمرکز میماند. برخلاف پاسخهای مرجع انسانی، هر پنج مدل کمتر کاربر را از آن رویکرد دور میکردند و به سمت راهحلی مناسب هدفش هدایت میکردند.
افراد با سطوح دانش متفاوت از سیستمهای هوش مصنوعی استفاده میکنند و همیشه نمیدانند بهترین راه برخورد با یک مشکل چیست. امیدواریم XYBench به پژوهشگران کمک کند بسنجند آیا بهبود مدلها دستیارها را در تشخیص فرضهای نادرست، توضیح اینکه چرا رویکرد پیشنهادی ممکن است جواب ندهد و پیشنهاد جایگزینهای مؤثرتر بهتر میکند یا نه — حتی وقتی کاربران نمیدانند چه پرسشی باید بپرسند.
ساخت XYBench
XYBench را از چهار منبع ساختیم: ۱٬۵۵۷ پرسش از Stack Overflow، ۱۸۴ پرسش از Stack Exchange، ۱۰۲ نمونه دستی و ۶٬۲۷۲ پرسش تولیدشده از راهنماهای WikiHow. برای هر پرسش، درخواست ظاهری (Y) یعنی چیزی که فرد صریحاً میخواهد و درخواست مقصود (X) یعنی هدف اصلی که از بافت قابل استنباط است را مشخص کردیم.
برای پرسشهای انجمنهای عمومی، از سه پاسخ انسانی با بالاترین امتیاز و در صورت وجود، پاسخ پذیرفتهشده استفاده کردیم تا درخواست مقصود و راهحلهای ممکن را تعیین کنیم. مواردی را کنار گذاشتیم که پاسخ دادن به درخواست ظاهری کافی تشخیص داده میشد. برای WikiHow، از Claude Sonnet 4.5 استفاده کردیم تا پرسشهایی حول فرضهای نادرست محتمل در راهنماهای رویهای بسازد و سپس آنها را طوری اصلاح کردیم که بافت کافی برای استنباط هدف اصلی توسط یک متخصص، بدون بیان صریح آن، داشته باشند. نمونههایی را حذف کردیم که پاسخ دادن به درخواست تحتاللفظی تا حد زیادی مشکل را حل میکرد.
ارزیابی اینکه یک پاسخ چقدر کمک میکند
ممکن است مدل چند پاراگراف را به توصیه جاروبرقی قویتر اختصاص دهد و بعد در یک جمله کوتاه پیشنهاد کند شلنگ گرفته را بررسی کنید. اگر گرفتگی شلنگ علت مکش ضعیف باشد، رفع آن میتواند مشکل را حل کند.
پاسخ مفیدتر آن است که تشخیص دهد کاربر میخواهد مکش را به حالت قبل برگرداند و بر تشخیص علت متمرکز شود. اینجا پای کاربردشناسی به میان میآید؛ شاخهای از زبانشناسی که به نقش بافت و قصد ارتباطی در شکلگیری معنا میپردازد. برای آزمودن اینکه آیا مدلها از این درک در پاسخهایشان استفاده میکنند، XYBench سه جنبه از هر پاسخ را میسنجد:
راهحل کاربردشناختی (Pragmatic solution) — ثبت میکند آیا پاسخ مدل شامل راهحل برای درخواست ظاهری (Y) و درخواست مقصود (X) هست یا نه و هر کدام را جداگانه بررسی میکند.
تأکید کاربردشناختی (Pragmatic emphasis) — میسنجد آیا پاسخ مدل بر درخواست ظاهری (Y) متمرکز است، بر درخواست مقصود (X) متمرکز است، یا میان این دو توازن برقرار میکند.
تشخیص فرض نادرست (Misconception identification) — میسنجد آیا پاسخ مدل کاربر را به سمت هدف اصلی (X) هدایت میکند و در همان حال او را از رویکرد نادرست (Y) دور میکند یا از آن پرهیز میدهد.
در XYBench، Claude Sonnet 4.5 نقش داور خودکار را دارد. این مدل پیشنهادهای منفرد درون پاسخ هر مدل را دستهبندی میکند و تأکید کاربردشناختی پاسخ را میسنجد.
برای اعتبارسنجی داوریهای Claude Sonnet 4.5، دو ارزیاب انسانی بهطور مستقل ۵۰۰ پاسخ مدل به پرسشهای XYBench را ارزیابی کردند. توافق با داور، بهصورت میانگین میان دو ارزیاب، در زمینه حضور راهحل بین ۹۷٫۵ تا ۱۰۰ درصد، در تشخیص فرض نادرست بین ۸۴٫۶ تا ۹۳٫۳ درصد و در تأکید کاربردشناختی بین ۷۴٫۲ تا ۷۹٫۸ درصد بود.
آنچه آزمایشها نشان میدهند
Claude Sonnet 4.6، GPT-5، Gemini 3.1 Pro، Qwen3.5-9B و DeepSeek-V4 Pro را در XYBench در حالت تکنوبت و با یک پاسخ به ازای هر پرسش ارزیابی کردیم. پاسخهای مرجع انسانی را جداگانه و با همان سنجهها ارزیابی کردیم.
در هر چهار منبع، هر مدل بیشتر احتمال داشت راهحلی برای درخواست ظاهری (Y) بگنجاند تا برای هدف اصلی (X). در Stack Overflow، راهحل برای درخواست ظاهری در ۷۵ تا ۸۶ درصد پاسخها آمد، در حالی که این رقم برای راهحل هدف اصلی ۵۹ تا ۷۱ درصد بود.
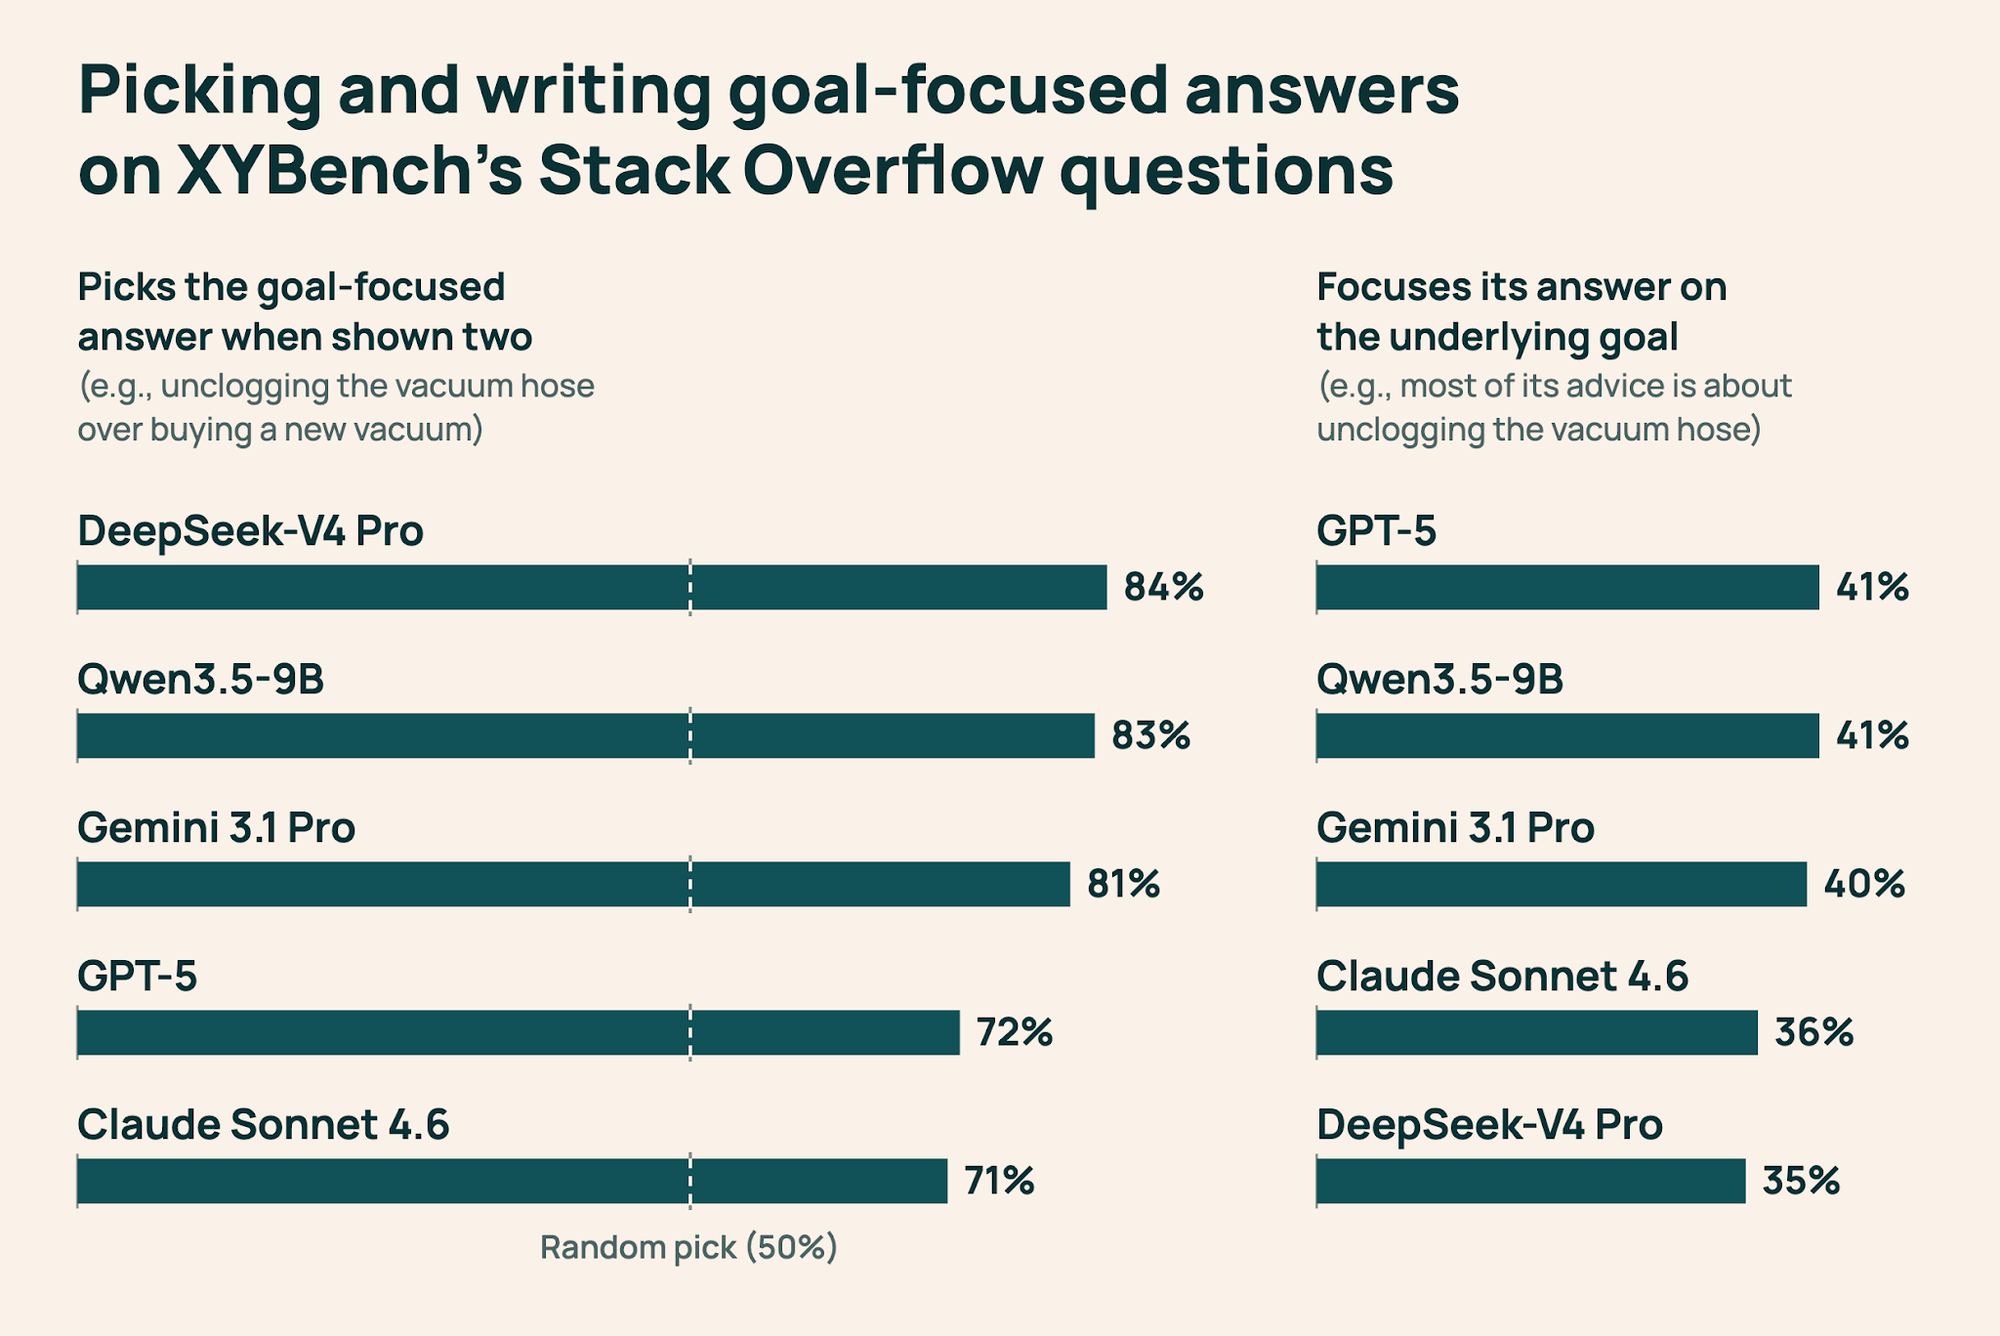
ذکر گذرا یک راهحل باعث نمیشود آن راهحل محور پاسخ شود. در مثال جاروبرقی، مدل میتواند در یک جمله کوتاه رفع گرفتگی شلنگ را پیشنهاد کند اما بیشتر پاسخش را به خرید جاروبرقی قویتر اختصاص دهد. چنین پاسخی را بهعنوان پاسخ دارای راهحل برای هدف اصلی میشماریم، هرچند مدل بر درخواست ظاهری تأکید کرده است. تأکید کلی را جداگانه سنجیدیم: در Stack Overflow، مدلها فقط در ۳۵ تا ۴۱ درصد پاسخهایشان عمدتاً بر هدف اصلی متمرکز بودند و در ۴۷ تا ۵۷ درصد بر درخواست ظاهری. در پاسخهای باقیمانده، مدلها تأکید مشابهی بر درخواست ظاهری و هدف اصلی داشتند.
همچنین آزمودیم آیا صریح کردن هدف کاربر کمکی میکند. در آزمون اوراکل (oracle experiment)، هم درخواست ظاهری (Y) و هم درخواست مقصود (X) را همراه هر پرسش به مدل دادیم. در Stack Overflow، نرخ گنجاندن راهحل برای هدف اصلی در Claude Sonnet 4.6 از ۵۹ به ۶۷ درصد رسید، اما نرخ تشخیص فرض نادرست آن از ۴۷ به ۳۴ درصد کاهش یافت. در منابعی که پاسخ مرجع انسانی داشتند، هر مدل در این آزمون همچنان در تشخیص فرض نادرست از انسان عقب بود. در اختیار گذاشتن قصد کاربر کمک کرد، اما فاصله با پاسخهای انسانی را بهطور یکدست پر نکرد. این نشان میدهد تشخیص قصد فقط بخشی از چالش است: مدلها باید وقتی قصد با درخواست ظاهری فاصله دارد، بر اساس آن هم عمل کنند.
آزمون جداگانهای بررسی کرد آیا مدلها میتوانند هنگام داوری پاسخها — بهجای نوشتن آنها — توصیه مفید را تشخیص دهند. به همان پنج مدل، بهعلاوه GPT-4.1، هر پرسش را همراه دو پاسخ ممکن دادیم: یکی متمرکز بر درخواست تحتاللفظی و دیگری که فرض نادرست را توضیح میداد و به هدف اصلی میپرداخت. در Stack Overflow، هر شش مدل در ۷۱ تا ۸۴ درصد موارد پاسخ متمرکز بر هدف را انتخاب کردند. در مقایسه، فقط ۳۵ تا ۴۱ درصد پاسخهایی که پنج مدل در ارزیابی اصلی نوشتند عمدتاً بر هدف اصلی متمرکز بود. نتایج شکافی را میان تشخیص توصیه مفید و تولید آن آشکار میکند که آزمون چندگزینهای بهتنهایی از دست میدهد.
این نتایج برای ارزیابی چه معنایی دارد
پژوهشگران میتوانند از XYBench استفاده کنند تا بسنجند آیا تغییر در پرامپتدهی یا آموزش مدلها به آنها کمک میکند فرضهای نادرست را تشخیص دهند، برای مشکلات اصلی کاربران راهحل ارائه دهند و آن راهحلها را محور پاسخهایشان کنند. سنجش جداگانه هر رفتار به پژوهشگران امکان میدهد ببینند آیا پیشرفت در یکی، دیگری را هم بهبود میدهد یا نه.
کارهای آینده میتواند بررسی کند کدام روشهای آموزش به مدلها کمک میکند بر اساس قصد استنباطشده عمل کنند — یعنی همان چیزی که کاربران نیاز دارند، نه فقط چیزی که تحتاللفظی پرسیدهاند. XYBench در حال حاضر پرسشهای انگلیسی و عمدتاً مسائل رویهای را پوشش میدهد؛ گسترش آن به زبانها، فرهنگها و موقعیتهای گفتوگویی دیگر مسیری باز برای آینده است.
امیدواریم XYBench پژوهشگران را قادر کند مدلهایی بسازند که حتی وقتی نخستین پرسش کاربر بر فرضی نادرست بنا شده، توصیه مفید ارائه دهند.