مدلی ۲ میلیارد پارامتری که دقیقاً همان فیلدهایی را که میخواهید، از هر نوع سندی استخراج میکند؛ با کیفیت بالاتر از همهٔ مدلهای پیشروی زبانی که آزمایش کردیم و با کسری از هزینهٔ آنها.
در آوریل، DharmaOCR-LITE را منتشر کردیم؛ مدلی تخصصی برای OCR روی طیف گستردهای از اسناد، از قراردادها و پروندههای دادگاهی تا فاکتورها، کارتهای شناسایی و فرمها. مقالهٔ پشت این مدل، استدلالی محدود و سنجیده به نفع تخصصگرایی حوزه ارائه میکرد: مدلی کوچکتر که نزدیکتر به وظیفهٔ خود آموزش دیده، در همان وظیفه از APIهای عمومی پیشرو بهتر عمل میکند.
OCR متنی را که روی صفحه است، با وفاداری به قالببندی اصلی به شما میدهد. این دقیقاً همان چیزی است که وقتی کار، کل سند باشد میخواهید؛ مثل قراردادی که قرار است از ابتدا تا انتها بخوانید یا نسخهٔ خطیای که در حال دیجیتالسازی آن هستید.
با این حال، کاربرد دیگری هم وجود دارد: شما خود صفحه را نمیخواهید، بلکه فیلدهای مشخصی از آن را میخواهید، به شکلی که سیستم پاییندستی بتواند مصرف کند. هر ردیف اقلام یک فاکتور، بهصورت یک فهرست. نام بیمار، نوع آزمایش و تاریخ از یک درخواست پزشکی، آماده برای زمانبندی. فیلدهای یک کارت شناسایی، نگاشتشده به ستونهای یک پروندهٔ کارمند.
اگر سند را از OCR عبور دهید، همهٔ چیزهایی که روی آن چاپ شده را خط به خط پس میگیرید، بدون هیچ نشانهای از اینکه کدام رشته نوع آزمایش است، کدام تاریخ است یا کدام عدد مجموع کل است. هنوز کسی باید کدی بنویسد که هر مقدار را پیش از رسیدن به پایگاه داده به فیلد درست نگاشت کند.
یک مدل زبانی عمومی امروز میتواند این کار را با دستورهای دقیق انجام دهد. اما با قیمت و تأخیر APIهای پیشرو، روی وظیفهای که بسیاری از کسبوکارها باید با حجم بالا اجرا کنند، این روش خیلی زود به راهی گران برای حل مسئلهای کاملاً مشخص تبدیل میشود.
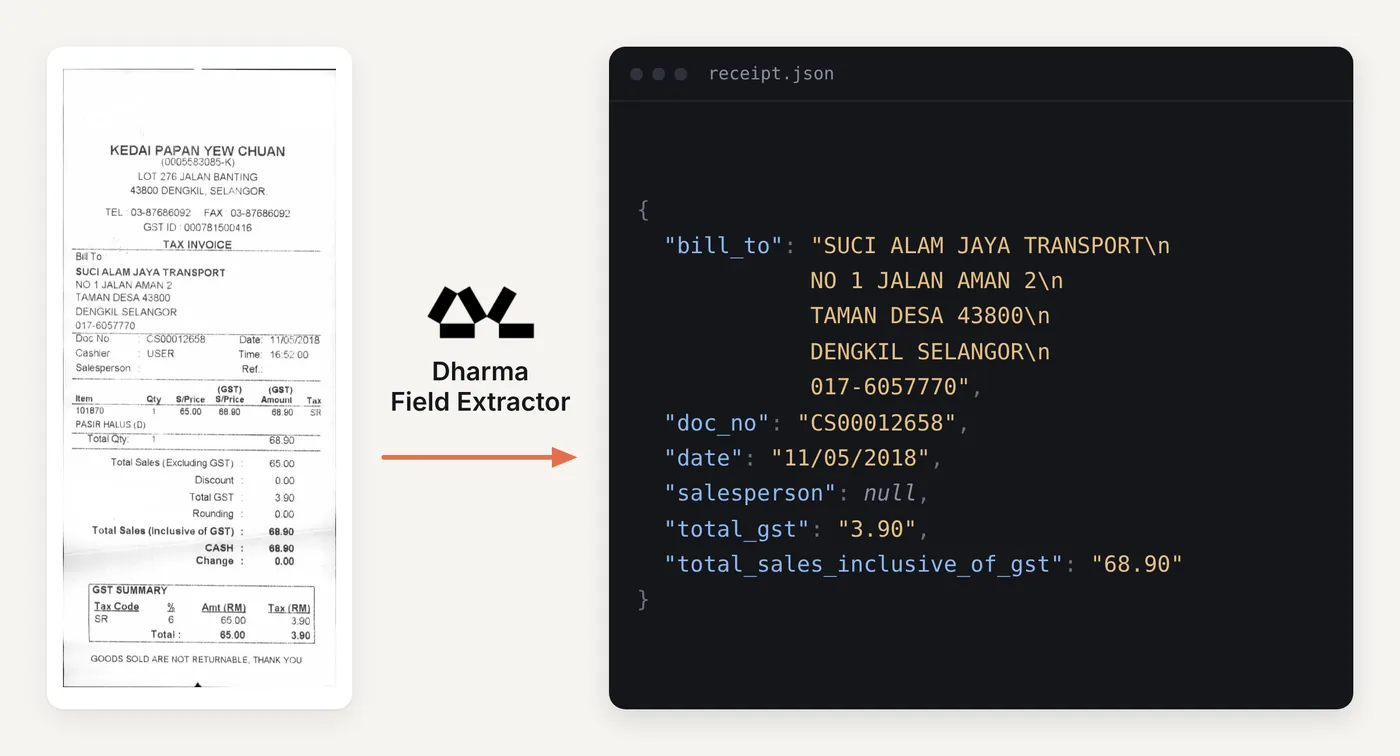
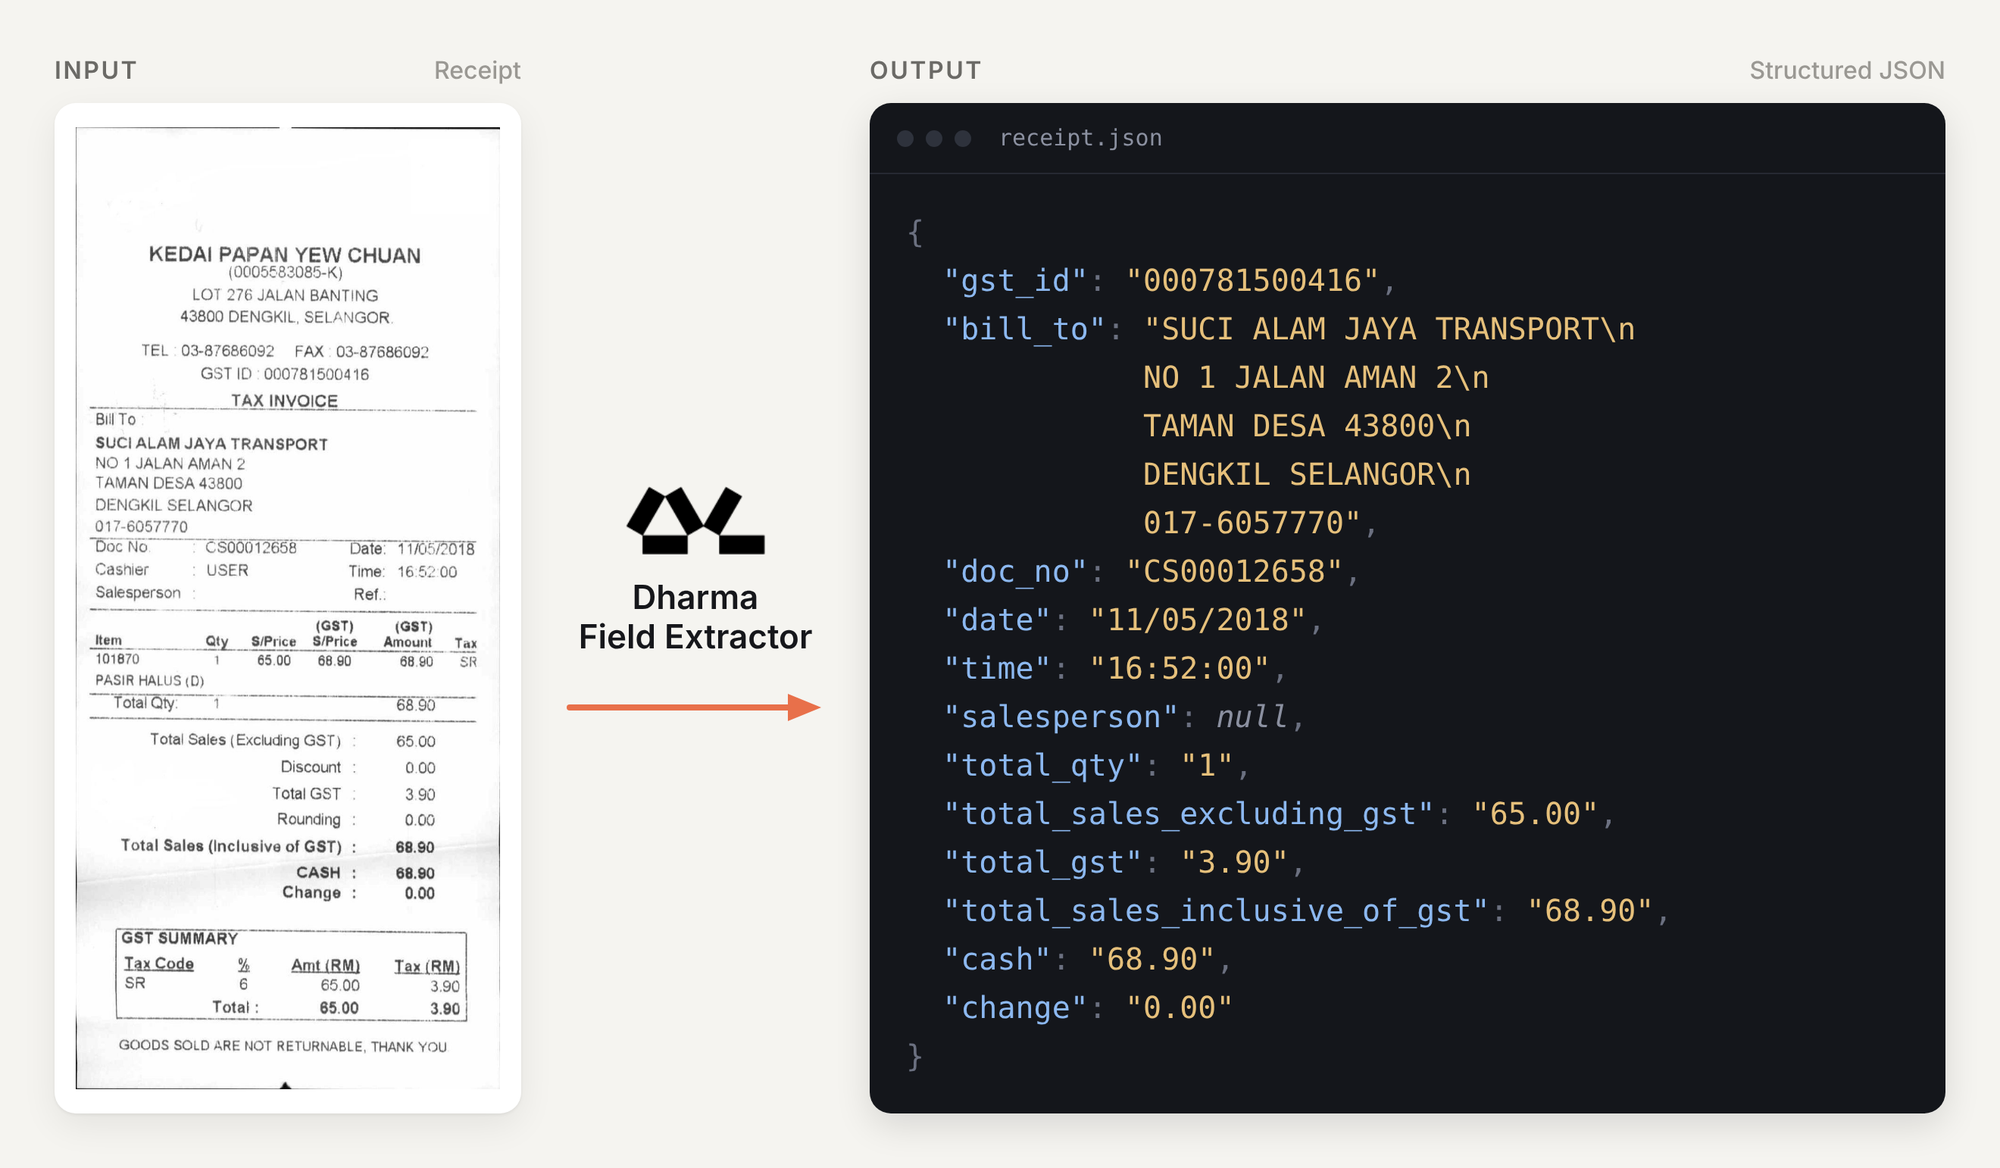
پس به جای آن، مدلی برای این کار ساختیم. Dharma Field Extractor یک تصویر سند و یا درخواستی برای همهٔ چیزهایی که میتواند پیدا کند، یا شِمایی دقیق برای پر کردن دریافت میکند و JSON ساختاریافته برمیگرداند: نوعدار، فیلد به فیلد، و تودرتو هر جا که سند تودرتو باشد. یک فاکتور با هر ردیف اقلام بهصورت فهرستی مرتب، هر کدام با مقدار و تعداد خودش، در کنار مجموعها برمیگردد. یک کارت شناسایی بهصورت فیلدهایی که ذخیره خواهید کرد، زیر همان نامهایی که سیستم شما از قبل برایشان استفاده میکند، برمیگردد. یک چکپوینت واحد همهٔ اینها را انجام میدهد، بدون تنظیم دقیق جداگانه برای هر نوع سند.
میتوانید خودتان اینجا امتحانش کنید.
مدل چه کاری انجام میدهد
فرض کنید هر صبح دستهای فاکتور تأمینکننده میرسد و برای وارد کردن به سیستم به چهار چیز از هر کدام نیاز دارید: تأمینکننده، شمارهٔ فاکتور، تاریخ سررسید و مجموع کل. همین داستان برای درخواستهای پزشکی که به یک سیستم زمانبندی میروند، یا قراردادهایی که به یک سیستم انطباق خوراک میدهند و در آنها طرفها، مدت، جریمهها و مبالغ جریمه اهمیت دارند. شما صفحه را نمیخواهید، فیلدهای مشخصی را میخواهید. با Dharma Field Extractor دو راه برای درخواست آنها وجود دارد:
حالت باز: هیچ شِمایی ارائه نمیشود. مدل صفحه را میخواند و از روی بافت و چیدمان تشخیص میدهد کدام بخشهای آن فیلدهای ساختاریافتهاند (یک برچسب که پس از آن مقداری میآید، جدولی با یک ردیف سرستون بالای ستونهایش)، نه از روی فهرستی ثابت از نام فیلدها، و همهٔ چیزهایی را که پیدا میکند بهصورت جفتهای کلید-مقدار برمیگرداند.
مبتنی بر شِما: شما شکل دقیق مورد نظر را فیلد به فیلد مشخص میکنید، با یک نوع برای هر کدام (رشته، عدد یا بولی)، زیر همان نامهای کلیدی که سیستم شما از قبل استفاده میکند. «service_provider» و «client_company» را بخواهید، و همانها دقیقاً بهعنوان کلید برمیگردند. جدولی را بخواهید و آن را ردیف به ردیف، ستون به ستون پر میکند و هر خانه را به کلیدی که زیر آن قرار دارد نگاشت میکند. فیلدی را بخواهید که روی سند نیست، و به جای ساختن مقدار، null برمیگرداند.
انتخاب به آن چیزی بستگی دارد که از قبل میدانید. وقتی نمیدانید سند چه چیزی در خود دارد، درخواست باز بفرستید. وقتی خروجی باید با شکلی مطابقت داشته باشد که از قبل جای دیگری وجود دارد، شِما بفرستید.
در هر دو حالت، آنچه برمیگردد JSON است: فیلدها بهعنوان کلید، مقادیر با نوع درخواستی، و null هر جا که سند چیزی را که خواسته بودید نداشته است. وقتی شِما میفرستید، خروجی دقیقاً از آن پیروی میکند، با همان کلیدها و بدون فیلد اضافه، تا بتواند مستقیم به سیستم بعدی برود.
چگونه آموزش داده شد
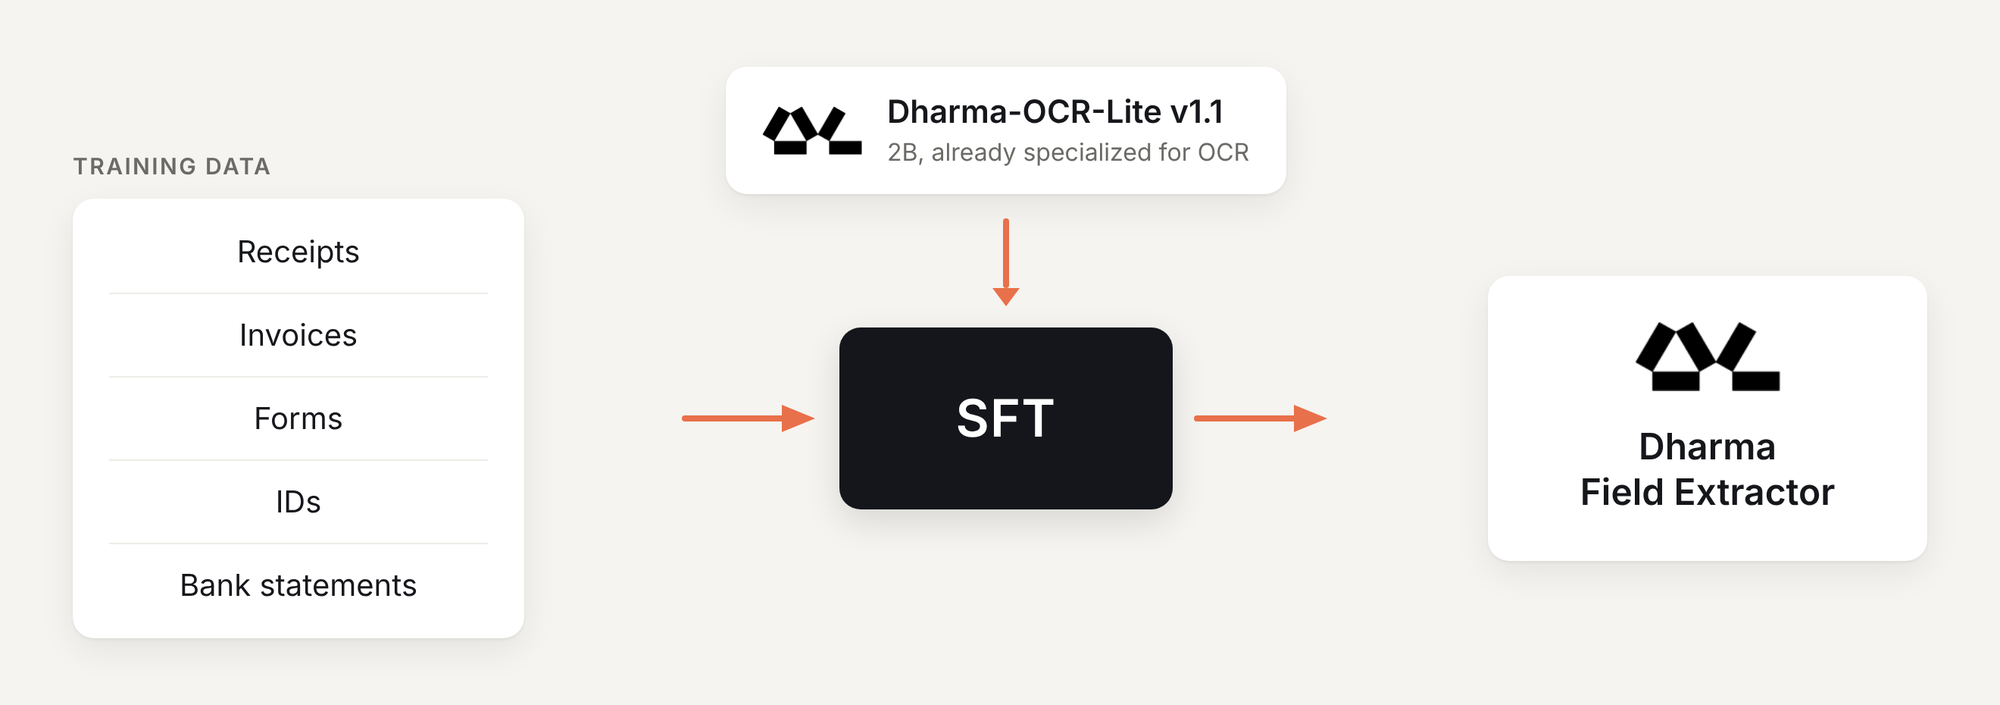
مدل پایه، DharmaOCR-LITE v1.1 است؛ نسخهای جدید با ۲ میلیارد پارامتر که از نسخهٔ مقاله بهینهسازی شده و از طریق تنظیم دقیق با نظارت و DPO از قبل برای OCR تخصص یافته است. روی همان چکپوینت، یک آداپتور LoRA روی ۴۳٬۳۸۴ نمونهٔ آموزشی شامل هر دو حالت درخواست آموزش دادیم.
دادهها در سه جریان سازماندهی شدهاند:
دادهٔ چندحوزهای انگلیسی: اسناد متنوعی که از وب عمومی جمعآوری شده و انواع بسیاری از اسناد را در بر میگیرد.
دادهٔ حوزهٔ برزیل: اسناد واقعی برزیلی که بهصورت داخلی تهیه شدهاند، به زبان پرتغالی.
دادهٔ چندزبانه: سهمی کوچکتر که سایر زبانهای اروپایی و آسیایی را پوشش میدهد، برای تعمیم گستردهتر فراتر از انگلیسی و پرتغالی.
هر سه جریان در سطح فیلد برچسبگذاری شدهاند. ترکیب عمداً چندحوزهای است: رسیدها، فاکتورهای تجاری، فرمها، صورتحسابهای بانکی، مدارک شناسایی و اسناد مصنوعی، نه یک نوع پروندهٔ واحد.
مرزهای بنچمارک
بنچمارک کامل ۵۴۶ سند را در سه سناریوی درخواست، در مجموع ۱٬۶۳۸ مورد، پوشش میدهد: استخراج همهٔ فیلدها بدون شِما، شِمای جزئی که فقط فیلدهای واقعی را نام میبرد، و شِمایی که فیلدهای عمداً ناموجود را هم شامل میشود. امتیاز، F1 در سطح فیلد است (تطبیق بر اساس مسیر، شامل موقعیت درون جدول) که در شباهت لِوِنشتاین مقادیر منطبقشده و در سهم خروجیهایی که بهصورت JSON معتبر برمیگردند ضرب میشود.
همین بنچمارک را روی چهار پیکربندی عمومی پیشرو اجرا کردیم.
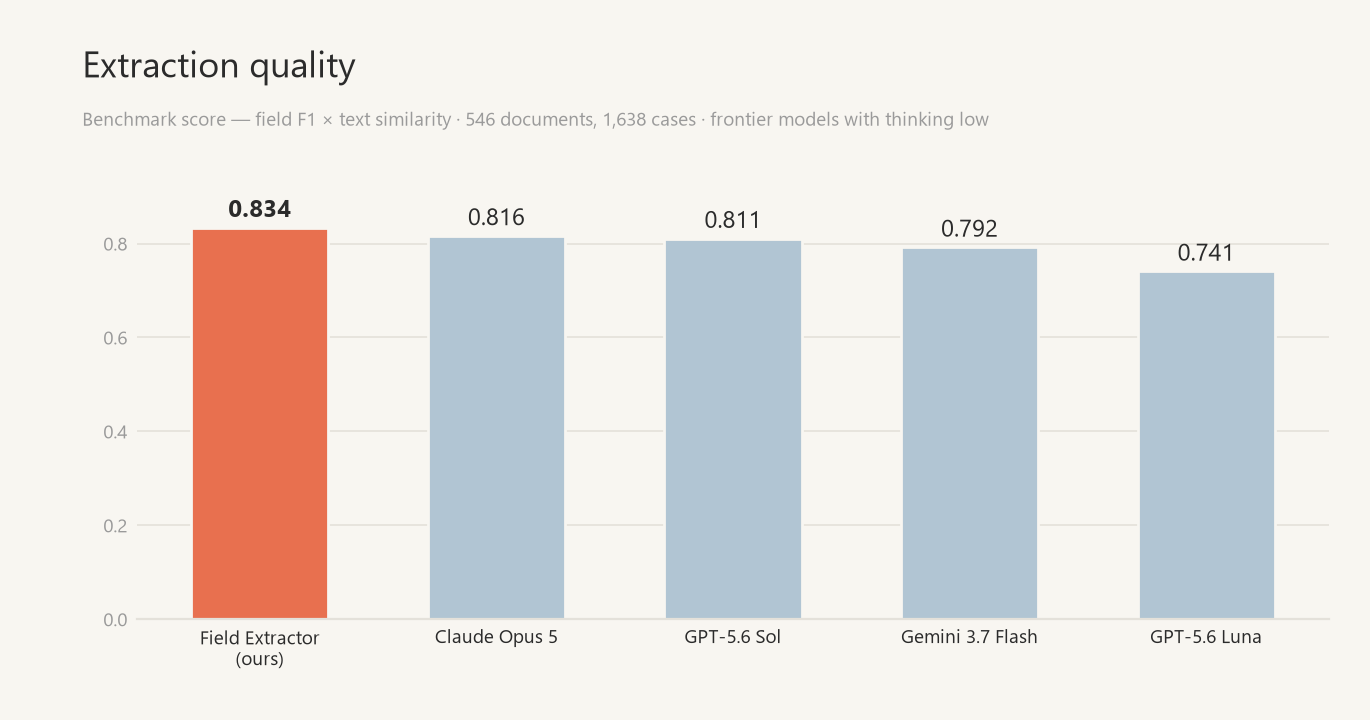
در مقایسه با مدلهای زبانی عمومی، اختلاف کیفیت از ۱٫۸ امتیاز (Claude Opus 5، نزدیکترین) تا ۹٫۳ امتیاز (GPT-5.6 Luna، بیشترین) است.
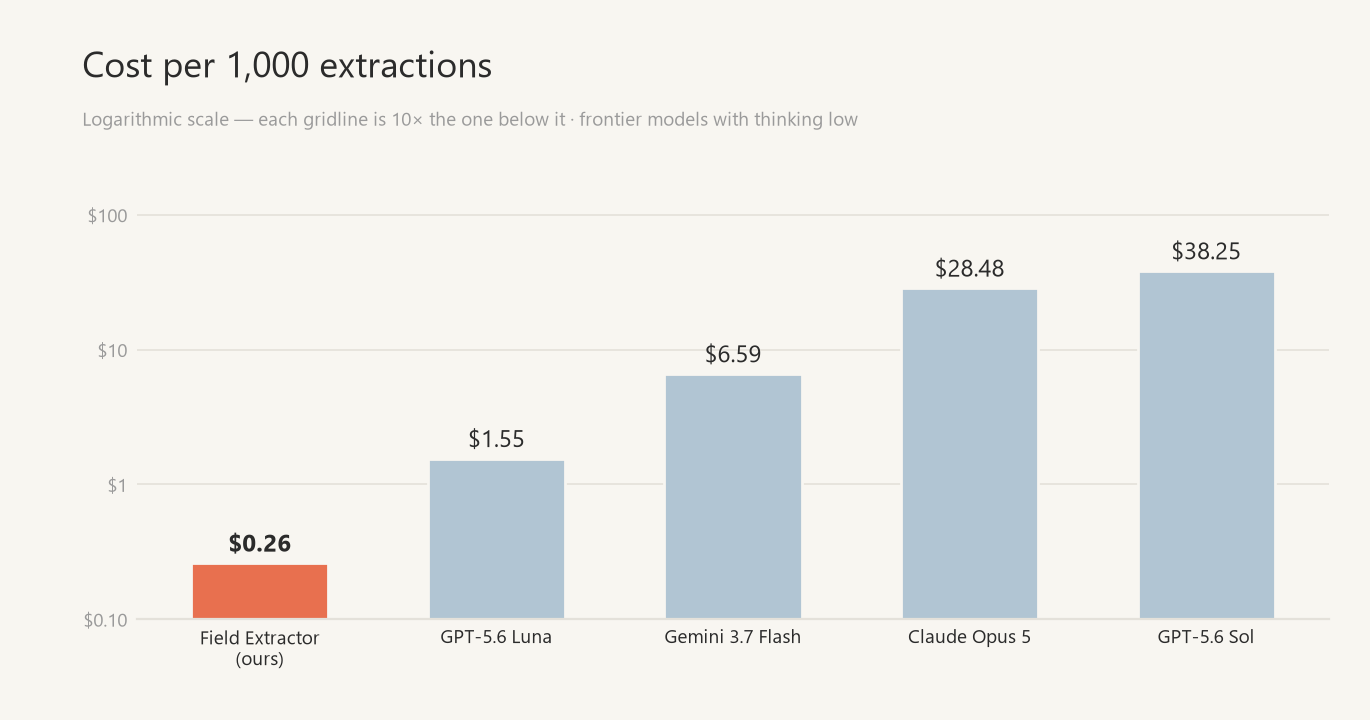
هزینه از حدود ۶ برابر کمتر (GPT-5.6 Luna) تا حدود ۱۴۷ برابر کمتر (GPT-5.6 Sol) است. مبنای قیمتگذاری دو طرف متفاوت است. ارقام مدلهای پیشرو از میانگین اندازهگیریشدهٔ توکنهای ورودی و خروجی در هر صفحه، با احتساب توکنهای استدلال، در برابر قیمت فهرست منتشرشدهٔ هر ارائهدهنده به دست آمده است. همهٔ مدلهای پیشرو با تنظیم استدلال روی low اجرا شدند؛ Claude Opus 5 از adaptive effort استفاده کرد که میتواند در صفحات سادهتر استدلال را رد کند و در همان سطح low بماند. مدل ما بر اساس توکن صورتحساب نمیشود: مدل خودمیزبان اجرا میشود، پس رقم، زمان GPU روی یک L40S با نرخ ۲٫۲۴ دلار در ساعت است.
این قیمت فروش نیست. هزینهٔ خودمیزبان به سختافزار، حجم و تأخیری بستگی دارد که هر استقرار نیاز دارد. این مقایسه برای نشان دادن این است که یک SSLM مستقل که روی زیرساخت خودتان مستقر شده، جایگزینی واقعی برای APIهای پیشرو است.
آزمونی برای تعمیم
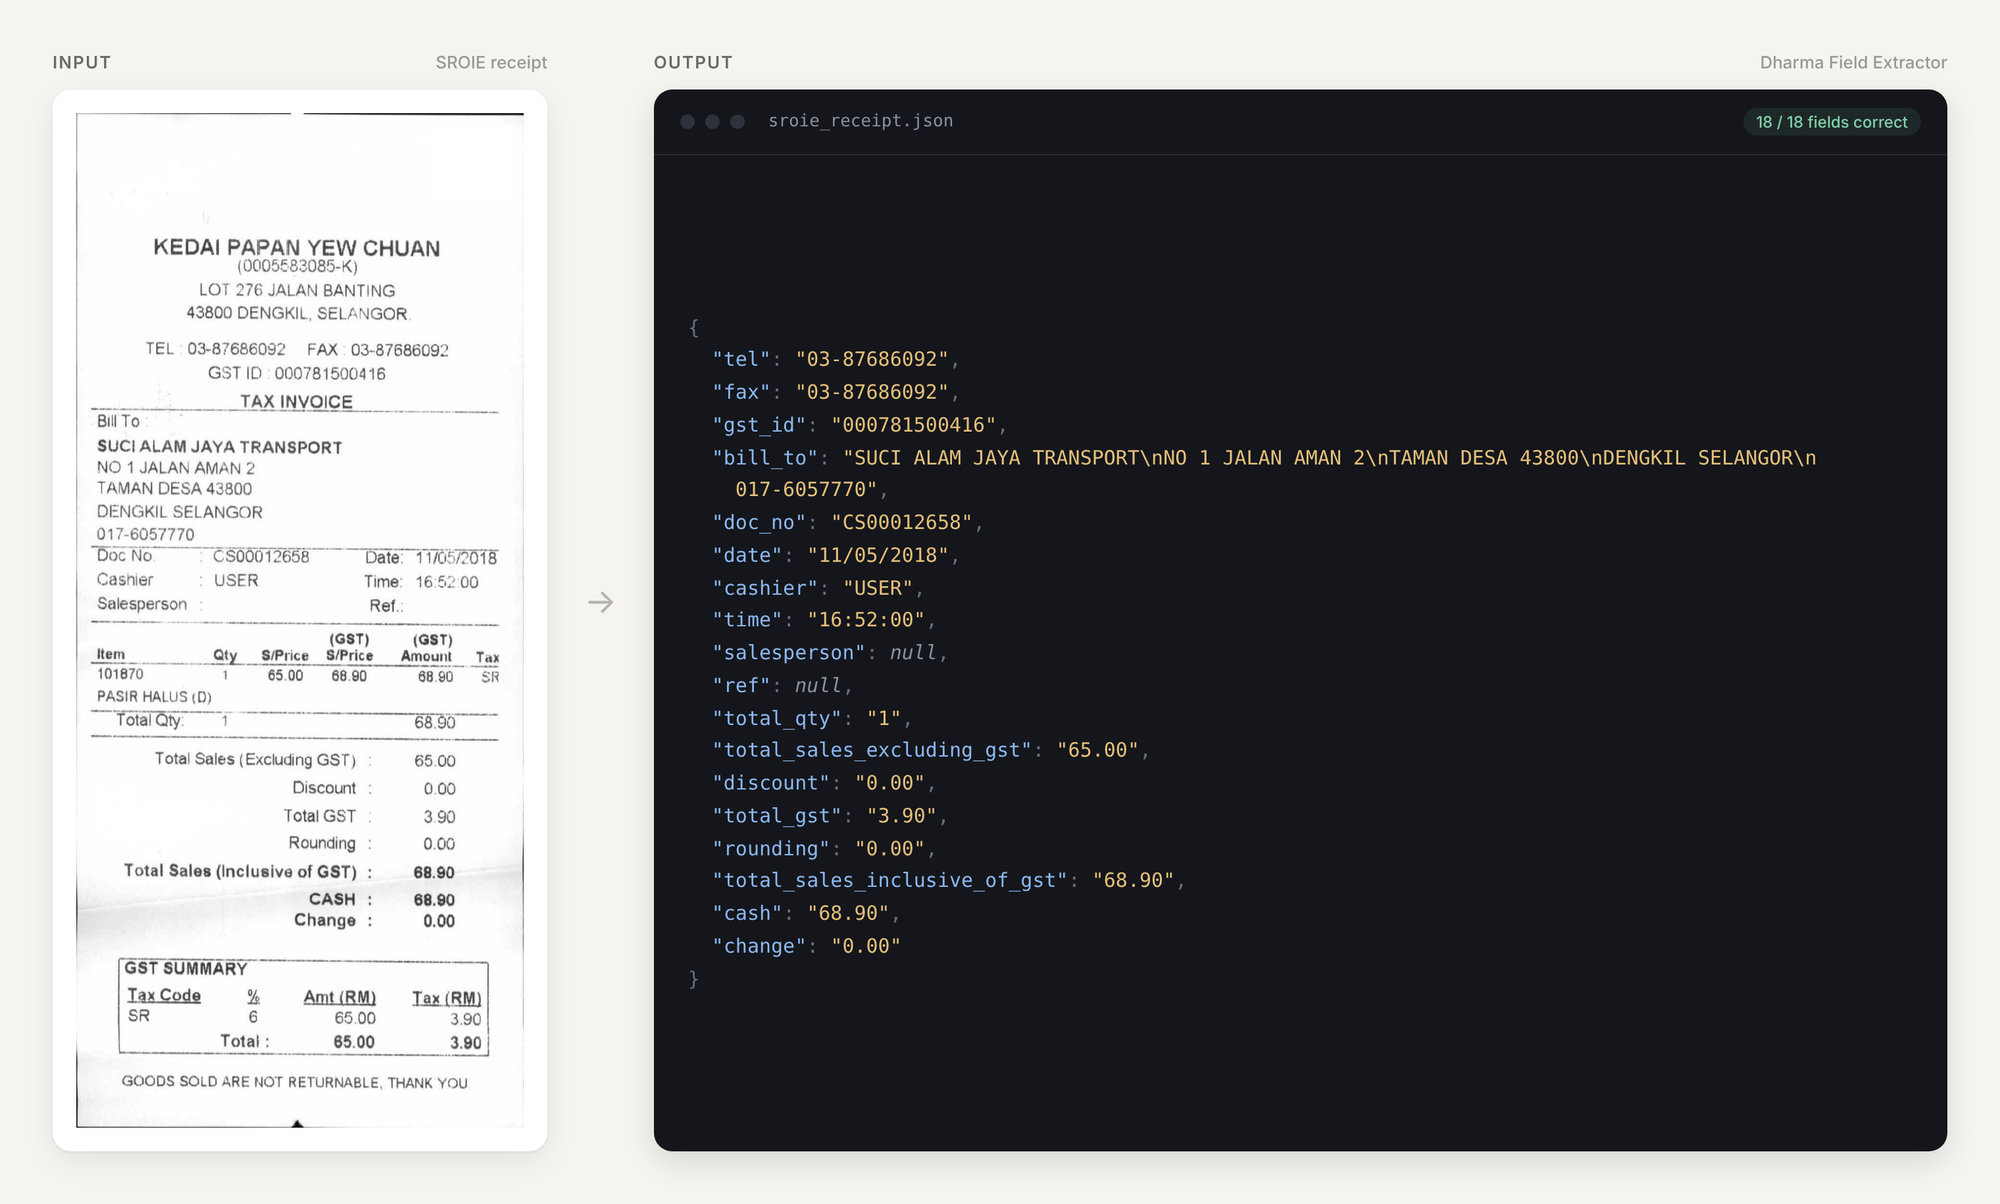
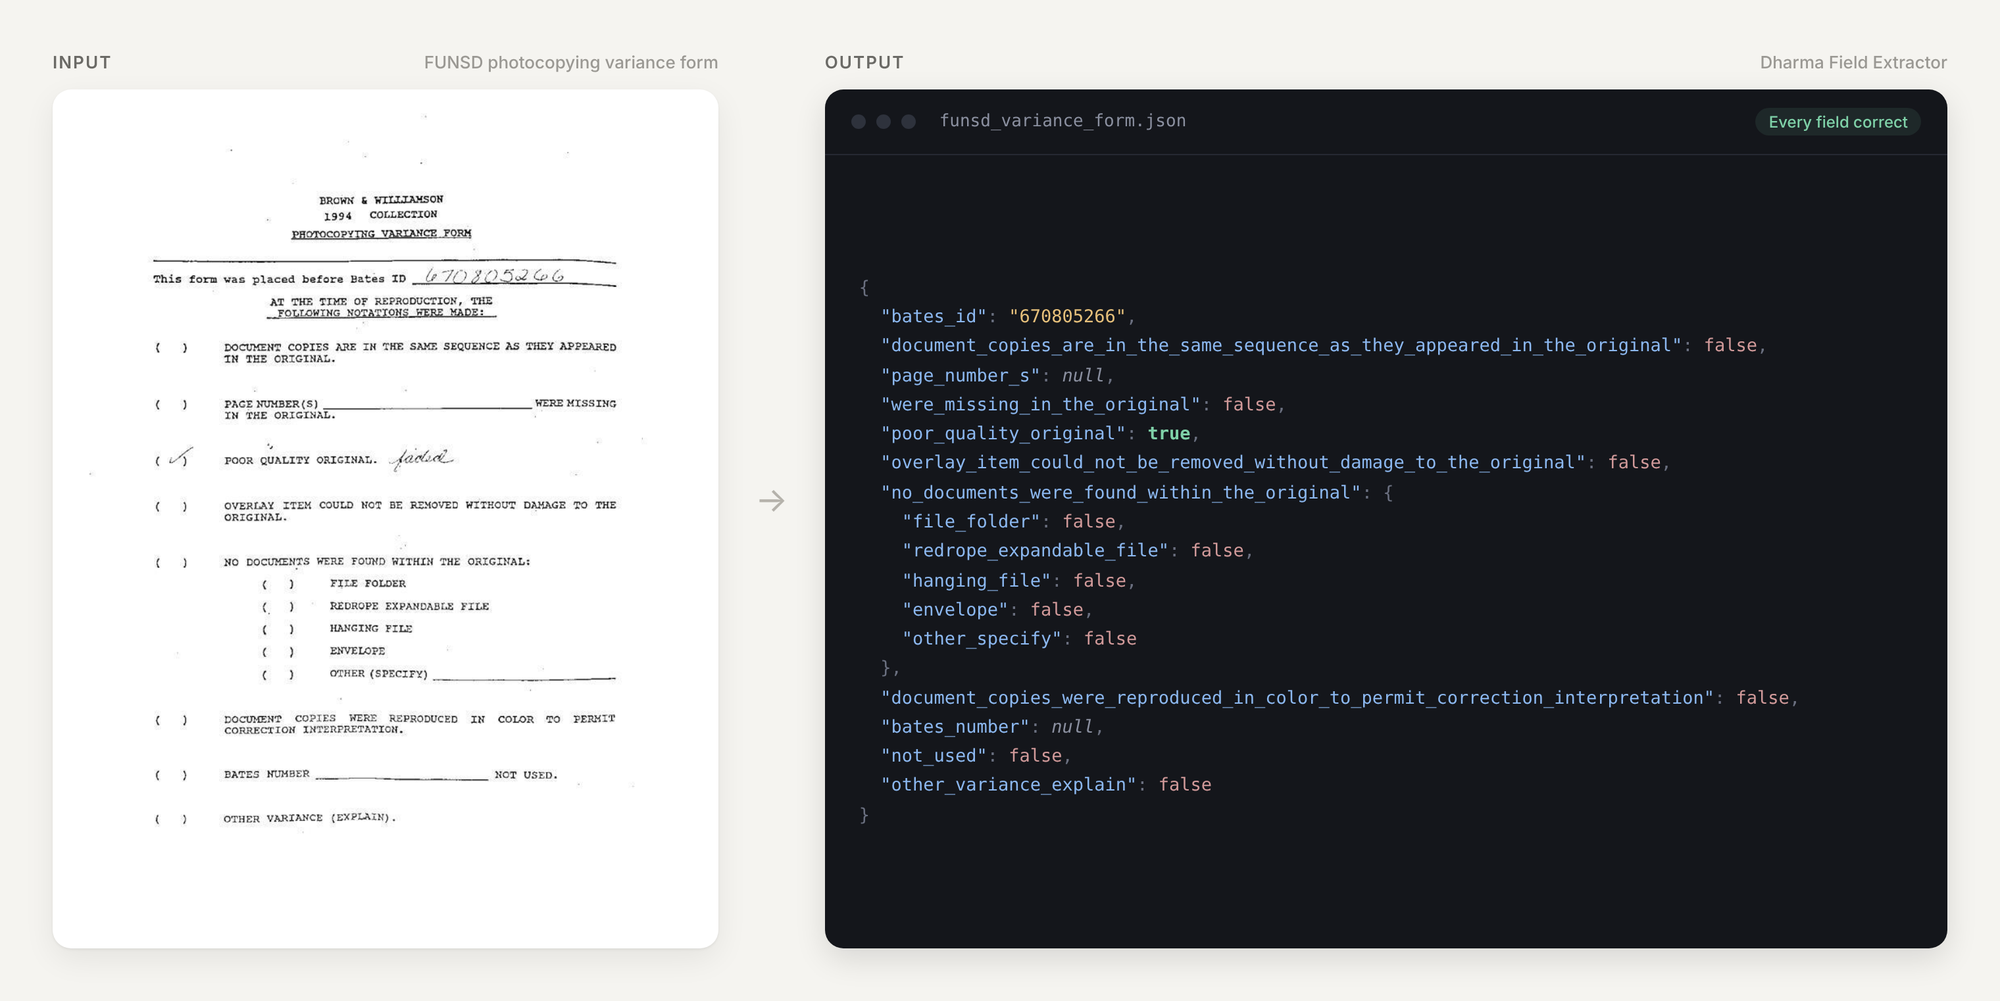
SROIE و FUNSD دو دادهمجموعهٔ عمومی در بنچمارک ما هستند که در آموزش استفاده نشدهاند. در ادامه یک نمونه از هر کدام آمده است.
روی یک رسید SROIE، همهٔ ۱۸ فیلد چاپشده روی آن را خواستیم، این بار بدون فیلدهای ساختگی، و همه درست برمیگردند: آدرس صورتحساب چندخطی و بدون برچسب بهصورت یک فیلد واحد ثبت شده، دو فیلد خالی (فروشنده و شمارهٔ مرجع) بهدرستی null برگشتهاند، و هر عدد روی رسید تا سنت مطابقت دارد.
روی یک فرم واریانس تکثیر FUNSD، فهرستی از دوازده فیلد بولی با یک گروه تودرتوی پنج گزینهای، مدل دقیقاً همان یک کادری را که تیک خورده است (اصلی با کیفیت پایین، با یادداشت دستنویس «faded» در کنارش) true علامت میزند و یازده تای دیگر را false، دقیقاً مطابق فرم. شناسهٔ بیتس دستنویس را هم بهدرستی از صفحه میخواند و برای دو فیلد خالی null برمیگرداند.
کیفیت و هزینه، همزمان
یک مدل ۲ میلیارد پارامتری امتیاز ۰٫۸۳۴ گرفت، بالاتر از هر پیکربندی پیشرویی که آزمایش کردیم، از Claude Opus 5 با ۰٫۸۱۶ تا GPT-5.6 Luna با ۰٫۷۴۱، در حالی که روی یک L40S واحد و با هزینهٔ هر استخراج کمتر از هر API در این مقایسه اجرا میشد. کیفیت بالاتر و هزینهٔ کمتر، سنجیدهشده روی همان بنچمارک و در همان اجرا.
این اولین بار نیست که آن را میسنجیم. مقالهٔ OCR ما اولین DharmaOCR-LITE، مدلی ۳ میلیارد پارامتری، را بالاتر از هر API تجاری پیشروی آزمایششده در پرتغالی برزیل قرار داد؛ سه ماه بعد، مدلهای جدیدتر و با منابع بیشتر آمدند و این شکاف حفظ شد. حالا مدلی ۲ میلیارد پارامتری همین کار را در استخراج فیلد انجام میدهد. هر نتیجه شواهدی به فرضیهای میافزاید که Dharma-AI را با آن آغاز کردیم: در یک وظیفهٔ محدود، مدلی کوچک که نزدیک به همان وظیفه آموزش دیده، از مدل پیشرویی که از آن خواسته شده همان کار را بهصورت عمومی انجام دهد بهتر عمل میکند. در این بنچمارک، اجرای آن ۶ تا ۱۴۷ برابر کمتر هم هزینه داشت.
تعداد پارامترها سقف را تعیین میکند؛ آموزش تعیین میکند مدل تا چه حد از آن سقف را در وظیفهٔ شما میرسد. کسبوکار شما به بزرگترین مدل موجود نیاز ندارد. به مدلی نیاز دارد که برای مسئلهٔ شما آموزش دیده باشد.
همین حالا روی اسناد خودتان امتحانش کنید. برای آشنایی بیشتر با Dharma-AI و مدلهای تخصصیای که میسازیم، به dharma-ai.com سر بزنید.
منابع
BID. Brazilian Identity Document Dataset. Soares, Neves Jr., Bezerra (2020), "BID Dataset: a challenge dataset for document processing tasks," Anais Estendidos XXXIII SIBGRAPI. github.com/ricardobnjunior/Brazilian-Identity-Document-Dataset
CORD. Park et al., NAVER CLOVA (2019). huggingface.co/datasets/naver-clova-ix/cord-v2
DocVQA. Mathew et al., WACV 2021 (ICDAR 2019). huggingface.co/datasets/lmms-lab/DocVQA
WildReceipt. Sun et al., IJCAI 2021. huggingface.co/datasets/Theivaprakasham/wildreceipt
SROIE (ICDAR 2019). از آموزش کنار گذاشته شده، فقط برای ارزیابی. huggingface.co/datasets/darentang/sroie (mirror); upstream rrc.cvc.uab.es/?ch=13
FUNSD. Jaume et al. از آموزش کنار گذاشته شده، فقط برای ارزیابی. huggingface.co/datasets/nielsr/funsd (mirror); guillaumejaume.github.io/FUNSD
Zenodo Invoices (PT). Cruz & Castelli, NOVA IMS (2022). zenodo.org/records/6371710
line_items. Sagarjha456, Hugging Face. huggingface.co/datasets/Sagarjha456/line_items
Katanaml Invoices (Donut). Kozłowski & Weichbroth (2021), Mendeley Data doi:10.17632/tnj49gpmtz.2 . huggingface.co/datasets/katanaml-org/invoices-donut-data-v1
HumynLabs Brazilian Bills and Invoices. huggingface.co/datasets/HumynLabs/Brazilian_Bills_and_Invoices_Dataset
Tech4Humans BR-Doc Extraction. huggingface.co/datasets/tech4humans/br-doc-extraction
Cardoso, Gabriel Pimenta de Freitas, et al. "DharmaOCR: Specialized Small Language Models for Structured OCR that outperform Open-Source and Commercial Baselines." arXiv preprint arXiv:2604.14314 (2026).
بیشتر بخوانید
چگونه تخصصیکردن واژگان مدلهای زبانی کوچک میتواند هزینهٔ استنتاج را در کاربردهای واقعی ۷۷٪ کاهش دهد
همان خوشه، ۳۳ واحد درصد بهرهوری بیشتر: آنچه تغییر کرد، ترتیب بود
مدیریت GPU: چرا GPUهای بیکار هواپیمای زمینگیرشدهٔ جدیدند
مدلهای جدیدتر، همان مزیت
چرا تخصصگرایی اجتنابناپذیر است
تخصصگرایی بر مقیاس پیروز میشود: متغیر راهبردیای که بیشتر تصمیمهای تأمین هوش مصنوعی از آن غافلاند
واپاشی متن: حالتی از شکست در محیط عملیاتی که بیشتر بنچمارکها آن را رصد نمیکنند
بهینهسازی ترجیح مستقیم فراتر از چتباتها
Dharma-AI را در Hugging Face کاوش کنید تا دموهای تعاملی ما را امتحان کنید، مدلهای متنباز ما را دانلود کنید و ببینید چگونه سیستمهای هوش مصنوعی تخصصی در کاربردهای واقعی سازمانی از مدلهای عمومی بهتر عمل میکنند.