دو هفته پیش Phonon را عرضه کردیم؛ مدل کوچک تبدیل متن به گفتارمان که روی دستگاه خودتان اجرا میشود. نه به سرور نیاز دارد و نه به شبکه، و هر چه تایپ میکنید پیش خودتان میماند.
استقبال از Phonon تا اینجا ما را بسیار خوشحال کرده است. حالا ماجرای این عرضه را تعریف میکنیم: چرا Phonon را ساختیم، چه کارهایی میکند، چه دموهایی همراه آن آمد و در Open TTS Leaderboard شرکت Hugging Face چه عملکردی داشت.
چرا صدا باید روی دستگاه خودتان اجرا شود
بیشتر فناوریهای هوش مصنوعی صوتی در فضای ابری اجرا میشوند: هر جمله برای پردازش به سرور میرود و برمیگردد. در مقابل، Phonon روی دستگاه خودتان اجرا میشود. متن شما همانجا میماند و صدا بدون نیاز به شبکه تولید میشود. وزنهای مدل را هم منتشر کردهایم. Phonon 31m با مجوز Apache 2.0 عرضه شده است، پس میتوانید آزادانه از آن استفاده کنید، حتی در یک محصول تجاری. مدلهای دیگر با مجوز CC BY-NC منتشر شدهاند و استفاده از آنها در پروژههای غیرتجاری آزاد است. اگر با این مدلها محصولی تجاری میسازید، قیمتگذاری بر اساس تعداد کاربران شماست، نه حجم گفتاری که تولید میکنید.
همیشه سخت بوده است که صدایی باکیفیت روی دستگاهی کوچک اجرا شود. میشد مدل را کوچک کرد، اما آنوقت کیفیت صدایش خوب نبود. یا میشد کیفیت صدا را بالا برد، اما مدل در دستگاه جا نمیشد. ما هر دو مسئله را حل کردیم.
Phonon را در آوریل معرفی کردیم و شش ماه بعد را صرف توسعه آن با همکاران و کاربران اولیه کردیم. بازخورد آنها به شکلدادن به این نسخه کمک کرد. مدلها کوچکتر شدند و زبانهای بیشتری به آنها اضافه کردیم و از طریق شبیهسازی صدا و طراحی صدا، پشتیبانی از صداهای سفارشی را فراهم کردیم.
Phonon از تبار Pocket TTS است و به همین دلیل برای تولید صدا از تطبیق جریان استفاده میکند که با روشهای مدلسازی بهکاررفته در دیگر سیستمهای تبدیل متن به گفتار تفاوت زیادی دارد. همین روش به ما امکان داد چنین کیفیتی را در مدلی اینقدر کوچک ارائه دهیم، اما در آموزش مدلها چالشهای تازهای ایجاد کرد. آموزش در ابتدا از نظر عددی ناپایدار بود و برای رسیدن به نتایج باکیفیت در هر پنج زبان به چند ترفند نیاز داشت.
چه چیزی عرضه شد
Phonon در دو اندازه عرضه شده است، با حجم حدود ۶۵ مگابایت و ۷۵ مگابایت. این دو مدل روی هم به انگلیسی، فرانسوی، آلمانی، اسپانیایی و پرتغالی صحبت میکنند. بیش از ۱۰۰ صدای آماده دارد و میتوانید صدای خودتان را در Gradium Studio بسازید. Phonon از موارد مهمی هم که بسیاری از سیستمهای دیگر تبدیل متن به گفتار معمولاً در آنها دچار مشکل میشوند بهخوبی پشتیبانی میکند؛ مواردی مثل شماره تلفن، تاریخ و کد.
Phonon روی گوشیها، لپتاپها، رایانههای تکبردی و در یک تب مرورگر اجرا میشود، پس میتوانید همین حالا آن را بشنوید. Phonon 31m به انگلیسی صحبت میکند و مجوز Apache 2.0 دارد، پس میتوانید آزادانه روی آن بسازید، از جمله برای محصولات تجاری. Phonon 40m هر پنج زبان را با مجوز غیرتجاری پوشش میدهد.
دموها و نخستین پروژهها
همراه با عرضه، دموهایی از دوستان و تیم خودمان منتشر شد. روی یک Apple Watch با وایفای خاموش، Phonon مرحلهبهمرحله شما را در دمکردن قهوه راهنمایی میکند. روی یک آیفون بدون آنتن، تعداد حرکات ورزشی شما را میشمارد و تشویقتان میکند. رباتی به نام Lamp از شرکت Autonomous کلاه گروهبندی به سر میگذارد و در نقش خودش صحبت میکند. در مرورگر، یک بازی دونده دایناسور آفلاین به نمایش رادیویی تبدیل میشود که Rex اجرای آن را بر عهده دارد. یک بازی علمیتخیلی هم هست که صداگذاری آن روی دستگاه خود بازیکن انجام میشود، و کتابی از Proust (مارسل پروست) که صفحهبهصفحه با صدای بلند خوانده میشود.
تیم Hugging Face یکپارچهسازی با Transformers را ساخت تا توسعهدهندگان از همان روز اول بتوانند از Phonon در Transformers استفاده کنند.
توسعهدهندگان هم ساخت روی آن را آغاز کردهاند. یک تبدیل ExecuTorch، Phonon را روی GPU بازدیدکننده در مرورگر اجرا میکند، Micdrop آن را به اپلیکیشنهای Node.js میآورد و Spaceهایی مثل smallest-s2s روی آن ساخته شدهاند.
Phonon در دو هفته نخست بیش از ۲۰۰٬۰۰۰ بار دانلود شد و هنوز در Hugging Face جزو موارد پرطرفدار است.
عملکرد Phonon در Open TTS Leaderboard شرکت Hugging Face
Open TTS Leaderboard پروژهای بسیار تازه از Hugging Face است و ما آن را خیلی دوست داریم. با وجود بیش از ۹٬۰۰۰ مدل تبدیل متن به گفتار در Hugging Face Hub، این لیدربورد یک نقطه مقایسه واحد در اختیار توسعهدهندگان میگذارد تا مدلهای باز را با هم بسنجند و کنار هم بشنوند. مدلها در ۲۳ زبان بر اساس وضوح (نرخ خطای کلمه در خروجی)، سرعت (ضریب معکوس زمان واقعی و زمان تا اولین صدا) و طبیعی بودن (UTMOS برای انگلیسی و KOMOS برای کرهای) ارزیابی میشوند. هر دو حالت صدای ثابت و شبیهسازی صدا ارزیابی میشوند و برای حالت دوم معیار اضافی شباهت گوینده هم در نظر گرفته میشود. این لیدربورد یک تب Listen هم دارد که میتوانید خروجی مدلهای تبدیل متن به گفتار را خودتان بهراحتی مقایسه کنید و به آنهایی که بیشتر میپسندید رأی دهید.
از نظر وضوح، Phonon در آلمانی و اسپانیایی رتبه اول را دارد و در هر زبانی که ارزیابی شده، در میان سه مدل برتر است؛ در کنار مدلهایی که تا ۱۰۰ برابر بزرگترند.
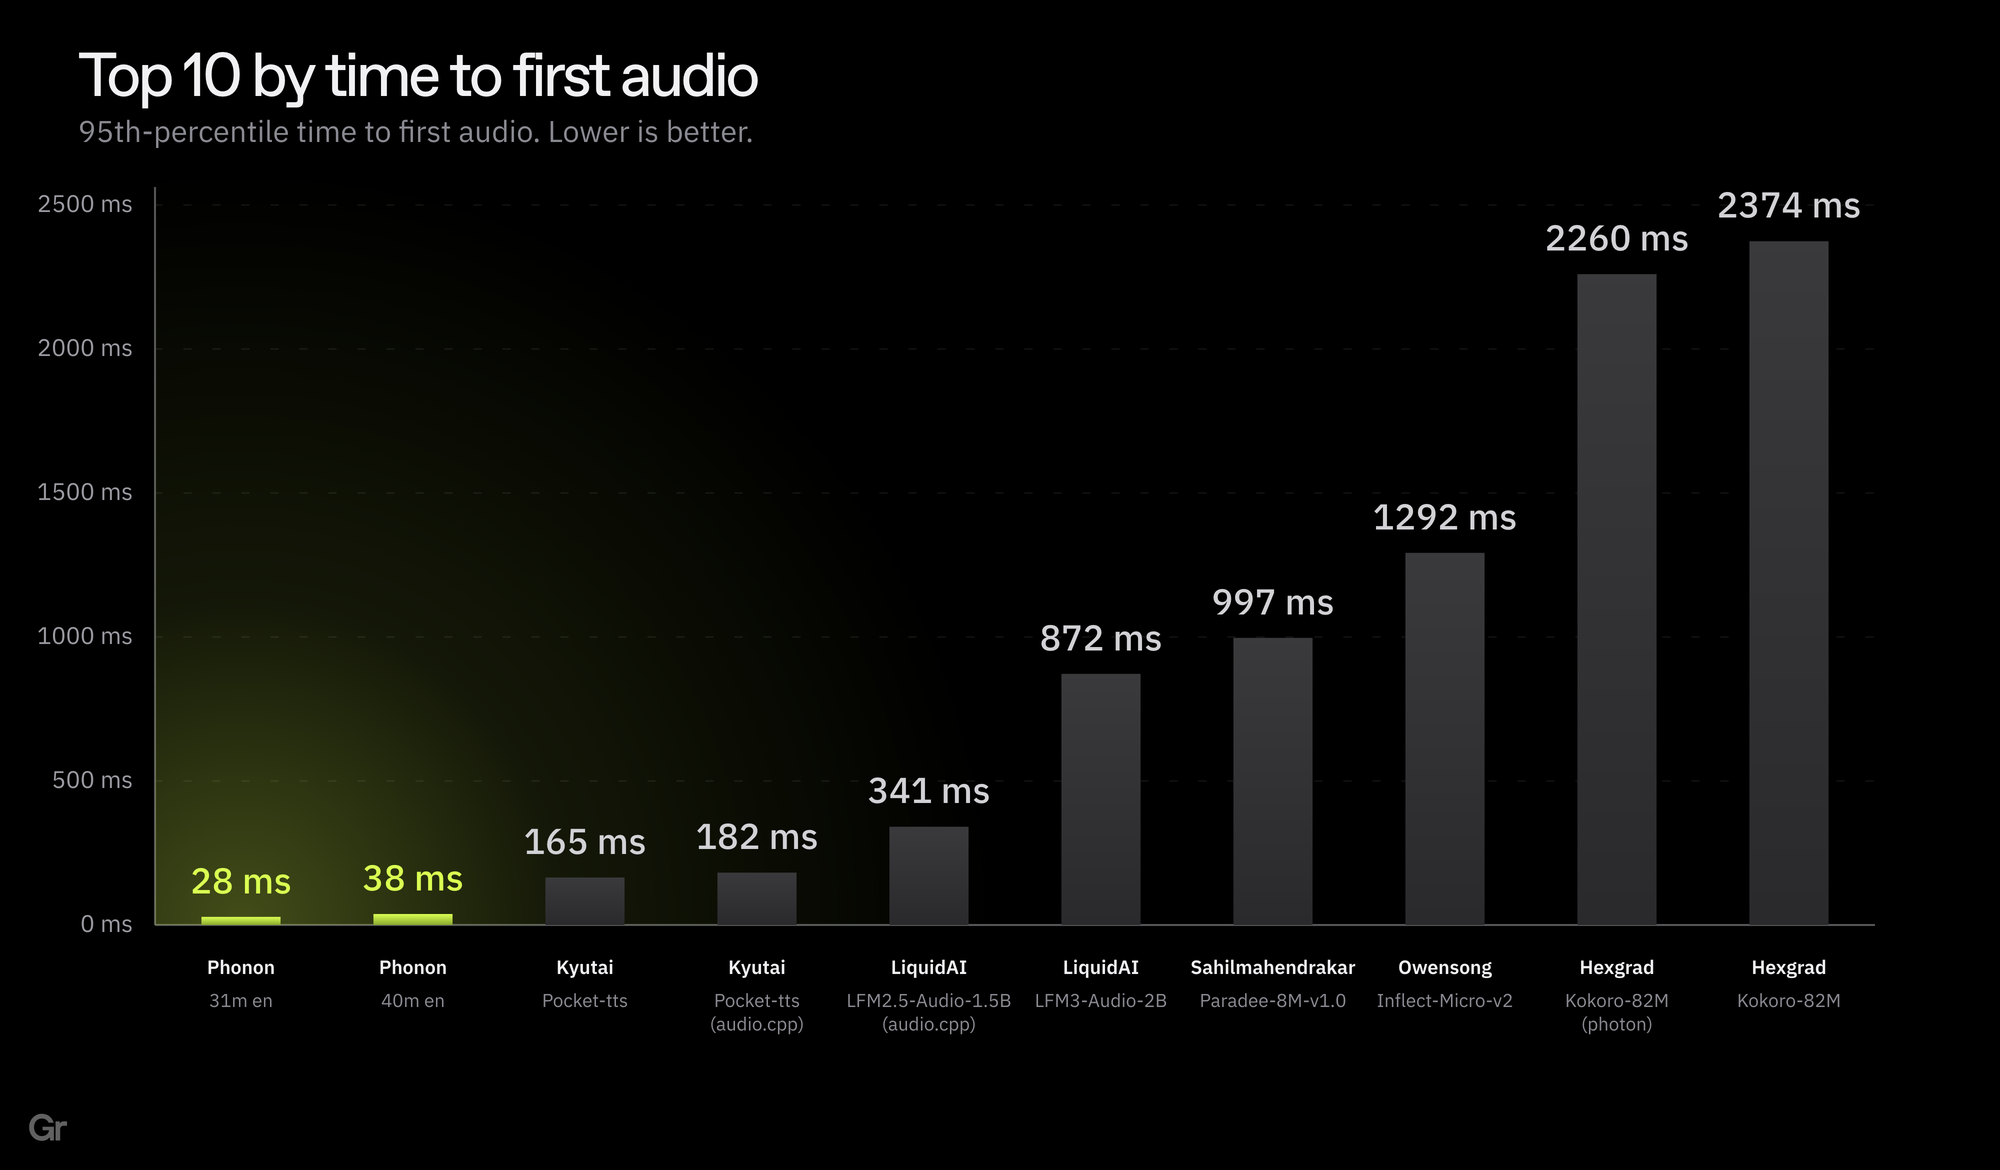
سرعت جایی است که به نظر ما Phonon واقعاً میدرخشد؛ مدلها در بنچمارک استریم CPU بر اساس زمان تا اولین صدا صدر جدول را گرفتهاند.
استنتاج
ما یک چارچوب استنتاج تازه به نام ptts مخصوص Phonon ساختیم. هدف ptts رسیدن به بهترین عملکرد روی طیف گستردهای از دستگاههاست و به همین دلیل از بیش از ۱۰ بکاند پشتیبانی میکند: CPU (اینтел، Arm، WebAssembly)، GPU (CUDA، Vulkan، Metal، WebGPU) و NPU (Apple Core ML، Snapdragon®).
Phonon از نسخه v5.21 در 🤗 Transformers هم در دسترس است، بهعنوان پیادهسازی مرجع PyTorch آن. جایی که ptts یک جریان واحد را روی دستگاه اجرا میکند، Transformers بر توان عملیاتی GPU تمرکز دارد: تولید دستهای و torch.compile با گراف کامل، مثلاً برای ساخت مجموعهدادههای گفتاری در مقیاس بزرگ. چون بومی PyTorch است، پایهای برای ساختن روی آن است؛ چه بخواهید Phonon را در پشته فناوری خودتان ادغام کنید و چه بخواهید خود مدل را مطالعه کنید.
Phonon به تبار Pocket TTS تعلق دارد، پس ابتدا Pocket TTS را به Transformers اضافه کردیم. Phonon بهصورت مدلی ماژولار روی آن قرار میگیرد: حدود ۲۰۰ خط که فقط تفاوتها را توصیف میکند.
Phonon دادههای نهفته صوتی را بهصورت خودرگرسیو تولید میکند: هر گام یک داده نهفته خروجی میدهد که بهعنوان ورودی گام بعدی بازخورانده میشود و تابع زیان آموزش روی همین دادهها محاسبه میشود. دادههای نهفته ورودی، خروجی و هدف مدلاند، همانطور که توکنهای متنی برای یک مدل زبانی چنیناند؛ بنابراین کدکی که صدا را به داده نهفته نگاشت میکند نقش توکنساز را بازی میکند. Transformers آن را دقیقاً همینطور ارائه میکند: یک توکنساز صوتی که پردازشگر در کنار توکنساز متنی نگه میدارد:
from transformers import AutoProcessor, GradiumPhononTTSForConditionalGeneration

model_id = "gradium/phonon-31m-en"
processor = AutoProcessor.from_pretrained(model_id, device_map="auto")
model = GradiumPhononTTSForConditionalGeneration.from_pretrained(model_id, device_map="auto")

print(f"{model.num_parameters():,}")  # 30,788,354
print(f"{processor.audio_tokenizer.num_parameters():,}")  # 10,305,313
صدا یک ضبط نیست، بلکه تانسوری از دادههای نهفته گوینده است. Phonon هرگز صدا را مستقیماً با توکنساز صوتی خود کدگذاری نمیکند، چون این توکنساز فقط رمزگشا دارد، و صداها از پیش محاسبه شدهاند: gradium/phonon-voices.
from huggingface_hub import hf_hub_download
from safetensors.torch import load_file

path = hf_hub_download("gradium/phonon-voices", "voices/LMDIYE0Oa377Qh6Z.safetensors")
voice = load_file(path)["speaker_wavs"][0].T  # (num_frames, 512)
چیدمان اعلان (موقعیت صدا، متن و سپس توکنی که صدا را آغاز میکند) همراه با چکپوینت بهصورت یک قالب چت ارائه میشود، مانند دیگر مدلهای چندوجهی در Transformers. شما یک گفتوگوی استاندارد مینویسید، با یک آیتم صوتی خالی در جایگاه صدا، و کد شما در همه چکپوینتها یکسان میماند. سپس پردازشگر جاینگهدار صدا را به یک موقعیت به ازای هر فریم گسترش میدهد، متن را نرمالسازی و توکنسازی میکند و ورودیها را دستهبندی میکند:
conversation = [
    {"role": "user", "content": [{"type": "audio"}, {"type": "text", "text": "Hello from Phonon."}]}
]
inputs = processor.apply_chat_template(
    conversation,
    tokenize=True,
    return_dict=True,
    add_generation_prompt=True,
    processor_kwargs={"audio_prompt_latents": [voice]},
).to(model.device)
# prompt: <|audio_prompt|> × num_frames, "Hello from Phonon.", <|audio_bos|>
تابع generate دادههای نهفته را برمیگرداند و پردازشگر آنها را به صدا رمزگشایی میکند:
outputs = model.generate(**inputs)  # audio_latents: (batch_size, num_frames, 32)
audio = processor.decode(outputs.audio_latents, outputs.audio_latents_mask)
processor.save_audio(audio, "phonon.wav")
برای اطلاعات بیشتر مستندات 🤗 را ببینید!
قدم بعدی چیست
Phonon میتواند با هر صدایی صحبت کند. با رضایت گوینده، صدایی را از یک ضبط کوتاه شبیهسازی کنید، یا صدایی تازه را با متن ساده در Gradium Studio توصیف کنید. سپس فایل صدا را دانلود کنید، آن را در Phonon بارگذاری کنید و مدل کاملاً روی دستگاه اجرا میشود.
ما همچنین با شرکای طراحی، مدلهای سفارشی Phonon را آموزش میدهیم. اگر بودجهٔ حافظهتان محدود است، میتوانیم مدل را کوچکتر کنیم. اگر به کرهای، عربی یا ژاپنی نیاز دارید، میتوانیم برای آن هم آموزش بدهیم. و اگر محصولتان واژگان اختصاصی خودش را دارد، میتوانیم مدل را روی آن تنظیم دقیق کنیم. با ما در تماس باشید و بگویید چه نیاز دارید.
از تیم Hugging Face و از همه کسانی که در دو هفتهٔ نخست Phonon را امتحان کردند سپاسگزاریم.
Phonon نخستین عرضهٔ باز ماست. امتحانش کنید و بگویید چه میسازید.