مدلهای زبانی بزرگ (LLM) در تولید متن فوقالعادهاند. ما از آنها برای پاسخ دادن به پرسشها، نوشتن کد، استدلال درباره مسائل و کارهای بسیار دیگری استفاده میکنیم. اما هر مسئلهای به تولید متن نیاز ندارد.
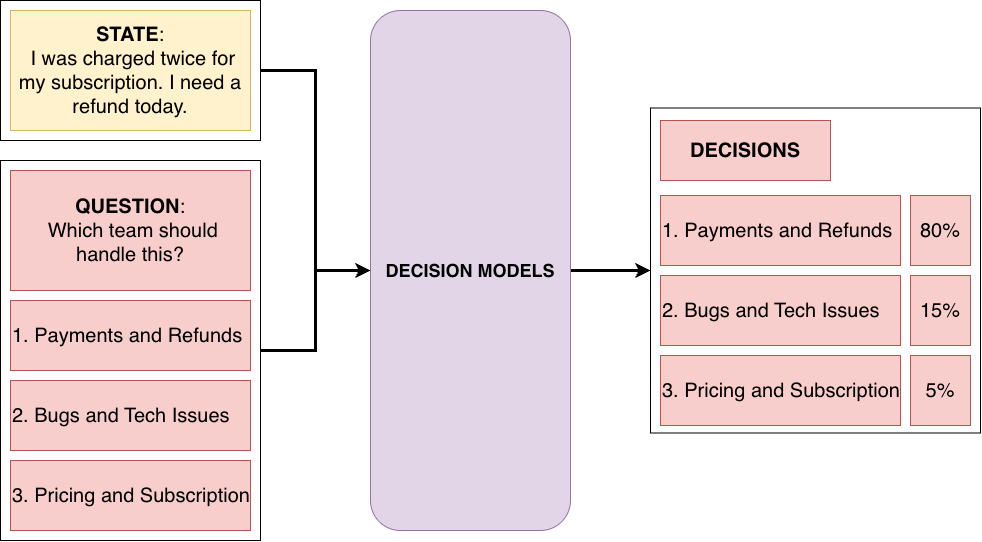
سیستمی پشتیبانی مشتری را در نظر بگیرید که این پیام را دریافت میکند:
«اشتراک من دو بار شارژ شده است. امروز به بازپرداخت نیاز دارم.»
سیستم باید تعیین کند که کدام تیم باید به این درخواست رسیدگی کند، درخواست چقدر فوری است و آیا مشتری خواستار بازپرداخت است یا نه.
میتوانستیم از یک LLM بخواهیم شیء JSON حاوی این پاسخها را برگرداند.
llama cli -hf ggml-org/gemma-4-e4b-it-GGUF:Q4_0

> We have the following customer support ticket, "I was charged twice for my subscription. I need a refund today.", which team should handle the request, how urgent it is, and whether the customer is requesting a refund. Give the answers in JSON.

[Start thinking]
...
[end thinking]
```json
{
  "team_to_handle": "Billing",
  "urgency": "High",
  "request_refund": true
}
اما اگر مدل میتوانست مستقیماً گزینههای موجود را ارزیابی کند و بدون تولید هیچ متنی، توزیع احتمال روی آنها را برگرداند چه؟
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
decision = decide(
    {
        "state": "I was charged twice for my order and want a refund.",
        "questions": {
            "department": {
                "type": "choice",
                "instructions": "Which team should handle this?",
                "criteria": {
                    "billing": "Payments and refunds",
                    "technical": "Bugs and technical issues",
                    "sales": "Pricing and subscriptions"
                }
            },
        }
    }
)

# {
#   'department': {
#       'type': 'choice',
#       'choice': 'billing',
#       'confidence': 0.9974000453948975,
#       'probabilities': {
#         'billing': 0.9982666969299316,
#         'technical': 0.0010246571619063616,
#         'sales': 0.0007087149424478412
#       }
#     }
# }
این ایدهٔ اصلی مدلهای تصمیمگیری است.
مدلهای تصمیمگیری چیستند؟
مدل تصمیمگیری مقداری زمینهٔ ورودی (state) میگیرد، پرسشی را با مجموعهای از پاسخهای ممکن از پیش تعریفشده (primitives) ارزیابی میکند و تصمیمی ساختاریافته همراه با احتمالها برمیگرداند. بهجای آنکه از مدل بخواهیم پاسخی را توکنبهتوکن تولید کند، از آن میخواهیم به پاسخهایی احتمال بدهد که برنامهٔ ما از پیش میشناسد.
TypeSafe AI مدل Jev را معرفی کرد و آن را یک مدل System One توصیف کرد. این نام از تمایز میان تفکر سریع و شهودی (System 1) و تفکر کندتر و تأملی (System 2) الهام گرفته است.
جامعهٔ کاربران بر اصطلاح «مدل تصمیمگیری» توافق کردهاند، چون این اصطلاح نقش محاسباتی مدل را توصیف میکند و به نظریهٔ خاصی از شناخت ارجاع نمیدهد. در ادامهٔ این مطلب، بهجای «مدلهای system one» از «مدلهای تصمیمگیری» استفاده میکنیم. (نظرسنجیای در توییتر دربارهٔ اینکه این مدلها را چه بنامیم)
برای یک مدل تصمیمگیری، رابط بنیادین چنین است:
State + Questions + Allowed Answers → Decisions + Probabilitiesچرا برای همه کارها از LLM استفاده نکنیم؟
میتوانستیم بهسادگی به یک LLM دستور دهیم شیء JSON حاوی تصمیمهایمان را برگرداند. در واقع، بسیاری از برنامهها امروز همینگونه از مدلهای زبانی برای طبقهبندی، مسیریابی و دیگر وظایف ساختاریافته استفاده میکنند.
با این حال، این رویکرد چند مشکل دارد.
LLM تضمینی برای پیروی از ساختار درخواستی نمیدهد: حتی با دستورهای صریح، ممکن است مدل JSON نامعتبر تولید کند، کلیدهای غیرمنتظره اضافه کند یا پاسخی خارج از گزینههای مجاز برگرداند.
رمزگشایی محدودشده کمک میکند، اما سربار محاسباتی را از بین نمیبرد: کتابخانههایی مانند Outlines و XGrammar میتوانند با محدودکردن توکنهایی که مدل در هر مرحله مجاز به تولید آنهاست، گرامر یا JSON schema را اعمال کنند. این کار تضمین میکند خروجی از محدودیتهای ساختاری پشتیبانیشده پیروی کند، اما کار اضافهای به همراه دارد.
چرا کل یک پاسخ تولید شود: LLMها برای تولید بازطراحی شدهاند، اما وقتی برنامهٔ ما فقط باید بین پاسخهای از پیش تعریفشده یکی را انتخاب کند، رمزگشایی خودرگرسیو میتواند کاری غیرضروری باشد.
مدلهای تصمیمگیری چه تفاوتی با مدلهای طبقهبندی دارند؟
پیش از درک رابط مدل تصمیمگیری، مرور دو رویکرد نزدیک به آن یعنی طبقهبندی سنتی و طبقهبندی zero-shot مفید است.
طبقهبندی سنتی
فرض کنید طبقهبندیکنندهای آموزش میدهیم که درخواستهای پشتیبانی مشتری را به سه بخش مسیریابی میکند:
صورتحساب
پشتیبانی فنی
فروش
یک مدل طبقهبندی متعارف نگاشتی از ورودی به مجموعهای از برچسبهای از پیش تعریفشده را یاد میگیرد. در طول آموزش، مدل یاد میگیرد این برچسبها را از روی نمونهها پیشبینی کند. یک سر طبقهبندی معمولاً برای هر کلاس یک لاجیت تولید میکند و softmax آن لاجیتها را به توزیع احتمال تبدیل میکند.
محدودیت اینجا آن است که کلاسهای خروجی در سر طبقهبندی مدل تثبیت شدهاند.
اگر بخش چهارمی، مثلاً حقوقی، اضافه کنیم، طبقهبندیکنندهٔ موجود بهطور خودکار کلاس خروجی متناظر پیدا نمیکند. ممکن است لازم باشد سر مدل را تغییر دهیم، دادهٔ آموزشی جمع کنیم و مدل را دوباره آموزش دهیم یا سازگار کنیم.
طبقهبندی zero-shot
طبقهبندی zero-shot بخش مهمی از این محدودیت را برطرف میکند. بهجای آنکه طبقهبندیکننده الزاماً روی هر دستهٔ خروجی آموزش ببیند، برچسبهای نامزد را در زمان استنتاج در اختیار آن قرار میدهیم.
برای مثال:
from transformers import pipeline

classifier = pipeline(
    "zero-shot-classification",
    model="facebook/bart-large-mnli",
)

classifier(
    "My payment was deducted twice.",
    candidate_labels=["billing", "technical support", "sales"],
)

# {'sequence': 'My payment was deducted twice.',
#  'labels': ['billing', 'sales', 'technical support'],
#  'scores': [0.8466812372207642, 0.0962134450674057, 0.05710534751415253]}
برخلاف یک طبقهبندیکنندهٔ متعارف با برچسبهای ثابت، دستهها میتوانند از یک درخواست به درخواست دیگر تغییر کنند. بیایید بخش دیگری، مثلاً «حقوقی»، را اضافه کنیم و خروجیهای مدل را ببینیم.
from transformers import pipeline

classifier = pipeline(
    "zero-shot-classification",
    model="facebook/bart-large-mnli",
)

classifier(
    "My payment was deducted twice.",
    candidate_labels=["billing", "technical support", "sales", "legal"],
)

# {'sequence': 'My payment was deducted twice.',
#  'labels': ['billing', 'sales', 'technical support', 'legal'],
#  'scores': [0.8185835480690002, 0.09302053600549698, 0.05521026626229286, 0.03318570926785469]}
یکی از پیادهسازیهای رایج از مدلی استفاده میکند که برای استنتاج زبان طبیعی (NLI) آموزش دیده است. هر برچسب نامزد به یک فرضیه تبدیل میشود و مدل میسنجد که ورودی تا چه حد آن فرضیه را نتیجه میدهد.
این توصیف پیشتر بسیار شبیه مدل تصمیمگیری به نظر میرسد. و از بسیاری جهات، چنین است.
تفاوت مدلهای تصمیمگیری کجاست
مدلهای تصمیمگیری این ایده را فراتر از صرفاً نسبتدادن یک ورودی به یک دسته گسترش میدهند. یک مدل تصمیمگیری میتواند چندین پرسش نامدار دربارهٔ همان state را با انواع پاسخ متفاوت بپذیرد. این انواع میتوانند انتخاب بین گزینهها (choice)، امتیازدهی روی یک مقیاس مرتب (score) یا برآورد احتمال درستبودن یک گزاره (noul) باشند.
مهمتر آنکه رابط آن حول توزیع احتمال روی تصمیمهای ممکن طراحی شده است.
این سه رویکرد را در نظر بگیرید:
ویژگی | طبقهبندی | طبقهبندی zero-shot | مدل تصمیمگیری
توزیع احتمال روی گزینهها | بله | بله | بله
برچسبهای تعریفشده در زمان استنتاج | خیر | بله | بله
چند پرسش نوعدار | خیر | خیر | بله
امتیازدهی مرتب و تصمیمهای بله/خیر | وابسته به وظیفه | با سازگارسازی ممکن است | primitives بومی
مزیت مدلهای تصمیمگیری این نیست که برچسبهای تعریفشده در زمان اجرا یا طبقهبندی احتمالاتی را ابداع کردهاند. مزیت آن است که این قابلیتها را در یک رابط یکدست سازمان میدهند که بالقوه بر معماریها و رویههای آموزشی بهینهشده بهطور خاص برای تصمیمگیری تکیه دارد.
رابط مدل تصمیمگیری
یک درخواست به مدل تصمیمگیری دو جزء دارد:
state
questions
State
state اطلاعاتی است که مدل باید ارزیابی کند. میتواند یک رشته، یک شیء JSON ساختاریافته یا، برای مدلهای omni-modal پشتیبانیشده، دیگر شکلهای داده باشد.
برای مثال:
{
  "customer_message": "I was charged twice. Please refund me today.",
  "subscription": "pro",
  "previous_tickets": 2
}پرسشها و primitives آنها
پرسشها توصیف میکنند که دربارهٔ state چه میخواهیم بدانیم. در رابط مدلهای تصمیمگیری، سه primitive بنیادین شکلهای مختلف تصمیم را نمایندگی میکنند:
Choice: انتخاب یکی از چند پاسخ ممکن.
Score: ارزیابی چیزی روی یک مقیاس مرتب.
Noul: پاسخ احتمالاتی به یک پرسش بله/خیر.
بیایید یکییکی آنها را مرور کنیم.
Choice: توزیع احتمال روی گزینهها
Choice شهودیترین primitive و نزدیکترین به طبقهبندی سنتی است.
فرض کنید میپرسیم:
کدام بخش باید به این درخواست مشتری رسیدگی کند؟
گزینههای موجود صورتحساب، پشتیبانی فنی و فروش هستند.
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
decision = decide(
    {
        "state": "I was charged twice for my order and want a refund.",
        "questions": {
            "department": {
                "type": "choice",
                "instructions": "Which team should handle this?",
                "criteria": {
                    "billing": "Payments and refunds",
                    "technical": "Bugs and technical issues",
                    "sales": "Pricing and subscriptions"
                }
            },
        }
    }
)

# {
#   'department': {
#     'type': 'choice',
#     'choice': 'billing',
#     'confidence': 0.9974000453948975,
#     'probabilities': {
#       'billing': 0.9982666969299316,
#       'technical': 0.0010246571619063616,
#       'sales': 0.0007087149424478412
#     }
#   }
# }
مدل به هر گزینه یک لاجیت اختصاص میدهد. برای لاجیتهای z 1 , … , z K z_1,\ldots,z_K z 1 , … , z K (با K K K کلاس) میتوانیم احتمالها را با softmax به دست آوریم:
p i = exp ( z i ) ∑ j = 1 K exp ( z j ) p_i=\frac{\exp(z_i)}{\sum_{j=1}^{K}\exp(z_j)} p i = ∑ j = 1 K exp ( z j ) exp ( z i )
در اینجا K K K تعداد گزینههاست.
این توزیع نمونه را در نظر بگیرید:
Choice | احتمال
صورتحساب | 0.998
پشتیبانی فنی | 0.001
فروش | 0.001
احتمالها به یک جمع میشوند:
∑ i = 1 K p i = 1. \sum_{i=1}^{K}p_i=1. i = 1 ∑ K p i = 1.
مدل گزینهای را انتخاب میکند که بیشترین احتمال را دارد:
y ^ = arg max i p i \hat y=\arg\max_i p_i y ^ = ar g i max p i
در این حالت، انتخاب صورتحساب با احتمال 0.998 است، اما احتمالهای باقیمانده هم مفیدند. آنها نشان میدهند مدل باور خود را چگونه میان گزینهها توزیع میکند.
Score: مقدار انتظاری یک توزیع مرتب
Choice وقتی چند گزینهٔ متمایز وجود دارد کار میکند. اما اگر بخواهیم چیزی را روی یک مقیاس مرتب بسنجیم چه؟
این پرسش را در نظر بگیرید:
این درخواست مشتری چقدر فوری است؟
سه سطح تعریف میکنیم:
0: فوریت کم
1: فوریت متوسط
2: فوریت زیاد
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
decision = decide(
    {
        "state": "I was charged twice for my order and want a refund.",
        "questions": {
            "urgency": {
                "type": "score",
                "instructions": "How urgent is the request?",
                "criteria": ["low", "medium", "high"]
            },
        }
    }
)

# {
#   'urgency': {
#     'type': 'score',
#     'score': 1.7053890228271484,
#     'legend': {
#       '0': 'low',
#       '1': 'medium',
#       '2': 'high'
#     },
#     'confidence': 0.5580834252759814,
#     'probabilities': {
#       '0': 0.014908230863511562,
#       '1': 0.26479458808898926,
#       '2': 0.7202972173690796
#     }
#   }
# }
مدل دوباره یک توزیع احتمال تولید میکند:
سطح | احتمال
0 — کم | 0.01
1 — متوسط | 0.26
2 — زیاد | 0.72
primitive Score بهجای برگرداندن فقط محتملترین سطح، مقدار انتظاری شاخص سطح را محاسبه میکند.
برای متغیر تصادفی X X X که نمایندهٔ سطح است، مقدار انتظاری چنین است:
E [ X ] = ∑ i = 0 K − 1 i p i \mathbb{E}[X]=\sum_{i=0}^{K-1}ip_i E [ X ] = i = 0 ∑ K − 1 i p i
برای مثال ما:
E [ X ] = 0 ( 0.01 ) + 1 ( 0.26 ) + 2 ( 0.72 ) = 1.7 \mathbb{E}[X] = 0(0.01)+1(0.26)+2(0.72)=1.7 E [ X ] = 0 ( 0.01 ) + 1 ( 0.26 ) + 2 ( 0.72 ) = 1.7
بنابراین امتیاز گزارششده 1.7 است.
این به آن معنا نیست که مدل سطحی خیالی میان متوسط و زیاد را انتخاب کرده است؛ معنایش آن است که مقدار انتظاری توزیع احتمال آن 1.7 است.
noul: یک تصمیم برنولی
سومین primitive، noul است که نمایندهٔ یک پرسش دودویی است.
برای مثال:
آیا مشتری خواستار بازپرداخت است؟
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
decision = decide(
    {
        "state": "I was charged twice for my order and want a refund.",
        "questions": {
            "refund": {
                "type": "noul",
                "instructions": "Is the customer requesting a refund?"
            }
        }
    }
)

# {
#   'refund': {
#     'type': 'noul',
#     'noul': 0.9947046637535095
#   }
# }بهجای تعریف فهرستی از گزینهها، از مدل میخواهیم احتمال درستبودن پاسخ را برگرداند. میتوانیم این را با توزیع برنولی درک کنیم (noul از Bernoulli میآید).
فرض کنید Y Y Y نمایندهٔ یک نتیجهٔ دودویی باشد:
Y ∼ Bernoulli ( p ) Y\sim\operatorname{Bernoulli}(p) Y ∼ Bernoulli ( p )
که در آن
P ( Y = 1 ) = p , P ( Y = 0 ) = 1 − p . P(Y=1)=p,\qquad P(Y=0)=1-p. P ( Y = 1 ) = p , P ( Y = 0 ) = 1 − p .
اگر مدل این را برگرداند:
{"type": "noul", "noul": 0.92}این یعنی احتمال 0.92 به «بله» و 0.08 به «خیر» اختصاص داده است.
مدل در اینجا بهطور تصادفی یک پاسخ دودویی نمونهگیری نمیکند؛ خودِ پارامتر احتمال را برمیگرداند و تصمیم دربارهٔ نحوهٔ واکنش را به برنامه واگذار میکند.
confidence: مدل چقدر مطمئن است؟
تا اینجا توزیعهای احتمال را از مدل گرفتهایم. اما رابط مدل تصمیمگیری برای choice و score فیلدی به نام confidence هم برمیگرداند.
توزیع کامل ممکن است چند پاسخ ممکن را در خود داشته باشد و خلاصهکردن میزان تمرکز باور مدل مفید است. با confidence دقیقاً همین کار را میکنیم.
برای یک choice با K K K گزینه، confidence چنین است:
p max − 1 K 1 − 1 K \frac{p_{\max}-\frac{1}{K}}{1-\frac{1}{K}} 1 − K 1 p m a x − K 1
که در آن p max p_{\max} p m a x بزرگترین احتمال پیشبینیشده است.
شهود پشت این فرمول چنین است:
یک توزیع یکنواخت confidence برابر 0 دارد؛ p max = 1 K p_{\max} = \frac{1}{K} p m a x = K 1 . یعنی مدل برآورد میکند همهٔ گزینهها به یک اندازه محتملاند.
توزیعی که کاملاً روی یک گزینه متمرکز است confidence برابر 1 دارد؛ p max = 1 p_{\max} = 1 p m a x = 1
هرچه احتمال گزینهٔ برنده نسبت به توزیع یکنواخت بزرگتر باشد، confidence بالاتر است.
در مثال سهگزینهای پیشین، صورتحساب احتمال 0.998 داشت:
C = 3 ( 0.998 ) − 1 2 = 0.997 C=\frac{3(0.998)-1}{2}=0.997 C = 2 3 ( 0.998 ) − 1 = 0.997
توجه کنید که احتمال گزینهٔ برنده 0.998 است، اما confidence گزارششده 0.997 است. confidence بزرگترین احتمال را نسبت به تعداد گزینههای موجود نرمال میکند. در مقابل، مثال مرتبط با score فقط confidence برابر 0.558 داشت.
مدلهای تصمیمگیری در اکوسیستم Hugging Face
مدلهای تصمیمگیری حوزهای جوان و بهسرعت در حال تغییرند. هر کدام در زیر پوست خود به شکلی متفاوت تصمیم میگیرند (سرهایی که کل schema را یکجا امتیاز میدهند، خوانشهای جداگانه روی بدنهٔ LLM، گونههای سبک برای دستگاههای لبه و گونههای چندوجهی و غیره). این تنوع سالم است، اما هزینهای هم دارد: اگر هر مدل رابط خودش را ارائه دهد، هر ابزاری پیرامون آن به سازگارسازی مخصوص همان مدل نیاز پیدا میکند.
هدف ما در Hugging Face توافق بر یک رابط مشترک است، بدون آنکه پیادهسازی مشترکی را تحمیل کنیم. یک مدل تصمیمگیری باید آزاد باشد در درون خود هر طور که میخواهد کار کند، تا زمانی که همان state و questions را بپذیرد و همان تصمیمهای نوعدار را برگرداند. وقتی این قرارداد وجود داشته باشد، بقیهٔ اکوسیستم میتواند یکبار روی آن ساخته شود:
موتورهای استنتاج مانند llama.cpp میتوانند هر مدل تصمیمگیری را از طریق همان API سرو کنند
و Hub میتواند آنها را بهشکلی یکدست بستهبندی و نمایش دهد
و ابزارهای آموزش میتوانند بهجای معماریهای تکتک، روی primitives مشترک تمرکز کنند
بخشهای بعدی این قسمت هر یک از این اجزا را مرور میکند.
۱. سرو کردن با Transformers
Transformers اکنون از کلاسهای DecisionPipeline، AutoModelForDecision و DecisionConfig پشتیبانی میکند. این کلاسها همان ساختار کلی pipeline و کلاسهای مدل در Transformers را دنبال میکنند، اما مخصوص مدلهای تصمیمگیری ساخته شدهاند.
from transformers import pipeline

decide = pipeline("decision", model="autotrust/GEV-26B-Decide")
print(decide)

# DecisionPipeline: {'model': 'JevForDecision', 'dtype': 'bfloat16', 'device': 'cuda', 'input_modalities': 'text'}
همچنین میتوان پیکربندی و مدل را چنین بررسی کرد:
from transformers import AutoModelForDecision, DecisionConfig

model_id = "autotrust/GEV-26B-Decide"
config = DecisionConfig.from_pretrained(model_id)
model = AutoModelForDecision.from_pretrained(model_id)
Transformers از endpoint /v1/systemone هم پشتیبانی میکند.
میتوانیم با وابستگیهای سرو کردن، یک سرور محلی راهاندازی کنیم:
pip install "transformers[serving]"
transformers serve
سپس با نسخهای سازگار از Transformers میتوانیم یک درخواست تصمیم بفرستیم:
curl http://localhost:8000/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{
    "model": "autotrust/GEV-26B-Decide",
    "state": "I was charged twice. Please refund me today.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and technical issues",
          "sales": "Pricing and subscriptions"
        }
      },
      "urgency": {
        "type": "score",
        "instructions": "How urgent is the request?",
        "criteria": ["low", "medium", "high"]
      },
      "refund": {
        "type": "noul",
        "instructions": "Is the customer requesting a refund?"
      }
    }
  }'
پاسخ شامل سه پاسخ نامدار با نتایج نوعدار و احتمالهای متناظر است.
{
  "model":"autotrust/GEV-26B-Decide",
  "answers":{
    "department":{
      "type":"choice",
      "choice":"billing",
      "confidence":0.9974000453948975,
      "probabilities":{
        "billing":0.9982666969299316,
        "technical":0.0010246571619063616,
        "sales":0.0007087149424478412
        }
    },
    "urgency":{
      "type":"score",
      "score":1.7525686174631119,
      "legend":{"0":"low","1":"medium","2":"high"},
      "confidence":0.6288529792800546,
      "probabilities":{
        "0":0.014000383205711842,
        "1":0.2194305807352066,
        "2":0.7665690183639526
      }
    },
    "refund":{
      "type":"noul",
      "noul":0.9953224062919617
    }
  },
  "usage":{"input_tokens":148,"output_tokens":0}
}
نکتهٔ جالبی آن است که APIهای بالا با مدلهای زبانی خودرگرسیو سازگار هم کار میکنند. Transformers اعلانهای تصمیم را میسازد، لاجیتهای برچسب پاسخ را در یک گذر روبهجلو دستهای ارزیابی میکند و softmax را اعمال میکند، بدون آنکه متن پاسخی تولید شود. این یعنی میتوانیم بدون آنکه لزوماً مدل تازهای آموزش دهیم، رابط تصمیم را آزمایش کنیم.
۲. سرو کردن با llama.cpp
llama.cpp هم از مدلهای تصمیمگیری با همان API /v1/systemone پشتیبانی میکند.
برای مثال، میتوانیم یک مدل تصمیمگیری GGUF را از Hub اجرا کنیم:
llama serve -hf ggml-org/Kev-4B-GGUFسرور پیشفرض روی پورت 9931 اجرا میشود.
سپس میتوانیم درخواستی حاوی همان state و questions را به http://localhost:9931/v1/systemone بفرستیم. چون مدل را سرور انتخاب کرده است، میتوانیم فیلد model را از درخواست حذف کنیم.
ویژگی مفید اینجا سازگاری رابط است.
curl http://localhost:9931/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ggml-org/Kev-4B-GGUF",
    "state": "I was charged twice. Please refund me today.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing": "Payments and refunds",
          "technical": "Bugs and technical issues",
          "sales": "Pricing and subscriptions"
        }
      },
      "urgency": {
        "type": "score",
        "instructions": "How urgent is the request?",
        "criteria": ["low", "medium", "high"]
      },
      "refund": {
        "type": "noul",
        "instructions": "Is the customer requesting a refund?"
      }
    }
  }'
۳. کشف مدلها در Hugging Face Hub
Hugging Face برچسب اختصاصی مدل تصمیمگیری را برای کشف مدلهای سازگار معرفی کرده است. این مفید است، چون مدلهای تصمیمگیری لازم نیست بدنه یا معماری یکسانی داشته باشند.
برای مثال، این اکوسیستم شامل مدلهایی بر پایهٔ معماریهای رمزگذار مانند ModernBERT است و نیز مدلهایی که از بدنهٔ مدلهای زبانی مولد بزرگتر مشتق شدهاند.
۴. آموزش مدلهای تصمیمگیری با ابزارهای Hugging Face
پس از درک استنتاج، پرسش بعدی این است که آیا میتوانیم یک مدل تصمیمگیری را سازگار کنیم. چون مدلهای تصمیمگیری در Transformers ادغام شدهاند، میتوانیم آنها را با Trainer API تنظیم دقیق کنیم.
در ادامه یک مثال ساده آمده است که JEV-9B را برای مسیریابی درخواستهای پشتیبانی تنظیم دقیق میکند. این مثال عمداً کوچک است، اما بخشهایی را نشان میدهد که اهمیت دارند:
هر نمونه یک درخواست تصمیم است (یک state بههمراه questions) که با پاسخ طلایی جفت شده است.
model.decision_config.prepare_inputs درخواست را به ورودیهای مدل تبدیل میکند، همانطور که در زمان استنتاج انجام میدهد.
مدل برای هر گزینه یک لاجیت برمیگرداند، بنابراین یک پرسش choice با یک تابع زیان cross-entropy ساده روی گزینهها آموزش داده میشود.
import os; os.environ["CUDA_VISIBLE_DEVICES"]="2"
import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModelForDecision, Trainer, TrainingArguments

checkpoint = "autotrust/JEV-9B"
tokenizer = AutoTokenizer.from_pretrained(checkpoint)
model = AutoModelForDecision.from_pretrained(checkpoint)

examples = [
    ("I was charged twice. Please refund me.", "refund"),
    ("My package has not arrived.", "shipping"),
    ("The application crashes when I open it.", "technical"),
    ("I want my money back.", "refund"),
    ("Where is my delivery?", "shipping"),
    ("I cannot log into my account.", "technical"),
]

options = {
    "refund": "Billing issues and refunds",
    "shipping": "Orders and deliveries",
    "technical": "Software and account issues",
}

def preprocess(text, label):
    request = {
        "state": text,
        "questions": {
            "category": {
                "type": "choice",
                "instructions": "Classify the support request.",
                "criteria": options,
            }
        },
    }
    (inputs, questions), = model.decision_config.prepare_inputs(
        request, tokenizer
    )
    inputs["marks"] = inputs["marks"].unsqueeze(0)
    inputs["num_options"] = torch.tensor([[len(questions[0].options)]])
    inputs["question_type_ids"] = torch.tensor([[1]])  # choice
    inputs["labels"] = torch.tensor(
        [questions[0].options.index(label)]
    )
    return inputs

dataset = [preprocess(text, label) for text, label in examples]


class DecisionTrainer(Trainer):
    def compute_loss(self, model, inputs, return_outputs=False, **kwargs):
        inputs = inputs.copy()
        labels = inputs.pop("labels")
        logits = model(**inputs)

        logits = logits.unsqueeze(0)  # [3] -> [1, 3]
        loss = F.cross_entropy(logits.float(), labels)

        return (loss, logits) if return_outputs else loss


trainer = DecisionTrainer(
    model=model,
    args=TrainingArguments(
        output_dir="./decision-toy",
        max_steps=30,
        per_device_train_batch_size=1,
        learning_rate=1e-3,
        logging_steps=5,
        save_strategy="no",
        report_to="none",
        remove_unused_columns=False,
    ),
    train_dataset=dataset,
    data_collator=lambda batch: batch[0],
)

trainer.train()
پشتیبانی درجهیک از آموزش مدلهای تصمیمگیری قرار است به TRL هم اضافه شود (huggingface/trl#8040)، پس لازم نیست این زیرساخت را دستی بنویسیم. در زمان نگارش این مطلب، آن PR هنوز باز است.
اگر بخواهیم جلوتر برویم و یک LLM مولد را به مدل تصمیمگیری تبدیل کنیم، Unsloth دستورالعملی ارائه میدهد که مدلهایی مانند Qwen را با LoRA و یک سر امتیازدهی تصمیم تنظیم دقیق میکند.
جمعبندی
مدلهای تصمیمگیری جالباند نه به این دلیل که طبقهبندی چیز تازهای است، بلکه به این دلیل که تصمیمها و احتمالها را به خروجیهای درجهیک نرمافزار تبدیل میکنند.
طبقهبندیکنندههای سنتی از پیش احتمال تولید میکنند و طبقهبندیکنندههای zero-shot از پیش امکان تعریف دستهها در زمان اجرا را فراهم میکنند. مدلهای تصمیمگیری این ایدهها را در یک رابط نوعدار با چند primitive پرسش، امتیازدهی غیرمولد و امکان آموزش تخصصی برای تصمیمهای قابل اتکا و کالیبرهشده گرد هم میآورند.