 نگار رضایی
فایل robots.txt از دیرباز ابزار ضروری برای مدیریت دسترسی خزندهها به یک وبسایت بوده است. حالا که ابزارهای جستوجوی هوش مصنوعی و عاملهای هوشمند در کنار خزندههای سنتی از وبسایتها بازدید میکنند، باید بدانید هر کدام از این خزندهها از چه قواعدی پیروی میکنند.
اما مسدودکردن خزندهٔ اشتباه میتواند محتوای شما را از مدلهای زبانی بزرگ (LLM) یا نتایج موتور جستوجو (SERP) بیرون بیندازد، و باز گذاشتن نشانیهای غیرضروری در سایتهای بزرگ میتواند بودجهٔ خزش (crawl budget) را هدر بدهد. پس باید بدانید چه میکنید.
این راهنما کمک میکند بفهمید قواعد robots.txt چطور کار میکنند تا از اشتباههای رایج robots.txt دوری کنید، محتوای مفید را در دسترس نگه دارید و در همان حال خزش غیرضروری را محدود کنید.
robots.txt چیست؟
فایل robots.txt یک فایل متنی ساده است که در پوشهٔ ریشهٔ سایت قرار میگیرد و به خزندهها میگوید چه چیزی باید خزش شود.
جدول زیر مرجعی سریع برای دستورهای اصلی robots.txt است.
دستور | توضیح
User-agent | مشخص میکند قواعد برای کدام خزنده اعمال میشود. توکنهای عامل کاربر را ببینید. استفاده از * قواعد جایگزین را برای خزندههایی تعیین میکند که گروه اختصاصی منطبقی ندارند.
Disallow | از خزندههای پیرو قواعد میخواهد مسیرهای مشخصشدهٔ URL را خزش نکنند.
Allow | اجازه میدهد نشانیهای مشخصی خزش شوند، حتی اگر پوشهٔ والد مسدود شده باشد.
Sitemap | با اعلام محل نقشهٔ XML سایت، به موتورهای جستوجو در کشف آن کمک میکند.
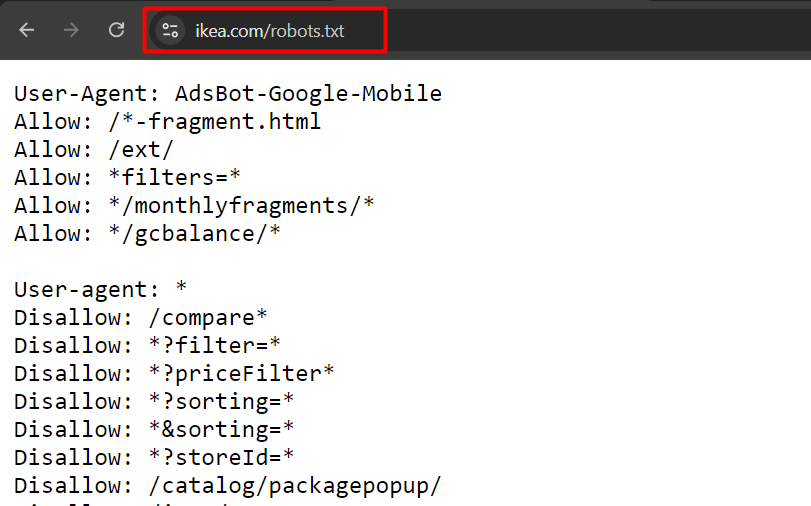
این تصویر مربوط به سال ۲۰۲۴ نمونهای از robots.txt سایت ikea.com را با چند قاعده نشان میدهد.
توجه کنید که robots.txt از عبارتهای باقاعدهٔ کامل پشتیبانی نمیکند و فقط دو نویسهٔ عام دارد:
ستاره (*) که با صفر یا چند نویسه مطابقت دارد.
علامت دلار ($) که با پایان URL مطابقت دارد.
همچنین توجه کنید که تطبیق مسیر URL حساس به حروف بزرگ و کوچک است؛ مثلاً «filter=» با «Filter=» یکسان نیست. اما نام دستورها و تطبیق عامل کاربر حساس به حروف بزرگ و کوچک نیستند.
ترتیب اولویت در robots.txt
هنگام تنظیم فایل robots.txt مهم است بدانید موتورهای جستوجو در صورت تعارض قواعد، به چه ترتیبی تصمیم میگیرند کدام قاعده را اعمال کنند.
وقتی برای یک خزنده مجموعهٔ قواعد جداگانهای مینویسید، آن خزنده بهجای قواعد زیر User-agent: * از همان قواعد خودش پیروی میکند. برای نمونه:
User-agent: *
Disallow: /private/

User-agent: Googlebot
Allow: /
در اینجا Googlebot میتواند /private/ را خزش کند، چون قواعد اختصاصی خودش اجازهٔ خزش همهٔ نشانیها را میدهد. برای مسدودکردن این پوشه برای Googlebot، خط Disallow: /private/ را زیر خط Allow: / آن اضافه کنید.
گوگل در گروه قواعد قابل اعمال، این دو قاعدهٔ کلیدی را دنبال میکند:
۱. قاعدهٔ خاصتر
قاعدهای اعمال میشود که با نویسههای بیشتری در URL مطابقت دارد. برای نمونه:
User-agent: *
Disallow: /downloads/
Allow: /downloads/free/
در این حالت، قاعدهٔ «Allow: /downloads/free/» از «Disallow: /downloads/» خاصتر است، چون یک زیرپوشه را هدف میگیرد.
گوگل خزش زیرپوشهٔ «/downloads/free/» را مجاز میداند اما بقیهٔ مسیرهای زیر «/downloads/» را مسدود میکند.
۲. قاعدهٔ کممحدودیتتر
وقتی چند قاعده به یک اندازه خاص باشند، مثلاً:
User-agent: *
Disallow: /downloads/
Allow: /downloads/
گوگل کممحدودیتترین را انتخاب میکند. یعنی دسترسی به /downloads/ را مجاز میداند.
چرا robots.txt در سئو مهم است؟
مسدودکردن صفحههایی که نیازی به دیدهشدن در نتایج جستوجو ندارند (مثلاً سیاست حفظ حریم خصوصی) با robots.txt، خزش هدررفته را کاهش میدهد و میتواند به Googlebot کمک کند بودجهٔ خزش خود را روی نشانیهای مفید (مثلاً صفحههای اصلی محصول یا خدمت) متمرکز کند. گوگل هشدار میدهد که این کار بهطور خودکار بودجهٔ خزش را به صفحههای دیگر منتقل نمیکند، مگر اینکه سایت از قبل به سقف ظرفیت خزش خود رسیده باشد. این کار همچنین به موتورهای جستوجو کمک میکند در توان محاسباتی صرفهجویی کنند و به پایداری بیشتر کمک میشود.
یادآوری گوگل در سال ۲۰۲۴ دربارهٔ URLهای action بر پیوندهای افزودن به سبد خرید و فهرست علاقهمندیها تمرکز داشت؛ پیوندهایی که منابع خزنده و سرور را هدر میدهند.
فرض کنید فروشگاه اینترنتیای با صدها هزار صفحه دارید. بخشهایی از وبسایتها، مثل صفحههای فیلترشده، ممکن است نسخههای بیشماری داشته باشند. این صفحهها ارزش یکتا ندارند، در عمل محتوای تکراری دارند و میتوانند فضای خزش بیپایانی بسازند و منابع سرور شما و Googlebot را هدر بدهند. اینجاست که robots.txt به کار میآید و مانع خزش این صفحهها توسط خزندههای موتور جستوجو میشود.
اگر این کار را نکنید، گوگل ممکن است تلاش کند شمار بیپایانی از نشانیها را با مقادیر مختلف (حتی ناموجود) پارامتر جستوجو خزش کند و این باعث جهش درخواستها و هدررفتن بودجهٔ خزش شود.
چه زمانی از robots.txt استفاده کنیم
بهعنوان یک قاعدهٔ کلی، همیشه باید بپرسید چرا صفحههای مشخصی وجود دارند و آیا ارزشی برای خزش و ایندکسشدن توسط موتورهای جستوجو دارند یا نه.
بسته به سایت و اهداف ایندکس شما، گزینههای محدودکردن خزش شامل این موارد است:
نشانیهایی که پارامتر پرسوجو دارند، مانند: جستوجوی داخلی. نشانیهای ناوبری فستدار (faceted navigation) که با گزینههای فیلتر یا مرتبسازی ساخته میشوند، اگر بخشی از ساختار URL و راهبرد سئو نباشند. URLهای action مانند افزودن به فهرست علاقهمندیها یا افزودن به سبد خرید.
بخشهای حساب کاربری که نیازی به دیدهشدن در جستوجو ندارند. اطلاعات خصوصی را مستقل از قواعد robots.txt با احراز هویت محافظت کنید.
فایلهای جاوااسکریپت که به محتوا یا رندر وبسایت مربوط نیستند، مثل اسکریپتهای ردیابی.
خزندههای آموزش هوش مصنوعی یا خزندههای دیگری که میخواهید استفادهٔ مستندشدهٔ آنها را محدود کنید؛ در این کار دسترسی جستوجو و دسترسی به درخواست کاربر را جداگانه در نظر بگیرید.
بیایید نمونههای استفاده از robots.txt را برای هر مورد بررسی کنیم.
۱. مسدودکردن صفحههای جستوجوی داخلی
نتایج جستوجوی داخلی منبع رایج خزش غیرضروری توسط گوگل و دیگر موتورهای جستوجو هستند. اگر قرار نیست این نتایج در جستوجو نمایش داده شوند، محدودکردن فضای خزش آنها را در نظر بگیرید.
در وبسایتهای وردپرسی، معمولاً پارامتر «s» است و URL چنین شکلی دارد:
https://www.example.com/?s=googleگری ایلیس (Gary Illyes) از گوگل بارها هشدار داده است که URLهای action را مسدود کنید، چون میتوانند باعث شوند Googlebot آنها را بیپایان خزش کند، حتی نشانیهای ناموجود با ترکیبهای مختلف.
این قاعدهای است که میتوانید در robots.txt برای جلوگیری از خزش چنین نشانیهایی به کار ببرید:
User-agent: *
Disallow: /*?s=
Disallow: /*?*&s=
User-agent: * قواعد جایگزین را برای خزندههایی تعیین میکند که گروه اختصاصی منطبقی ندارند.
Disallow: /*?s= پارامتر s را در جایگاه نخست پارامتر پرسوجو تطبیق میدهد. Disallow: /*?*&s= آن را پس از پارامتر دیگری تطبیق میدهد. هر دو مسیر با / شروع میشوند تا با نام پارامتر دیگری که فقط به s ختم میشود اشتباه گرفته نشوند.
نام پارامتر حساس به حروف بزرگ و کوچک میماند، پس این قواعد با /?S= مطابقت ندارند. ترتیب و املای پارامتری را که سایت شما واقعاً به کار میبرد آزمایش کنید.
این تصویر از گزارش آمار خزش، که در راهنمای اصلی سال ۲۰۲۴ آمده بود، کاهش خزش نشانیهای ناموجود جستوجوی داخلی را پس از مسدودشدن با robots.txt نشان میدهد.
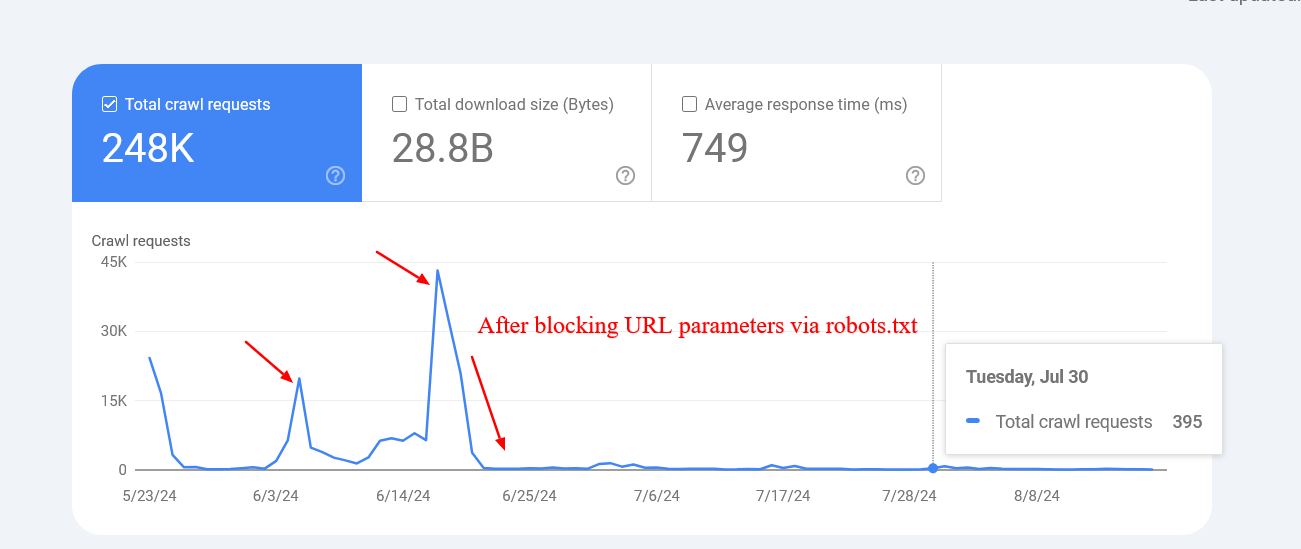
توجه کنید که گوگل ممکن است صفحههای مسدودشده را بر اساس پیوندهای موجود به نشانیهایشان ایندکس کند. robots.txt حذف آنها از نتایج جستوجو را تضمین نمیکند. اگر هدف حذف است، از noindex استفاده کنید و اجازه دهید گوگل صفحه را خزش کند تا بتواند آن دستور را بخواند.
۲. مسدودکردن نشانیهای ناوبری فستدار
ناوبری فستدار بخش جداییناپذیر هر وبسایت فروشگاهی است. ممکن است در مواردی ناوبری فستدار بخشی از راهبرد سئو باشد و هدفش رتبهگرفتن در جستوجوهای عمومی محصول باشد.
صفحههای فرود مبتنی بر رنگ Zalando، مثل صفحههایی که «تیشرت خاکستری» را هدف میگیرند، این رویکرد را نشان میدهند. اصل کار این است که صفحههای فرود مفید برای جستوجو خزشپذیر بمانند و ترکیبهای فیلتر ناخواسته محدود شوند.
اما در بیشتر موارد اینطور نیست و پارامترهای فیلتر فقط برای فیلترکردن محصولات به کار میروند و دهها صفحه با محتوای تکراری میسازند.
ممکن است در یک URL چند پارامتر فیلتر وجود داشته باشد. مشخص کنید کدامها فضای خزش ناخواسته میسازند؛ فستهایی را که بخشی از راهبرد جستوجوی شما هستند مسدود نکنید. راهنمای گوگل دربارهٔ ناوبری فستدار این دو حالت را از هم جدا میکند.
برای نمونه، اگر فیلترهایی با پارامترهای «sortby»، «color» و «price» دارید، میتوانید از این مجموعه قواعد استفاده کنید:
User-agent: *
Disallow: /*?sortby=
Disallow: /*?*&sortby=
Disallow: /*?color=
Disallow: /*?*&color=
Disallow: /*?price=
Disallow: /*?*&price=
این جفتها هر پارامتر را در جایگاه نخست یا پس از پارامتر دیگری تطبیق میدهند. فقط پارامترهایی را اضافه کنید که قصد محدودکردنشان را دارید و هم نشانیهای مطلوب و هم ناخواسته را آزمایش کنید.
پارامترهای UTM چه؟
پارامترهای UTM برای ردیابی به کار میروند.
در گفتوگوی Reddit که در تصویر زیر آمده، جان مولر (John Mueller) به پارامترهای ردیابی در پیوندهای بیرونی پرداخته است. این بافت را از نشانیهای فیلتر یا جستوجویی که خود سایت میسازد جدا نگه دارید.
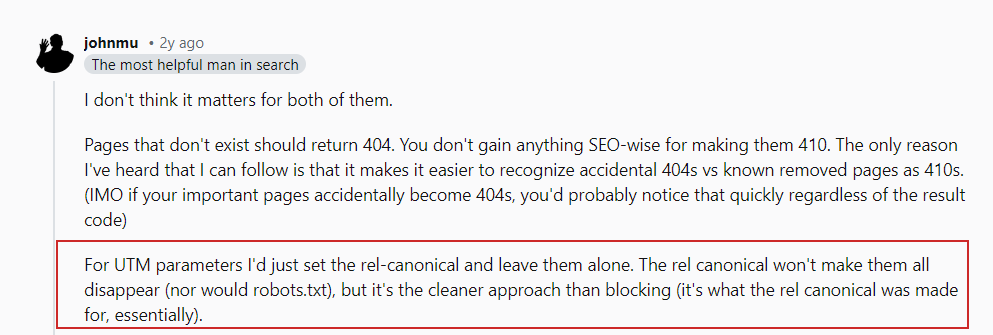
پیوندهای داخلی را به نشانیهایی معطوف نگه دارید که میخواهید خزش شوند. دربارهٔ مسدودکردن یک پارامتر بر اساس کاری که در سایت شما انجام میدهد تصمیم بگیرید؛ صرف وجود رشتهٔ پرسوجو دلیلی برای مسدودکردن صفحه نیست.
۳. مسدودکردن نشانیهای PDF
فرض کنید اسناد PDF زیادی دارید، مثل راهنمای محصول، بروشور یا مقالههای قابل دانلود، و نمیخواهید خزش شوند.
این قاعدهٔ سادهٔ robots.txt دسترسی خزندههای موتور جستوجو به این اسناد را مسدود میکند:
User-agent: *
Disallow: /*.pdf$
خط «Disallow: /*.pdf$» به خزندهها میگوید هیچ نشانیای که به .pdf ختم میشود را خزش نکنند.
با استفاده از /*، قاعده با هر مسیری در وبسایت مطابقت میکند. در نتیجه هر نشانیای که به .pdf ختم شود از خزش مسدود میشود. این قاعده با /guide.pdf?download=1 یا پسوند بزرگ .PDF مطابقت نمیکند؛ چنین حالتهایی را جداگانه آزمایش کنید. اگر میخواهید یک PDF از نتایج جستوجو حذف شود، از هدر HTTP با نام X-Robots-Tag: noindex استفاده کنید و صفحه را خزشپذیر نگه دارید تا گوگل بتواند هدر را بخواند.
اگر وبسایت وردپرسی دارید و میخواهید PDFهای پوشهٔ uploads، جایی که از طریق سیستم مدیریت محتوا بارگذاری میکنید، مسدود شوند، میتوانید از این قاعده استفاده کنید:
User-agent: *
Disallow: /wp-content/uploads/*.pdf$
Allow: /wp-content/uploads/2024/09/allowed-document.pdf$میبینید که اینجا قواعد متعارض داریم.
در صورت تعارض قواعد، قاعدهٔ خاصتر اولویت دارد؛ یعنی خط آخر تضمین میکند فقط فایل مشخصی که در پوشهٔ «wp-content/uploads/2024/09/allowed-document.pdf» قرار دارد اجازهٔ خزش داشته باشد.
۴. مسدودکردن یک پوشه
فرض کنید یک نقطهٔ پایانی API دارید که دادههای فرم را به آن میفرستید. احتمالاً فرم شما ویژگی action دارد، مثل action=”/form/submissions/.”
اگر خزندهای نشانی /form/submissions/ را کشف کند، ممکن است بخواهید از خزش آن مسیر جلوگیری کنید. میتوانید این درخواست را با این قاعده مطرح کنید:
User-agent: *
Disallow: /form/
با مشخصکردن یک پوشه در قاعدهٔ Disallow، به خزندهها میگویید از خزش همهٔ صفحههای زیر آن پوشه دوری کنند و دیگر لازم نیست از نویسهٔ عام (*) استفاده کنید، مثل «/form/*».
توجه کنید که در دستورهای Disallow و Allow همیشه باید مسیرهای نسبی بنویسید و هرگز نشانی مطلق، مثل «https://www.example.com/form/»، به کار نبرید.
مراقب قواعد بدشکل باشید. برای نمونه، استفاده از /form بدون اسلش پایانی با صفحهٔ /form-design-examples/ هم مطابقت میکند که ممکن است صفحهای در وبلاگ شما باشد که میخواهید ایندکس شود.
بخوانید: ۸ مشکل رایج robots.txt و راه رفع آنها
۵. مسدودکردن نشانیهای حساب کاربری
اگر وبسایت فروشگاهی دارید، احتمالاً پوشههایی دارید که با «/myaccount/» شروع میشوند، مثل «/myaccount/orders/» یا «/myaccount/profile/».
با توجه به اینکه صفحهٔ اصلی «/myaccount/» یک صفحهٔ ورود است که میخواهید ایندکس شود و کاربران آن را در جستوجو پیدا کنند، ممکن است بخواهید زیرصفحهها توسط Googlebot خزش نشوند.
میتوانید قاعدهٔ Disallow را همراه با قاعدهٔ Allow به کار ببرید تا همهچیز زیر پوشهٔ «/myaccount/» مسدود شود (بهجز خود صفحهٔ /myaccount/).
User-agent: *
Disallow: /myaccount/
Allow: /myaccount/$
و باز هم چون گوگل قاعدهٔ خاصتر را به کار میبرد، همهچیز زیر پوشهٔ /myaccount/ مسدود میشود اما فقط صفحهٔ /myaccount/ اجازهٔ خزش دارد.
نمونهٔ دیگری از ترکیب قواعد Disallow و Allow: اگر جستوجوی شما زیر پوشهٔ /search/ باشد و میخواهید پیدا و ایندکس شود اما نشانیهای واقعی جستوجو مسدود شوند:
User-agent: *
Disallow: /search/
Allow: /search/$
۶. مسدودکردن فایلهای جاوااسکریپت نامرتبط با رندر
هر وبسایتی از جاوااسکریپت استفاده میکند و بسیاری از این اسکریپتها به رندر محتوا مربوط نیستند، مثل اسکریپتهای ردیابی یا اسکریپتهایی که برای بارگذاری AdSense به کار میروند.
فقط پس از اطمینان از اینکه اسکریپت برای رندر محتوا و پیوندهایی که میخواهید ایندکس شوند ضروری نیست، آن را مسدود کنید. با URL Inspection صفحهٔ رندرشده را بررسی کنید؛ مسدودکردن یک بستهٔ مشترک یا اسکریپتی که وابستگی رندر دارد میتواند مانع دیدن محتوای مهم توسط گوگل شود. فایل robots.txt روی میزبان شما هم نمیتواند اسکریپتی را که از میزبان دیگری بارگذاری میشود کنترل کند.
در زیر خط نمونهای آمده که جاوااسکریپت نمونهای حاوی پیکسلهای ردیابی را مسدود میکند.
User-agent: *
Disallow: /assets/js/pixels.js
۷. کنترل خزندههای هوش مصنوعی و اسکرپرها
میتوانید خزندههای آموزش را مسدود کنید و در همان حال اجازه دهید ابزارهای هوش مصنوعی صفحههای شما را پیدا کنند و برای کاربران بازیابی کنند. نکتهٔ کلیدی این است که برای خزندههای آموزش، جستوجو و درخواست کاربر قواعد جداگانه تعیین کنید.
ناشران ممکن است آموزش را مسدود کنند تا استفاده از گزارشهایشان بدون ذکر منبع محدود شود، در حالی که برندهای فروشگاهی ممکن است از آن استقبال کنند، اگر اشاره به محصولات باعث شود مردم جستوجو و خرید کنند. چون منافع این کار برای هر کسبوکار متفاوت است، توسعهدهندگان باید این قواعد را با ذینفعان تعیین کنند.
مسدودکردن خزندههای آموزش تضمین نمیکند که محتوای شما از مجموعهدادههای آموزش بیرون بماند، چون خزندههایی که robots.txt را نادیده میگیرند همچنان میتوانند آن را جمعآوری کنند. همچنین ابزارهای هوش مصنوعی را مجبور نمیکند از سایت شما بازدید یا به آن استناد کنند، چون ممکن است اطلاعات را جای دیگری پیدا کنند.
مطالعهای از BuzzStream که SEJ در ژانویهٔ ۲۰۲۶ پوشش داد نشان داد ۷۹٪ از سایتهای خبری آمریکا و بریتانیا که بررسی شده بودند دستکم یک خزندهٔ آموزش را مسدود کرده بودند و ۷۱٪ دستکم یک خزندهٔ بازیابی یا جستوجوی زنده را. چون بازیابی به ابزارهای هوش مصنوعی کمک میکند صفحههای شما را پیدا و به آنها استناد کنند، مسدودکردن این خزندهها تصمیمی جدا از انصراف از آموزش است.
مسدودکردن خزندههای آموزش و اجازهدادن به خزندههای جستوجو و کاربر
OpenAI از OAI-SearchBot برای نمایش وبسایتها در پاسخهای جستوجوی ChatGPT استفاده میکند، در حالی که ChatGPT-User بازدیدهای بهدرخواست کاربر را مدیریت میکند. چون مجوزهای جستوجو و آموزش جدا هستند، میتوانید OAI-SearchBot و ChatGPT-User را مجاز کنید و GPTBot را مسدود کنید.
این نمونه خزندههای آموزش OpenAI و Anthropic را مسدود میکند و در همان حال خزندههای جستوجو و درخواست کاربر آنها و همچنین خزندههای Perplexity را مجاز میداند:
# Block model-training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
Disallow: /

# Allow search and user-requested visits
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /private/
در نمونهٔ بالا، /private/ یک پوشهٔ استثناشده است. آن را با هر مسیری که میخواهید این خزندهها از خزش آن دوری کنند جایگزین کنید.
بیشتر خزندههای اصلی هوش مصنوعی از robots.txt پیروی میکنند، از جمله GPTBot از OpenAI و ClaudeBot از Anthropic.
بازدیدهای بهدرخواست کاربر متفاوت عمل میکنند، چون بعضی ارائهدهندگان به خزندههایشان اجازه میدهند هنگام انجام درخواست کاربر robots.txt را دور بزنند یا عموماً آن را نادیده بگیرند. OpenAI میگوید ممکن است robots.txt برای ChatGPT-User اعمال نشود و Perplexity میگوید Perplexity-User عموماً آن را نادیده میگیرد. Anthropic میگوید خزندههایش، از جمله Claude-User، robots.txt را رعایت میکنند. چون robots.txt فقط به خزندهها میگوید کدام نشانیها را میتوانند خزش کنند، برای محافظت از محتوای خصوصی به احراز هویت نیاز دارید.
خزندههای درخواست کاربر | robots.txt را رعایت میکند؟
ChatGPT-User | خیر
Perplexity-User | خیر
Claude-User | بله
Google-Agent | خیر
Google-GeminiNotebook | خیر
MistralAI-User | بله
meta-externalfetcher | خیر
Amzn-User | خیر
توکنهای خزنده و سیاستهای robots.txt برای بازدیدهای مرورگری Copilot، Grok، DeepSeek و Meta Muse همچنان نامشخص است، چون نتوانستم آنها را در مستندات عمومی ارائهدهندگان تأیید کنم.
محدودکردن استفادههای آموزشی گوگل و اپل
گوگل و اپل توکنهای جداگانهای در robots.txt برای کنترل نحوهٔ استفاده از محتوای خزششده ارائه میدهند:
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /
Google-Extended آموزش Gemini و کاربردهای مشخص grounding را پوشش میدهد؛ کاربردهایی که در آنها محتوای منبع به تولید پاسخ کمک میکند. مسدودکردن آن Googlebot را مسدود نمیکند و بر حضور عادی در جستوجوی گوگل اثری ندارد. Applebot-Extended آموزش مدلهای پایه را کنترل میکند بدون اینکه خزش جستوجویی Applebot را مسدود کند. هیچکدام از این دو توکن خزندهٔ مستقل نیستند، پس این قواعد بهتنهایی درخواستهای خزش را کاهش نمیدهند.
پس از تغییر فایل، فایلهای لاگ سرور را بررسی کنید و مطمئن شوید فایروال شما به خزندههایی که میخواهید اجازه میدهد. وقتی به اعمال محدودیت دسترسی نیاز دارید، از کنترلهای سرور یا CDN استفاده کنید.
برای پیشزمینه، پوشش پیشین SEJ دربارهٔ استفادهٔ هوش مصنوعی از محتوا و ترافیک چتباتهای هوش مصنوعی را ببینید.
۸. مشخصکردن نشانی نقشهٔ سایت
درج نشانی نقشهٔ سایت در فایل robots.txt به موتورهای جستوجو کمک میکند همهٔ صفحههای مهم وبسایت شما را بهراحتی کشف کنند. این کار با افزودن خط مشخصی انجام میشود که به محل نقشهٔ سایت اشاره میکند و میتوانید چند نقشهٔ سایت را مشخص کنید، هر کدام در خط خودش.
Sitemap: https://www.example.com/sitemap/articles.xml
Sitemap: https://www.example.com/sitemap/news.xml
Sitemap: https://www.example.com/sitemap/video.xml
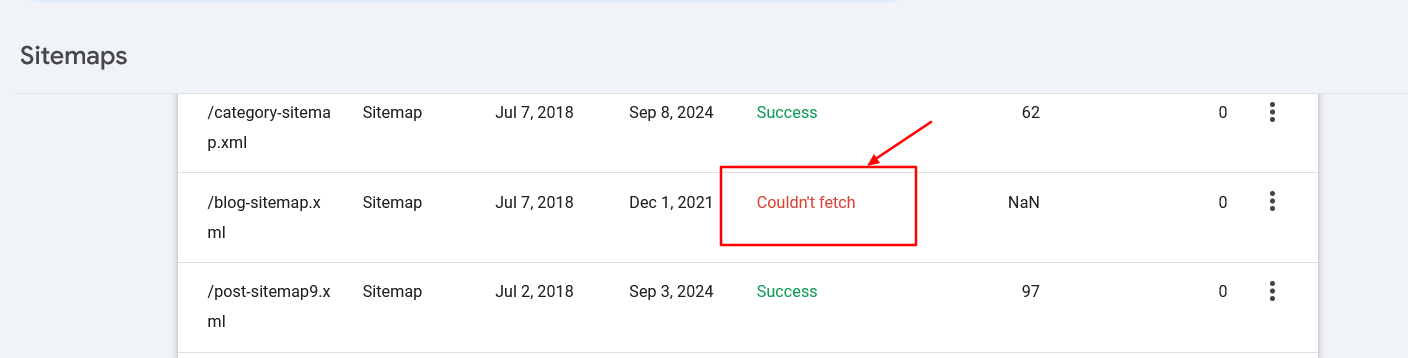
برخلاف قواعد Allow یا Disallow که فقط مسیر نسبی میپذیرند، دستور Sitemap به نشانی کامل و مطلق نیاز دارد تا محل نقشهٔ سایت را نشان دهد.
مطمئن شوید نشانی نقشههای سایت برای موتورهای جستوجو در دسترس است و نحو درستی دارد تا از خطا جلوگیری شود.
۹. چه زمانی از Crawl-delay استفاده کنیم
دستور Crawl-delay در robots.txt تعداد ثانیههایی را مشخص میکند که یک خزنده باید پیش از خزش صفحهٔ بعدی صبر کند. Googlebot دستور Crawl-delay را نمیشناسد، اما خزندههای دیگر ممکن است آن را رعایت کنند.
این دستور با کنترل دفعات خزش خزندهها از سایت شما به جلوگیری از اضافهبار سرور کمک میکند.
برای نمونه، اگر میخواهید ClaudeBot محتوای شما را برای آموزش هوش مصنوعی خزش کند اما از اضافهبار سرور جلوگیری کنید، میتوانید تأخیر خزش تعیین کنید تا فاصلهٔ بین درخواستها مدیریت شود.
User-agent: ClaudeBot
Crawl-delay: 60
این خط از ClaudeBot تأخیر ۶۰ ثانیهای میخواهد؛ Anthropic مستند کرده است که از افزونهٔ غیراستاندارد Crawl-delay پشتیبانی میکند. این را وقتی به کار ببرید که قصد دارید آن خزش را مجاز کنید. افزودن تأخیر قاعدهٔ Disallow: / را برای همان خزنده باطل نمیکند؛ کل گروه را بازبینی کنید، نه اینکه هر دو سیاست را کپی کنید.
البته ممکن است خزندههای هوش مصنوعیای باشند که دستورهای تأخیر خزش را رعایت نکنند. در این صورت ممکن است لازم باشد با فایروال وب نرخ درخواستهایشان را محدود کنید.
عیبیابی robots.txt
پس از نوشتن robots.txt، میتوانید با این ابزارها بررسی کنید که نحو درست است یا بهطور تصادفی نشانی مهمی را مسدود نکردهاید.
۱. گزارش robots.txt در Google Search Console
پس از بهروزرسانی robots.txt باید بررسی کنید که خطایی ندارد یا بهطور تصادفی نشانیهایی را که میخواهید خزش شوند مسدود نکرده است، مثل منابع، تصاویر یا بخشهای وبسایت.
به Settings > robots.txt بروید تا گزارش robots.txt باز شود. این گزارش فایلهایی را که گوگل واکشی کرده و هر هشدار یا خطای تجزیه را نشان میدهد. پس از یک تغییر مهم میتوانید درخواست خزش دوباره بدهید. برای آزمایش اینکه آیا یک صفحهٔ مشخص مسدود است، از URL Inspection استفاده کنید.
ویدئوی زیر جریان کار این گزارش را نشان میدهد؛ جزئیات رابط کاربری ممکن است با نسخهٔ فعلی متفاوت باشد.
۲. پارسر robots.txt گوگل
Google’s robots.txt parser یک پارسر و تطبیقدهندهٔ متنباز است که بر پایهٔ پیادهسازی بهکاررفته در خزندهٔ گوگل ساخته شده است.
نصب و اجرای آن روی رایانهٔ محلی به مهارت پیشرفته نیاز دارد. اما توصیه میشود وقت بگذارید و آن را همانطور که در آن صفحه دستور داده شده انجام دهید، چون میتوانید تغییرات فایل robots.txt را پیش از بارگذاری روی سرور، مطابق پارسر رسمی گوگل اعتبارسنجی کنید.
مدیریت متمرکز robots.txt
قواعد robots.txt به میزبان، پروتکل و پورتی اعمال میشود که فایل از آن درخواست شده است. اگر به محدودیت خزش روی یک زیردامنه نیاز دارید، نشانی robots.txt آن زیردامنه باید قواعد را ارائه کند یا به فایلی تغییرمسیر دهد که این کار را میکند؛ فایل دامنهٔ والد به زیردامنه به ارث نمیرسد.
این موضوع وقتی وبسایتی با دهها زیردامنه دارید چالشساز میشود، چون یعنی باید چندین فایل robots.txt را جداگانه نگهداری کنید.
با این حال، میتوان فایل robots.txt را روی یک زیردامنه میزبانی کرد، مثل https://cdn.example.com/robots.txt، و از https://www.example.com/robots.txt به آن تغییرمسیر داد.
میتوانید برعکس عمل کنید و آن را فقط زیر دامنهٔ ریشه میزبانی کنید و از زیردامنهها به ریشه تغییرمسیر بدهید.
گوگل قواعد بازیابیشده را به میزبانی اعمال میکند که در ابتدا robots.txt را درخواست کرده است، نه بهطور خودکار به میزبانی که فایل مشترک را نگه میدارد. برای هر میزبانی که میخواهید مدیریت کنید تغییرمسیر تنظیم کنید و بررسی کنید که مسیرهای مشترک برای همهٔ آنها منطقی باشند.
این کار بهروزرسانی و نگهداری را کارآمدتر میکند. در غیر این صورت باید برای هر زیردامنه فایل robots.txt جداگانهای به کار ببرید.
robots.txt تنها بخشی از مدیریت خزش است
فایل robots.txt بهینهشده برای مدیریت بودجهٔ خزش (crawl budget) وبسایت حیاتی است. تضمین میکند که موتورهای جستوجویی مثل Googlebot وقت خود را صرف صفحههای ارزشمند کنند، نه هدر دادن منابع برای صفحههای غیرضروری.
مسدودکردن خزندههای پیرو قواعد میتواند درخواستهای ناخواسته را کاهش دهد. برای سیستمهای هوش مصنوعی، محدودیتهای خزش را از کنترلهای استفادهٔ آموزشی جدا کنید و اثر آن را در لاگها بررسی کنید. Google-Extended و Applebot-Extended خزندهٔ جداگانهای را متوقف نمیکنند.
مطمئن شوید همیشه تغییرات خود را اعتبارسنجی میکنید تا از مشکلات غیرمنتظرهٔ خزشپذیری جلوگیری شود.
اما به یاد داشته باشید که هم تقاضای خزش و هم ظرفیت سرویسدهی اهمیت دارند. محتوای مفید، بارگذاری کارآمد صفحه و سرور سالم در کنار قواعد robots.txt همچنان مهماند.
خزش خوشی داشته باشید!
منابع بیشتر:
پاسخ ۵۰۰ در واکشی robots.txt میتواند بر نتایج غنی اثر بگذارد
تلههای خزنده: علل، راهحلها و پیشگیری – بررسی عمیق یک توسعهدهنده
۸ مشکل رایج robots.txt و راه رفع آنها
۹ نکته برای بهینهسازی بودجهٔ خزش در سئو
۷ هشدار و خطای ابزار خزش سئو که میتوانید با خیال راحت نادیده بگیرید
 سارا نادری
 آرمان کریمی