مدلهای زبانی برای تولید توکنهای بعدی به بافت (context) خود تکیه میکنند. در یک مسیر طولانی، بافت از انواع گوناگونی از اجزا پر میشود: یک دستور سیستمی، نوبتهای گذشتهٔ گفتوگو، دستورهایی که روی اسناد بازیابیشده عمل میکنند، پاسخهای ابزار یا دادههای کاربر، الزاماتی که خروجی مجاز را محدود میکنند و زنجیرههای استدلال. بافت ساختاری غنی دارد که بیشتر آن یا برای مدل ضمنی است یا در قالبهایی مانند JSON کدگذاری شده که برای پردازش توسط مدلهای زبانی طراحی نشدهاند. این یکی از دلایل اصلی شکنندگی مدلهای زبانی، بهویژه مدلهای کوچکتر، و گاهی شکست آنها به شکلهای غیرمنتظره است. نبود ساختار صریح میتواند توسط مهاجمان نیز بهرهبرداری شود، مثلاً در قالب تزریق دستور.
برای رفع این مشکل، LLMON (LLM Object Notation، با تلفظ «lemon») را توسعه دادیم؛ یک زبان نشانهگذاری بومی مدلهای زبانی برای انتقال صریح ساختار و معنای اجزا به مدلها. اجزای معنایی منسجم با برچسبهای معنادار علامتگذاری میشوند که در جداکنندههای توکن ویژهٔ رزروشده پیچیده شدهاند. طرحوارههای داده، از جمله تودرتویی، به شکلی بیان میشوند که برای یک مدل زبانی علّی بدون ابهام باشد. شناسههای یکتا امکان میدهند به دستورهای مشخصی که ممکن است هر جای بافت قرار داشته باشند اشاره کرد و آنها را به بارهای دادهای که باید رویشان عمل کنند گره زد؛ مشابه روشی که در زبانهای برنامهنویسی توابع فراخوانی میشوند و آرگومانها به آنها پاس داده میشوند.
امروز دو مدل پیشنمایش آزمایشی منتشر میکنیم که از مدلهای پایهٔ Granite 4.1 مشتق شدهاند و برای مصرف و تولید متن علامتگذاریشده با LLMON آموزش دیدهاند: granite-4.1-3b-LLMON-preview و granite-4.1-8b-LLMON-preview. همچنین یک مخزن GitHub منتشر میکنیم که شامل مجموعهابزاری برای کار با LLMON و نمونههایی از جریانهای کاری و قالبهاست.
این زبان چه امکانی فراهم میکند:
تزریق دستور غیرمستقیم که در دادههای کاربر پنهان میشود، بهدلیل جداسازی صریح دستور و داده عمدتاً توسط مدلهای LLMON نادیده گرفته میشود. در برخی بنچمارکها، نرخ موفقیت حمله تقریباً به صفر میرسد، در حالی که مدلهای معمولی تنظیمشده با دستور با احتمال بالا ربوده میشوند. این نتیجه در حالی به دست آمده که توانایی عمومی نسبت به مدلهای Granite 4.1 Instruct حفظ شده است.
بندهای نامرتبط، نوبتهای قدیمی گفتوگو و خروجیهای ابزار وارد پاسخ نمیشوند، چون هر دستور به دادهٔ دقیقی که روی آن اعمال میشود گره خورده است.
دستورها، دادهها و الزامات بهروشنی علامتگذاری میشوند تا مدل بتواند از ساختار و معنای آنها در سطح کد برنامه بهره ببرد. آن را در Mellea امتحان کنید؛ این ابزار پشتیبانی بومی از LLMON دارد که با تبدیل خودکار فراخوانیهای مدل به LLMON فعال میشود.
دیگر لازم نیست نگران وادار کردن مدلهای زبانی به رعایت ساختار JSON باشید. با مبدلهای ما میتوانید JSON موجود را بدون از دست رفتن اطلاعات به LLMON تبدیل کنید. همچنین میتوانید ساختار و برچسبهای دلخواه خود را تعریف کنید و یک LoRA روی مدلهای LLMON تنظیم کنید تا آن را درک کند.
چرا JSON نه؟
JSON برای پارسرها طراحی شده، نه برای مدلهای زبانی علّی. توکنایزر مقید نیست که دستور زبان را رعایت کند و ساختار با توکنهایی ({، "، :) کدگذاری میشود که ممکن است در متن عادی هم ظاهر شوند. برای مدل، یک علامت نقلقول داخل سند و علامت نقلقولی که یک فیلد را میبندد، همان توکن هستند. قواعد فرار (escaping) که برای یک پارسر روشن است، برای مدل فقط الگوهای آماریاند. عمق تودرتویی با شمردن براکتها کدگذاری میشود و میدانیم که ترنسفورمرها در این کار ضعیفاند، بهویژه در بازههای طولانی.
در مقابل، LLMON یک نشانهگذاری شبیه XML است که جداکنندههای ساختاری آن بهجای کاراکتر، توکنهای ویژهٔ رزروشدهاند؛ بنابراین ساختار و محتوا از بخشهای جداگانهٔ واژگان استفاده میکنند. برچسبها در ابتدای هر بازه بیان میشوند و مرزهای میان بازهها صریح است. ساختارهای تودرتو بهصورت محلی بیان میشوند تا مدل لازم نباشد سلسلهمراتب را در بازههای طولانی دنبال کند.
از آنجا که بیشتر تیمها از قبل خطوط لولهای حول JSON ساختهاند، ابزارهای تبدیل و نوتبوکهای نمونهای ساختیم که JSON را بدون از دست رفتن اطلاعات به LLMON و برعکس ترجمه میکنند.
LLMON چه نسبتی با قالبهای چت دارد؟
LLMON جایگزین قالبهای چت نمیشود؛ بلکه آنها را غنیتر میکند. قالبهای چت معمولی به مدل میگویند هر بخش متعلق به کدام نقش است (سیستم، کاربر، دستیار)، اما LLMON به مدل میگوید هر جزء چه معنایی دارد و اجزا چگونه با هم مرتبطاند، چه درون یک نقش و چه میان نقشها.
مدلهای پیشنمایش LLMON قالب چت اختصاصی خود را دارند؛ بنابراین همان فهرست پیامهایی را میسازید که به هر مدل چت دیگری میدادید و طبق معمول apply_chat_template را فراخوانی میکنید؛ این تابع LLMON نشاندادهشده در زیر را رندر میکند. تنها تفاوت این است که یک نوبت اکنون میتواند اجزای خود را نامگذاری کند و هر یک را exec : True یا False علامت بزند. جزئی که True علامت خورده در بلوک اجرا در پایین خروجی رندرشده گره میخورد؛ این بلوک بیان میکند کدام دستور اجرا شود و روی چه چیزی عمل کند. جزئی که False علامت خورده همچنان در بافت رندر میشود اما هیچ چیزی به آن ارجاع نمیدهد.
messages = [ { "role": "user",
               "instruction": [{ "value": "Write a short paragraph about", "exec": True }],
               "data": [{ "value": "IBM Company", "exec": True }],
               "requirement": [ {"value": "Use less than 10 words", "exec": True},
                                {"value": "Do not use commas", "exec": True}]
             } ]
که مدل آن را به شکل زیر دریافت میکند (خطوط جدید و تورفتگی برای خوانایی اینجا اضافه شدهاند، چون قالب هیچکدام را تولید نمیکند):
<|open|>instr<|:|>Ȗ<|close|>Write a short paragraph about<|open_end|>
<|open|>data<|:|>ä¦<|close|>IBM Company<|open_end|>
<|open|>req<|:|>Á¼<|close|>Use less than 10 words<|open_end|>
<|open|>req<|:|>¢¬<|close|>Do not use commas<|open_end|>
<|open|>exec<|:|>ÄÐ<|close|>
    <|open|>exec<|.|>instruction<|close|>instr<|:|>Ȗ<|open_end|>
    <|open|>exec<|.|>input<|close|>data<|:|>ä¦<|open_end|>
    <|open|>exec<|.|>requirement<|close|>req<|:|>Á¼<|open_end|>
    <|open|>exec<|.|>requirement<|close|>req<|:|>¢¬<|open_end|>
    <|open|>exec<|.|>output<|close|>assistant<|:|>ãø<|open_end|>
<|open_end|>
<|open|>assistant<|:|>ãø<|close|>شناسههای دوحرفی بلوک از مجموعهای ثابت انتخاب میشوند که این توکنایزر آنها را بهصورت توکنهای تکتایی کدگذاری میکند؛ بنابراین آدرسدهی به یک بلوک همیشه دو توکن هزینه دارد، صرفنظر از اینکه کدام شناسه انتخاب شود.
نقش همچنان یک نوبت کاربر است، اما اجزای آن بهصورت پنج بلوک جداگانهٔ آدرسپذیر به مدل میرسند که بلوک ششم (بلوک اجرا) آنها را به هم گره میزند و بیان میکند: این دستور را اجرا کن، روی این داده، با رعایت این دو الزام، و پاسخ را در بلوکی که اینجا نام برده شده بگذار، که همان بلوک دستیار است و مدل سپس آن را پر میکند. یک قالب متعارف همهٔ اجزا را در یک رشته تخت میکرد و تشخیص اینکه کدام بخش وظیفه، کدام موضوع و کدام محدودیت بوده را به مدل واگذار میکرد.
LLMON چگونه به حملات تزریق دستور پاسخ میدهد
تزریق دستور غیرمستقیم نوعی حمله است که در آن دستور مخرب در یک بار داده پنهان میشود، مانند سند بازیابیشده، پاسخ ابزار یا دادهای که کاربر ارائه کرده است. این همان مشکلی است که جداسازی دستور و داده در LLMON برای رفع آن طراحی شده است.
مدلهای پیشنمایش LLMON را با چند مدل متنباز و بسته مقایسه کردیم. ارزیابی روی بنچمارک OPI انجام شد که تزریق را در دادهٔ وظایف کلاسیک NLP قرار میدهد. چند راهبرد حمله به کار گرفته میشود. ما مقاومت را گزارش میکنیم که برابر است با ۱ منهای نرخ موفقیت حمله: سهم حملاتی که مدل دستور تزریقشده را اجرا نمیکند.
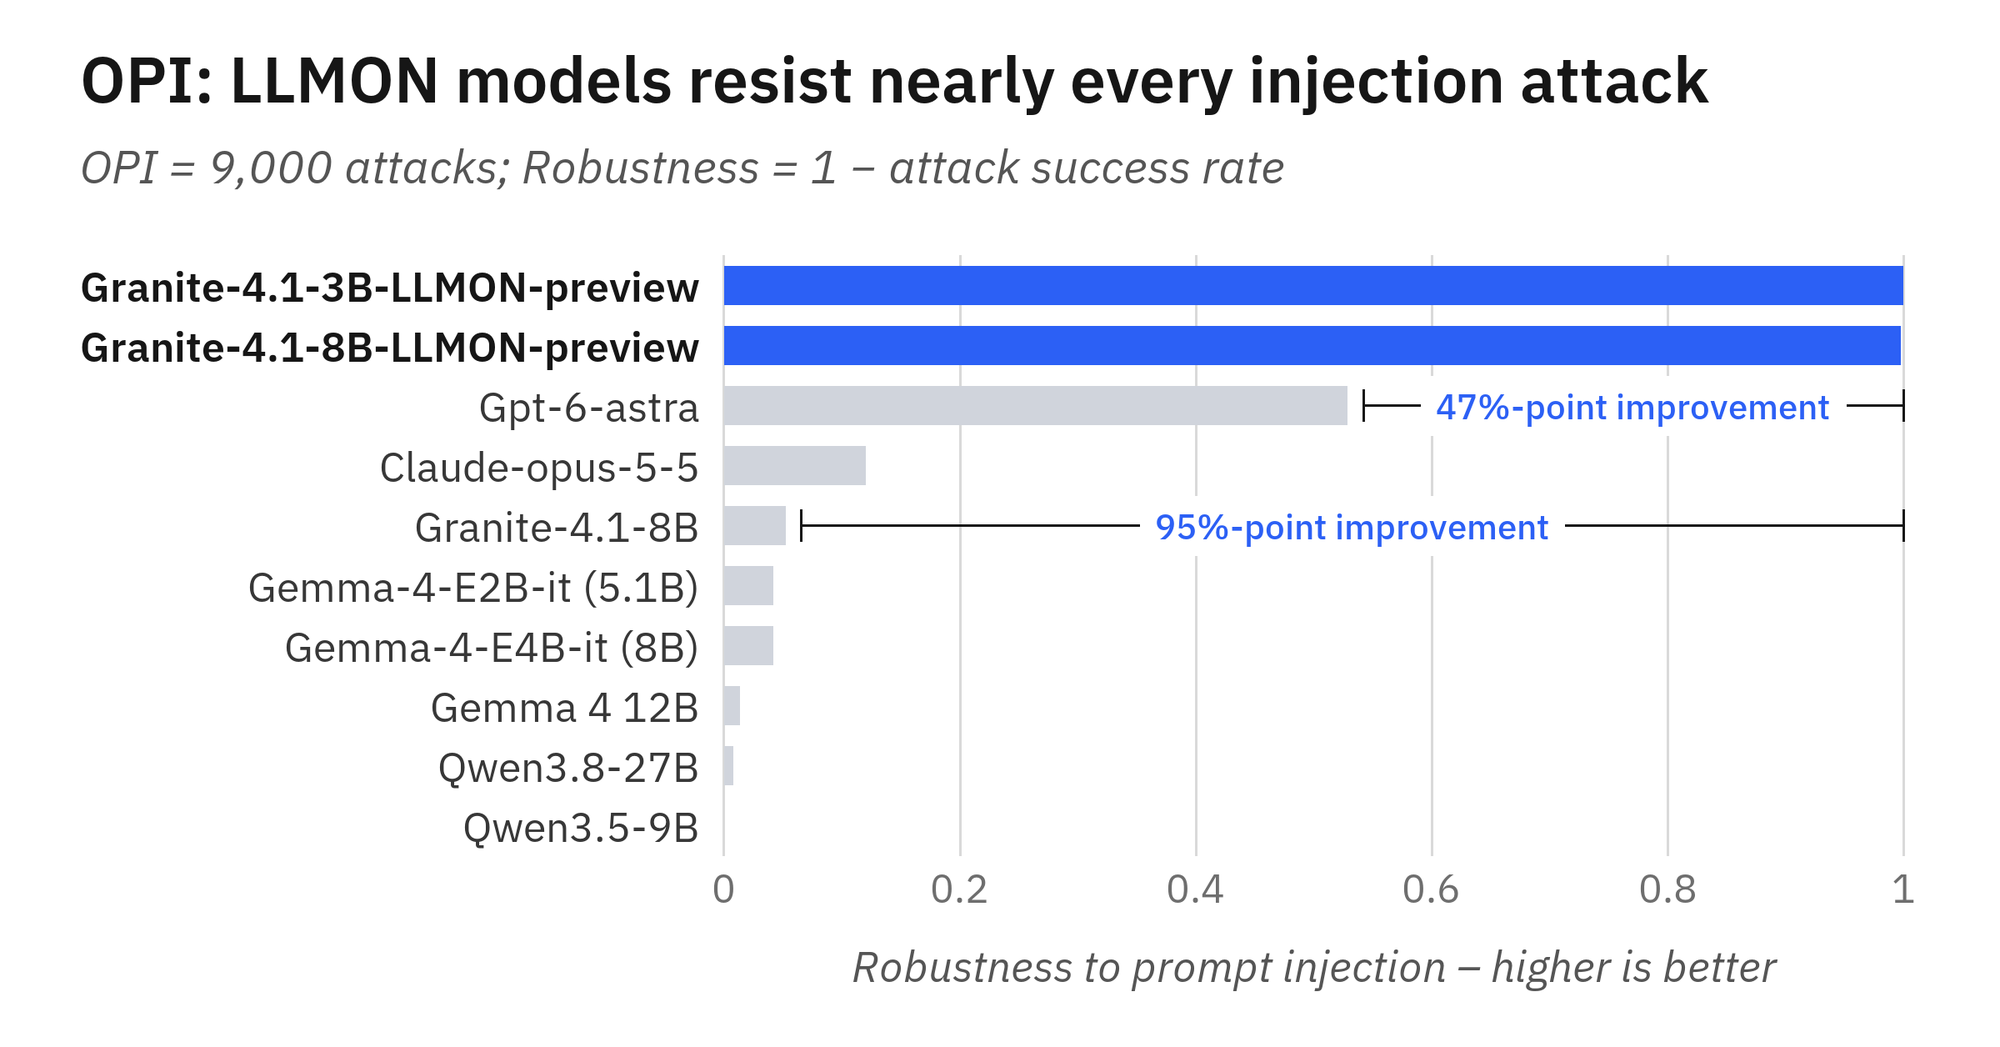
همهٔ مدلهای غیر LLMON بهشدت آسیبپذیرند و دستورهای تزریقشده را با احتمال بالا اجرا میکنند. LLMON این مشکل را در این بنچمارک عملاً از بین میبرد و نسبت به بهترین مدل مرزی که آزمودیم ۴۷٪ حملات بیشتری را دفع میکند و نسبت به بهترین مدل متنباز ۹۵٪ بیشتر. روند مشابهی در بنچمارکهای دیگر (ASB و StruQ) مشاهده میکنیم. شایان ذکر است که این بنچمارکها مقاومت در برابر تزریق دستور غیرمستقیم ایستا را میسنجند. جداسازی دستور و داده مستقیماً به این نوع حمله پاسخ میدهد. ما فعالانه روی بهبود مقاومت در برابر حملات تطبیقی که طی چند نوبت گفتوگو رخ میدهند نیز کار میکنیم.
توانایی عمومی
دستاوردهای ایمنی به قیمت توانایی عمومی تمام نشده است. در دستههای استاندارد بنچمارک، مدلهای LLMON همسطح مدلهای Granite 4.1 Instruct عمل میکنند.
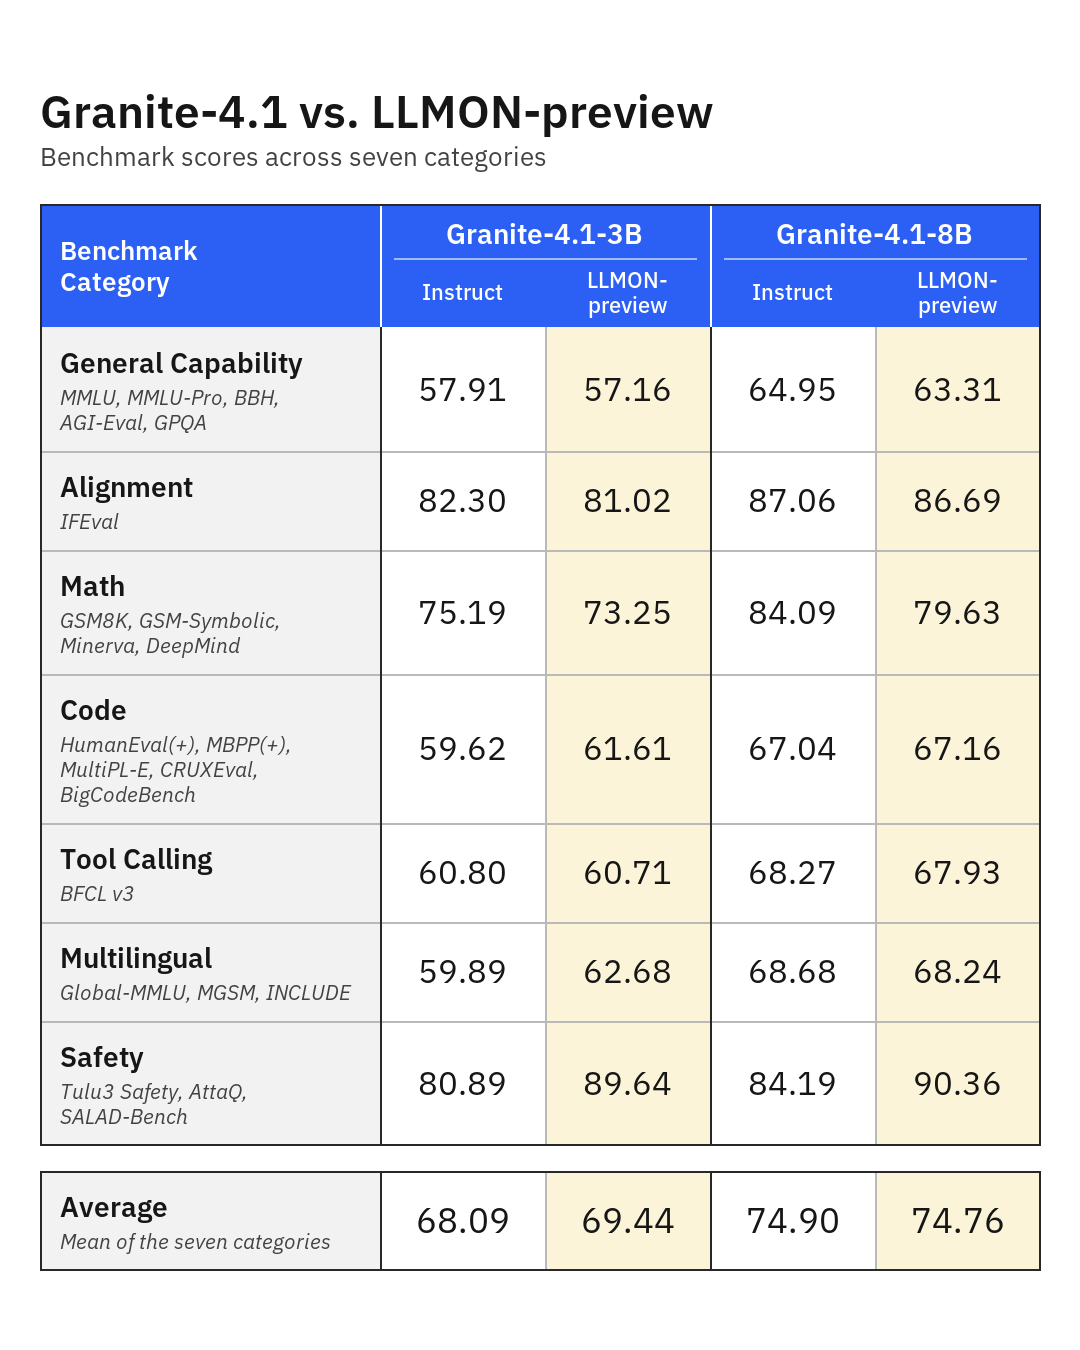
خلاصه اینکه اگر امروز با Granite 4.1 3B یا 8B آزمایش میکنید، میتوانید مدل پیشنمایش LLMON را جایگزین کنید و باید عملکرد عمومی قابلمقایسه با مقاومت بسیار بیشتر در برابر تزریق دستور ببینید. نیازی به خط لولهٔ تبدیل نیست. نامگذاری اجزای نوبت (مثلاً دستور، داده، الزام مانند مثال بالا) کافی است. قالب چت ارائهشده آنها را برای شما به بلوکهای LLMON تبدیل میکند. کتابخانهٔ LLMON-converters ما یک سطح عمیقتر میرود: اگر خود یک جزء ساختاریافته باشد، مانند یک سند JSON، تبدیل آن به LLMON آن ساختار را بهصورت بلوکهای نوعدار و جداگانه آدرسپذیر حفظ میکند، نه یک رشتهٔ مبهم واحد.
مدلها را چگونه آموزش دادیم
مدلها از چکپوینتهای پایهٔ Granite 4.1 شروع میکنند، نه از مدلهای instruct منتشرشده؛ بنابراین رفتار LLMON در مرحلهٔ پسآموزش یاد گرفته میشود، نه اینکه روی یک قالب چت موجود لایهگذاری شود.
LLMON شش جداکننده تعریف میکند که شروع و پایان برچسبها را علامت میزنند و تودرتویی و لنگرگذاری را ممکن میکنند؛ این جداکنندهها بهصورت توکنهای تکتایی رزروشده در توکنایزر نصب میشوند. ما یک پیکرهٔ متعارف تنظیم دقیق با دستور را به LLMON بازسریالسازی کردیم: هر جزء پرامپت به بلوک جداگانهٔ آدرسپذیر خودش تبدیل میشود و هر نوبت یک بلوک اجرا دارد که نام میبرد کدام دستور اجرا شود، روی کدام ورودیها عمل کند و خروجی کجا برود. ترکیب وظایف همان چیزی است که یک مدل instruct معمولی میبیند (چت، چندنوبتی، RAG، فراخوانی ابزار)، و به همین دلیل عملکرد بنچمارک نزدیک به مدل تنظیمشده به روش متعارف میماند. علاوه بر این، داده را با دستورهای طعمه و بلوکهای دادهای که در بافت حاضرند اما عمداً بدون اتصال رها شدهاند غنی میکنیم، در حالی که خروجی هدف بدون تغییر میماند. بنابراین مدل یاد میگیرد از وابستگیهایی که بلوک اجرا دیکته میکند پیروی کند و بقیه را نادیده بگیرد. سپس یادگیری تقویتی میآید: پنج مرحلهٔ متوالی GRPO شامل استدلال چنددامنهای، RLHF، کالیبراسیون دانش و ریاضیات، و پس از آن یک مرحلهٔ نهایی DPO روی هزار جفت ترجیح برخط که از پاسخهای خود مدل به تلاشهای تزریق ساخته شدهاند.
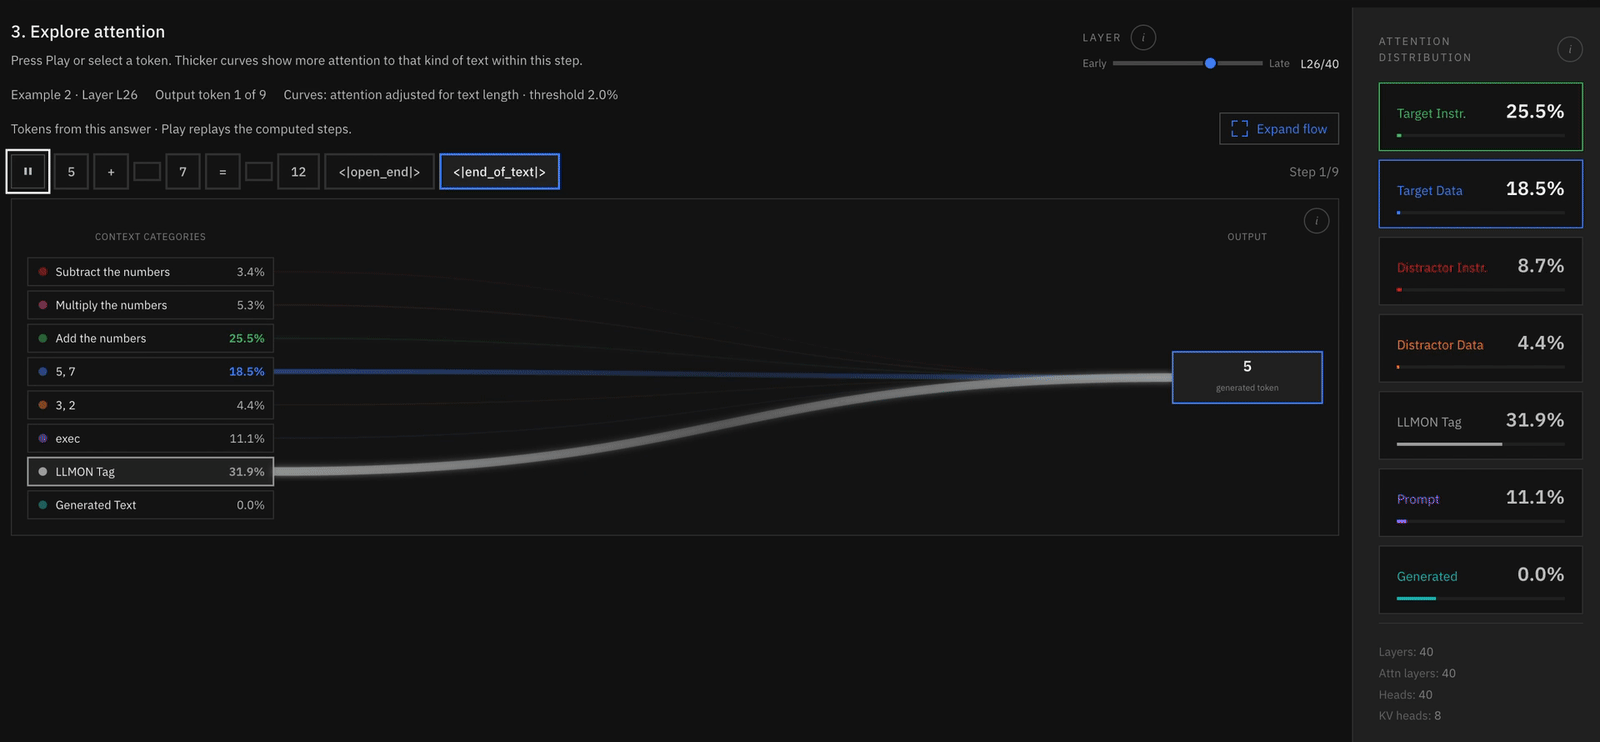
قاعدهٔ امتیاز دسترسی (privilege rule) حاصل از این چیدمان است، نه یک محافظ افزوده: دستوری که از طریق یک بلوک اجرا به آن میرسیم معتبر است، در حالی که هر چیزی که بهعنوان ورودی (داده، اسناد، طرحوارههای ابزار، نتایج ابزار) به آن میرسیم موادی برای خواندن است، نه دستوری برای پیروی. علاوه بر این، بازههای دستور و دادهای که در بلوک اجرا فراخوانده نشدهاند نادیده گرفته میشوند. این یک رفتار آموختهشده است، نه یک تضمین اجراشده. برای دیدن اینکه این موضوع در لایههای توجه یک مدل LLMON چگونه نمود مییابد، LLMON Attention Visualization را در Hugging Face Spaces امتحان کنید.
واژگان دلخواه خود را بیاورید (ScienceWorld)
LLMON به یک طرحوارهٔ ثابت گره نخورده است: میتوانید نام برچسبها و ساختاری را انتخاب کنید که به حوزهٔ شما میخورد و یک آداپتر را برای خواندن و نوشتن آنها تنظیم دقیق کنید. این را روی ScienceWorld نشان میدهیم؛ یک بنچمارک متنی که در آن یک عامل وظایف علمی ساده (مانند جوشاندن آب) را با صدور یک دستور در هر مرحله انجام میدهد و از شبیهساز امتیاز میگیرد. ما واژگانی تعریف کردیم که ساختار موجود در مسیرهای برنامهریزی برای حل این وظایف را ثبت میکند. این واژگان شامل برچسبهایی مانند instr.task.goal، req.planning_policy.rule، data.state.room، data.state.inventory و assistant.next_action است. ما هر مرحله از راهحلهای مرجع ScienceWorld را با این برچسبها رندر کردیم و یک LoRA روی یک مدل LLMON تنظیم کردیم. مدل آموزشدیده سپس بازیهای کنارگذاشتهشده را انجام میدهد و اقدام بعدی خود را در واژگان جدید مینویسد. این نوتبوک کل جریان کاری را طی میکند، از تبدیل مسیرهای مرجع تا انجام بازیهای آزمون و امتیازدهی آداپتر در برابر مدل پایهٔ آموزشندیده. نمونهٔ دیگری برای عاملهای فراخوانی ابزار در این نوتبوک موجود است.
همین امروز امتحان کنید
این یک پیشنمایش آزمایشی است، آماده برای کاوش و ارزیابی اما نه برای تولید.
مدلها: granite-4.1-3b-LLMON-preview و granite-4.1-8b-LLMON-preview
دموی بصریسازی: LLMON Attention Visualization
مخزن LLMON: https://github.com/generative-computing/llmon
Mellea: https://github.com/generative-computing/mellea
مقالات: https://arxiv.org/abs/2610.38120، https://arxiv.org/abs/2603.22519
به ما بگویید چه یافتید: چه چیزی کار کرد، چه چیزی خراب شد و چه موارد استفادهای را دوست دارید ببینید. آن را در GitHub Discussions منتشر کنید.